PCD/assets/pcd15_contoh_kasus/ATTRIBUTIONS.md.
Pengolahan Citra Digital (PCD), pertemuan ke-15
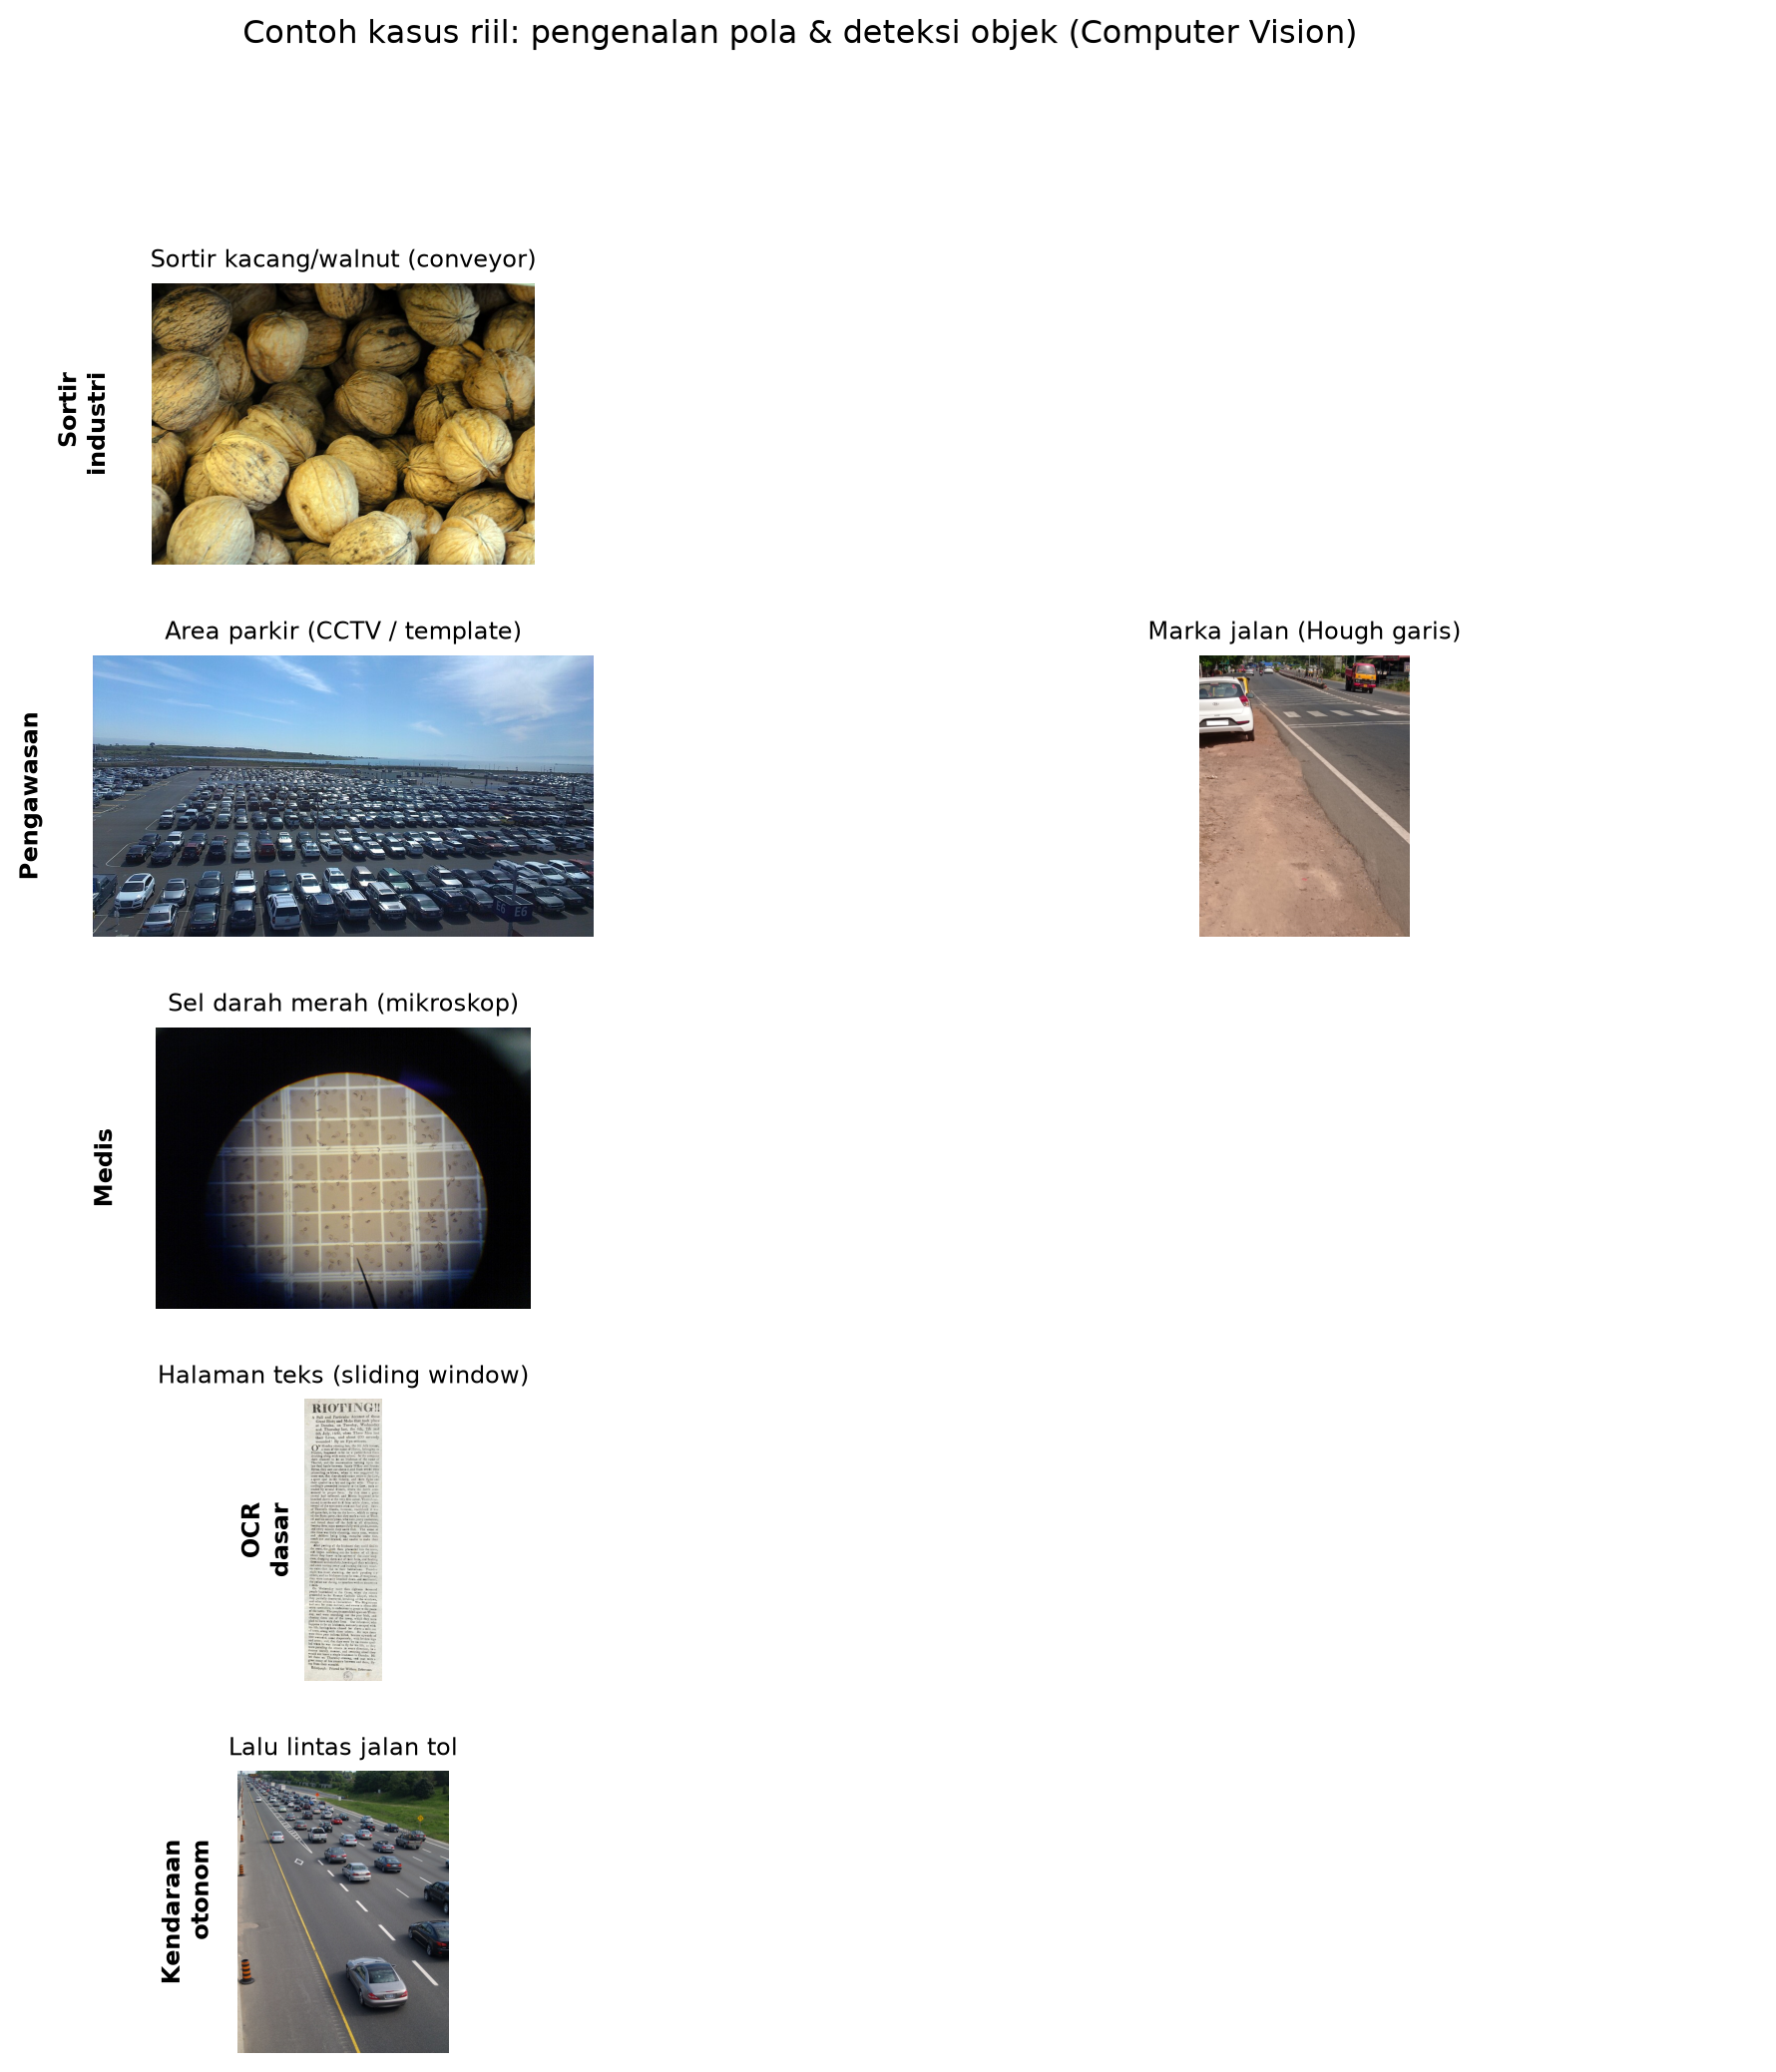
Modul ini menutup rangkaian analisis citra → keputusan: setelah ekstraksi ciri (PCD 14) menghasilkan vektor fitur \(\mathbf{x}\), kita memakai pengenalan pola (pattern recognition) untuk mengklasifikasi objek, dan mempelajari deteksi objek — menemukan di mana objek berada di citra, bukan hanya apa kelasnya. Keduanya adalah inti Computer Vision (CV): sistem yang menginterpretasi citra untuk aplikasi industri, medis, transportasi, dan robotika.
Contoh penggunaan:
PCD/assets/pcd15_contoh_kasus/ATTRIBUTIONS.md.
Alur modul: definisi CV & tiga tingkat tugas → pengenalan pola (kNN, evaluasi) → deteksi klasik (template, sliding window) → transformasi Hough → outlook deep learning → capstone pipeline PCD 09–15.
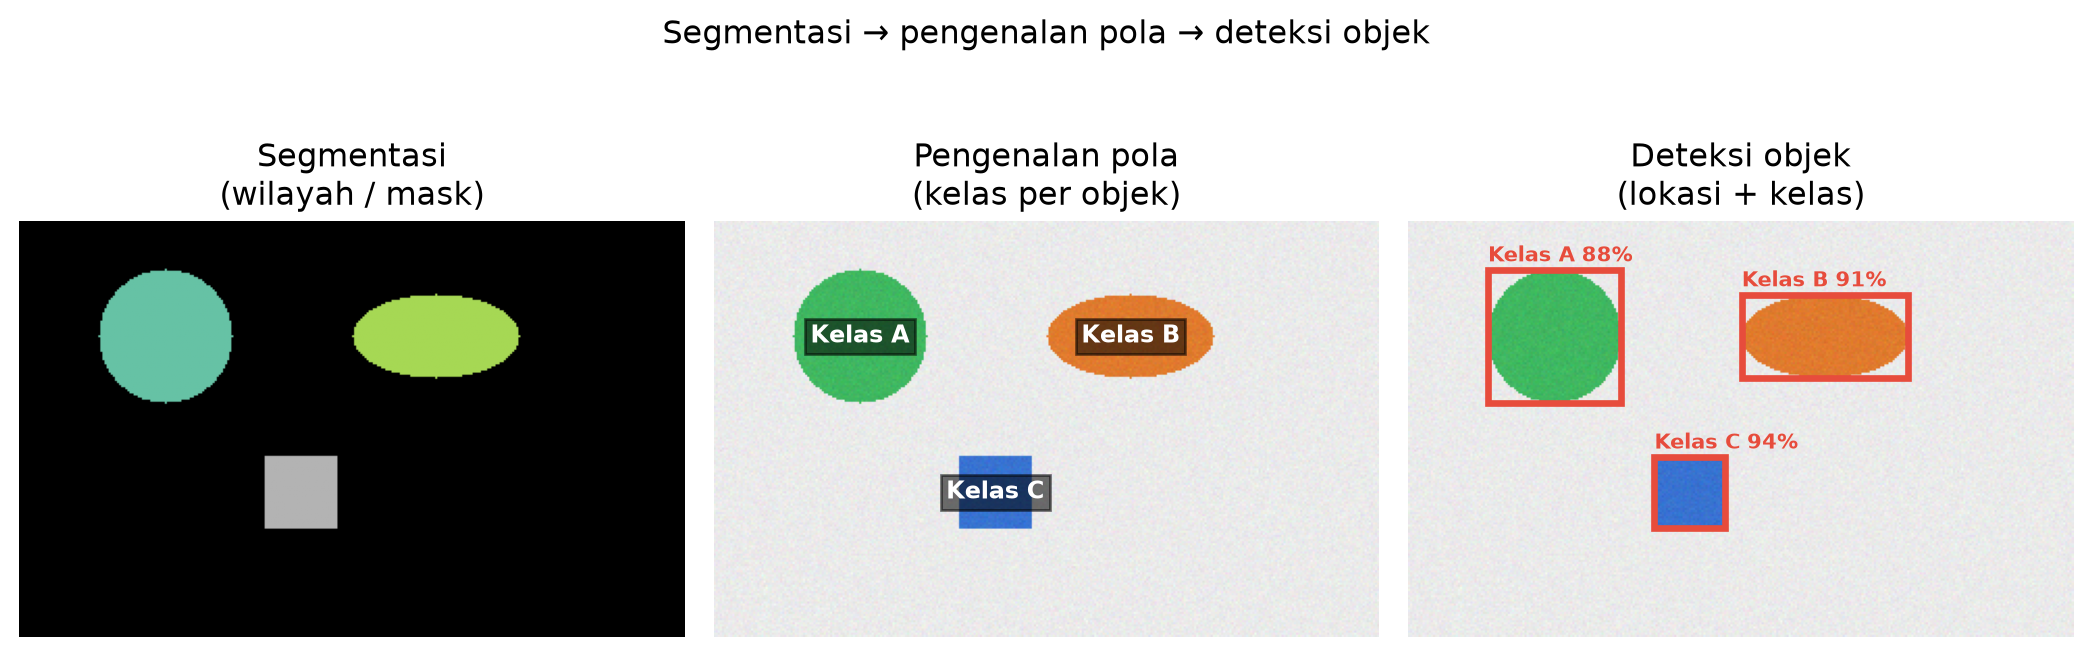
Computer Vision adalah bidang yang membangun sistem agar komputer menginterpretasi citra atau video: mengenali objek, memperkirakan pose, memantau adegan, atau memandu robot. Pengolahan citra digital (PCD) sering menjadi pra-proses — peningkatan kualitas, segmentasi, ekstraksi tepi/fitur — sebelum keputusan tingkat tinggi.
| Tingkat tugas | Pertanyaan utama | Output tipikal | Modul PCD terkait |
|---|---|---|---|
| Segmentasi | Piksel/region mana yang termasuk objek? | mask biner, label per piksel | PCD 12–13 |
| Pengenalan pola | Objek/region ini kelas apa? | label kelas per sampel | PCD 14 + modul ini |
| Deteksi objek | Objek kelas X ada di mana? | kotak batas (bounding box), skor | modul ini |
Klasifikasi citra penuh (satu kelas per citra, mis. “kucing” vs “anjing”) adalah kasus pengenalan pola tanpa lokasi. Deteksi menambah lokalisasi: setiap objek dilaporkan sebagai \((x, y, w, h, \text{kelas}, \text{skor})\).
flowchart TD
  A[Citra / video] --> B[Pra-proses PCD]
  B --> C{Jenis tugas}
  C -->|Wilayah| D[Segmentasi]
  C -->|Kelas per ROI| E[Pengenalan pola]
  C -->|Lokasi + kelas| F[Deteksi objek]
  D --> G[Mask / label]
  G --> H[Ekstraksi ciri PCD 14]
  H --> E
  F --> I[Template / sliding window / Hough / DL]
  E --> J[Keputusan aplikasi]
  I --> J
Rangkaian modul yang sudah dipelajari membentuk baseline industri yang masih dipakai bila data sedikit, aturan jelas, atau interpretabilitas penting:
flowchart LR
  subgraph prep ["Pra-analisis"]
    P1["Tepi PCD 10-11"]
    P2["Segmentasi PCD 12-13"]
    P3["Morfologi PCD 09"]
  end
  subgraph feat ["Fitur"]
    F1["Bentuk, warna, tekstur PCD 14"]
  end
  subgraph dec ["Keputusan modul ini"]
    D1["kNN / SVM / aturan"]
    D2["Template / Hough"]
  end
  P2 --> P3 --> F1 --> D1
  P1 --> D2
| Tahap | Input | Output | Contoh |
|---|---|---|---|
| Threshold Otsu | citra grayscale | mask kasar | PCD 12 |
| Opening/closing | mask biner | noise hilang | PCD 09 |
| Labeling | mask bersih | ID per objek | PCD 11 |
| Ekstraksi ciri | ROI per label | vektor \(\mathbf{x}\) | PCD 14 |
| Klasifikasi | \(\mathbf{x}\) | kelas | bab berikut |
| Deteksi | citra penuh | lokasi objek | bab deteksi |
Pengenalan pola memetakan representasi masukan \(\mathbf{x} \in \mathbb{R}^d\) ke kelas \(y \in \{1,\ldots,C\}\). Pada pipeline PCD, \(\mathbf{x}\) biasanya vektor ciri handcrafted dari PCD 14; klasifikator dapat berupa kNN, pohon keputusan, SVM, atau jaringan saraf.
Diberikan dataset latih \(\{(\mathbf{x}_i, y_i)\}_{i=1}^N\). Tujuan: pelajari fungsi \(f(\mathbf{x})\) yang memprediksi \(y\) pada data baru. Overfitting terjadi bila \(f\) menghafal latih tetapi gagal uji — mitigasi: train/test split, validasi silang (cross-validation), regularisasi, atau lebih banyak data.
Train/test split umum: 70–80% latih, 20–30% uji; normalisasi (z-score dari statistik hanya train) diterapkan sebelum jarak/similaritas — sama seperti di PCD 14.
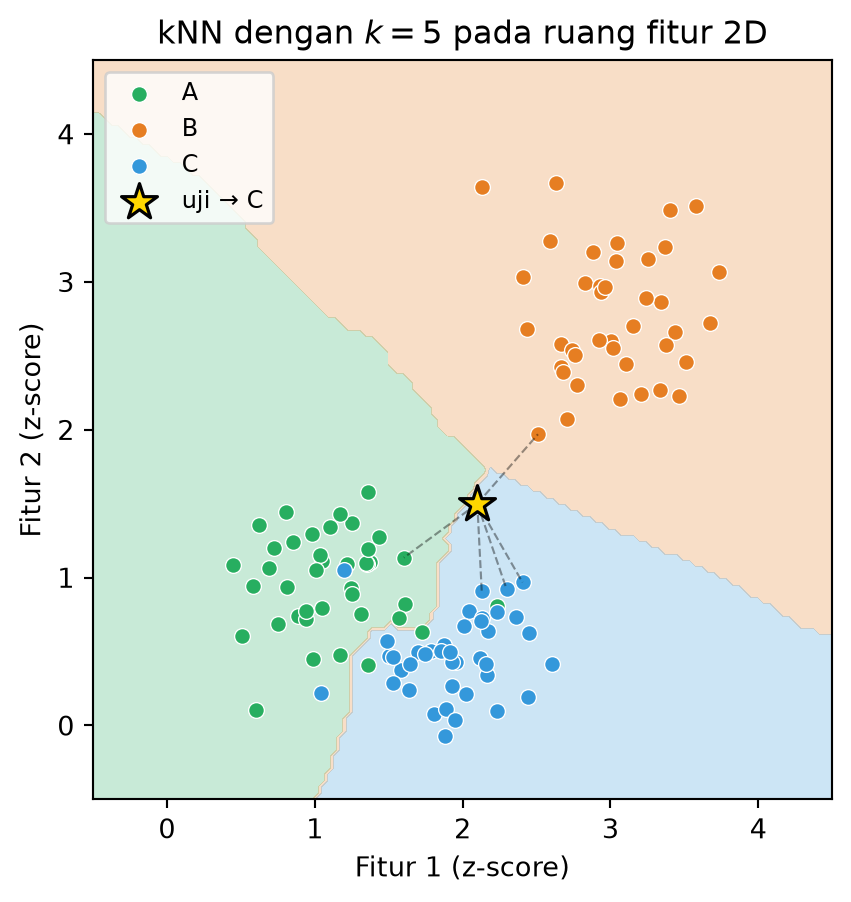
kNN adalah klasifikator non-parametrik: tidak melatih bobot eksplisit; pada prediksi, cari \(k\) sampel latih terdekat dalam ruang fitur.
\[\hat{y}(\mathbf{x}) = \arg\max_{c} \sum_{i \in \mathcal{N}_k(\mathbf{x})} \mathbb{1}[y_i = c]\]
\(\mathcal{N}_k(\mathbf{x})\): indeks \(k\) tetangga dengan jarak Euclidean \(\|\mathbf{x} - \mathbf{x}_i\|\) terkecil. \(k\) ganjil menghindari seri pada klasifikasi biner. \(k\) kecil → sensitif noise; \(k\) besar → batas keputusan lebih halus tetapi bisa underfit.
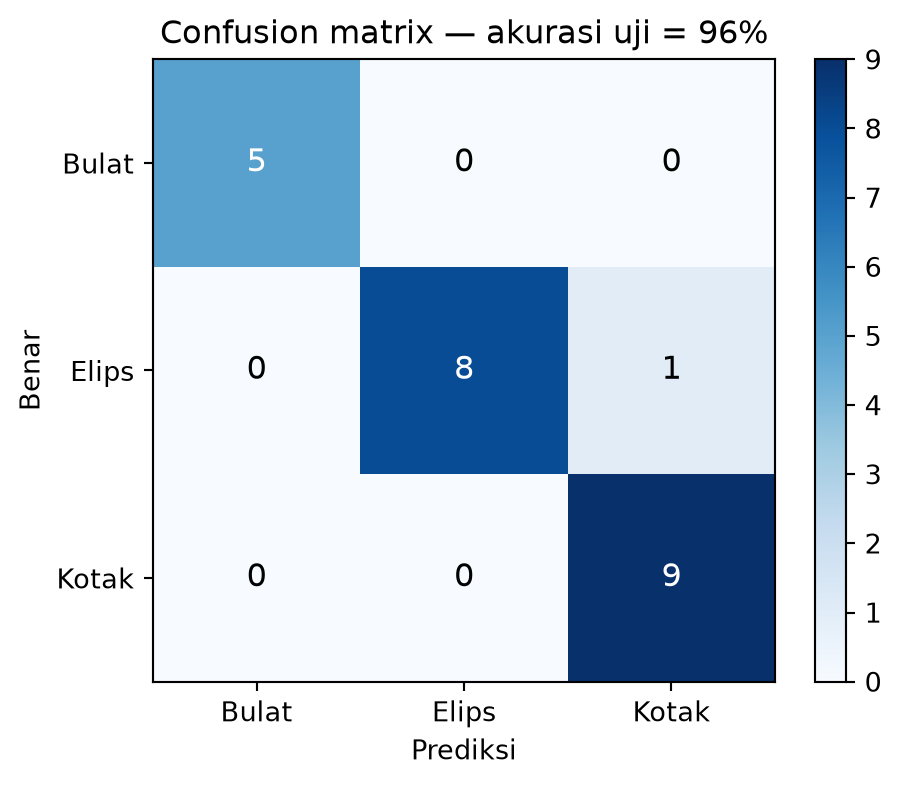
Untuk \(C\) kelas, confusion matrix \(\mathbf{M}\) berukuran \(C \times C\): \(M_{ij}\) = jumlah sampel benar kelas \(i\) diprediksi kelas \(j\).
| Pred 0 | Pred 1 | |
|---|---|---|
| Benar 0 | TN | FP |
| Benar 1 | FN | TP |
Deteksi mencari instance objek di citra: setiap deteksi = lokasi (kotak, mask, atau parameter geometri) + label + skor kepercayaan.
Template matching mencari sub-citra \(t\) yang paling mirip dengan pola referensi di citra \(f\). Metrik umum: korelasi silang ter-normalisasi (normalized cross-correlation, NCC):
\[\gamma(u,v) = \frac{\sum_{x,y} [f(x+u,y+v) - \bar{f}_{u,v}][t(x,y) - \bar{t}]}{\sqrt{\sum_{x,y}[f(x+u,y+v)-\bar{f}_{u,v}]^2 \sum_{x,y}[t(x,y)-\bar{t}]^2}}\]
Puncak \(\gamma\) → kandidat lokasi objek. Kelebihan: sederhana, cepat untuk pola kecil. Kekurangan: sensitif terhadap skala, rotasi, perubahan pencahayaan, dan oklusi sebagian.
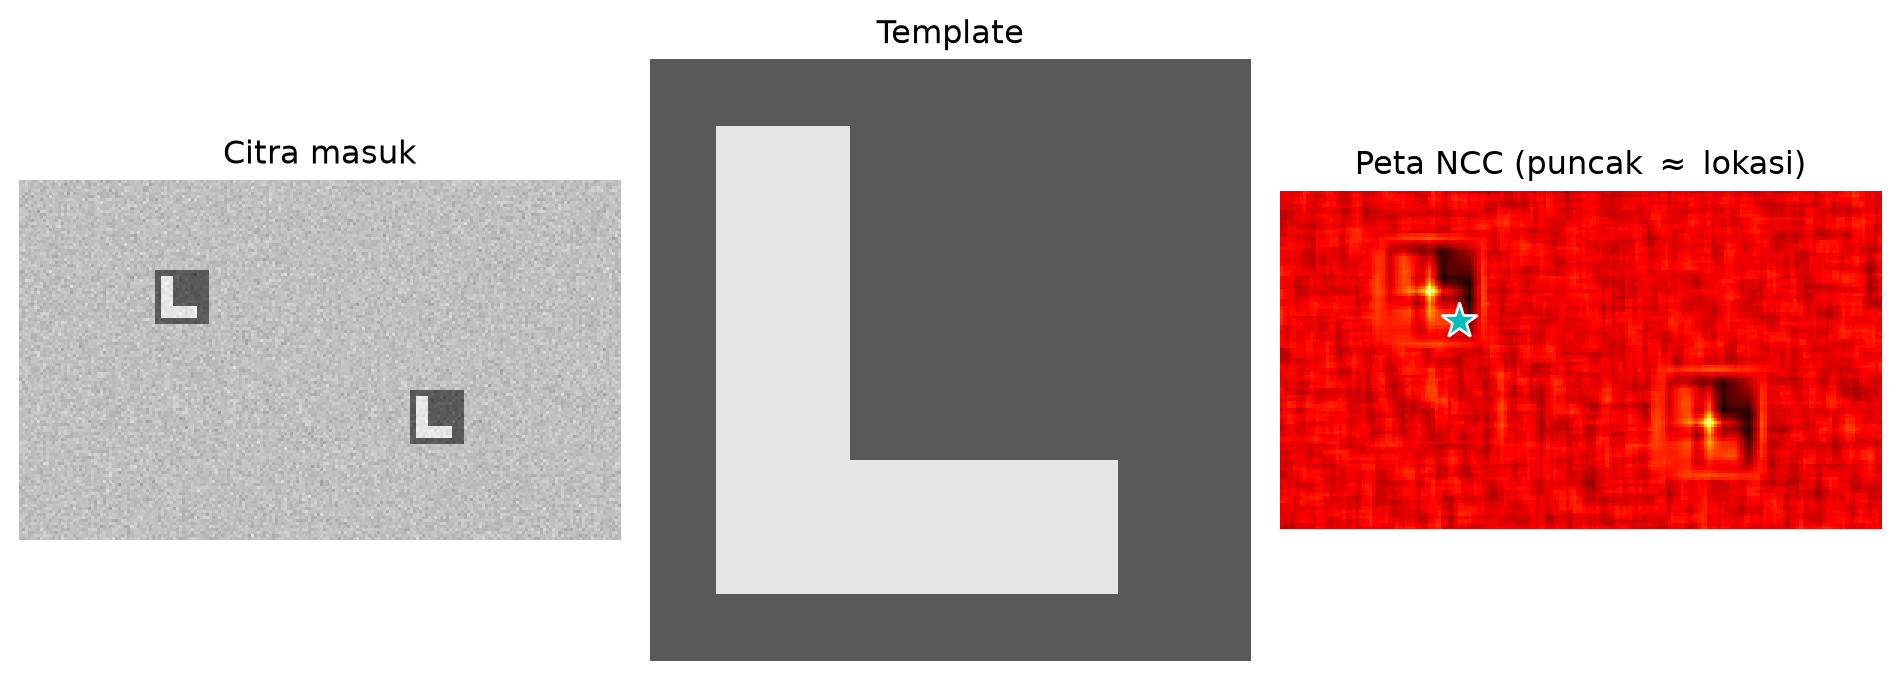
Untuk objek yang variasi ukurannya atau tidak cocok satu template, citra di-scan dengan jendela bergeser berbagai ukuran (sering digabung image pyramid):
Kompleksitas: \(O(\text{piksel} \times \text{jumlah skala} \times \text{biaya klasifikator})\) — mahal pada citra besar; ini sebagian alasan deep learning memakai region proposal atau deteksi satu tahap (YOLO).
| Metode | Input | Kekuatan | Kelemahan |
|---|---|---|---|
| Template matching | pola tetap | sangat cepat, mudah | skala/rotasi |
| Sliding window + klasifikator | fitur per patch | fleksibel | lambat, butuh fitur baik |
| Hough | peta tepi | struktur parametrik (garis, lingkaran) | clutter, parameter |
| CNN / YOLO | citra mentah | akurasi tinggi | data & GPU |
Hough transform mendeteksi bentuk parametrik dengan voting di ruang parameter — bukan mencari korelasi template pixel-per-pixel. Titik tepi dari deteksi tepi (PCD 10–11) “memilih” parameter bentuk yang konsisten.
Garis dalam koordinat gambar memenuhi \(\rho = x\cos\theta + y\sin\theta\) dengan \(\rho\) jarak tegak lurus dari origin, \(\theta \in [0, \pi)\). Setiap titik tepi \((x,y)\) memberi kurva sinus di ruang \((\rho, \theta)\); titik perpotongan banyak kurva → akumulator puncak = garis dominan.
Lingkaran: pusat \((a,b)\), jari-jari \(r\). Setiap titik tepi memberi vote untuk kemungkinan \((a,b)\) pada berbagai \(r\) (atau \(r\) diketahui → vote 2D lebih murah).
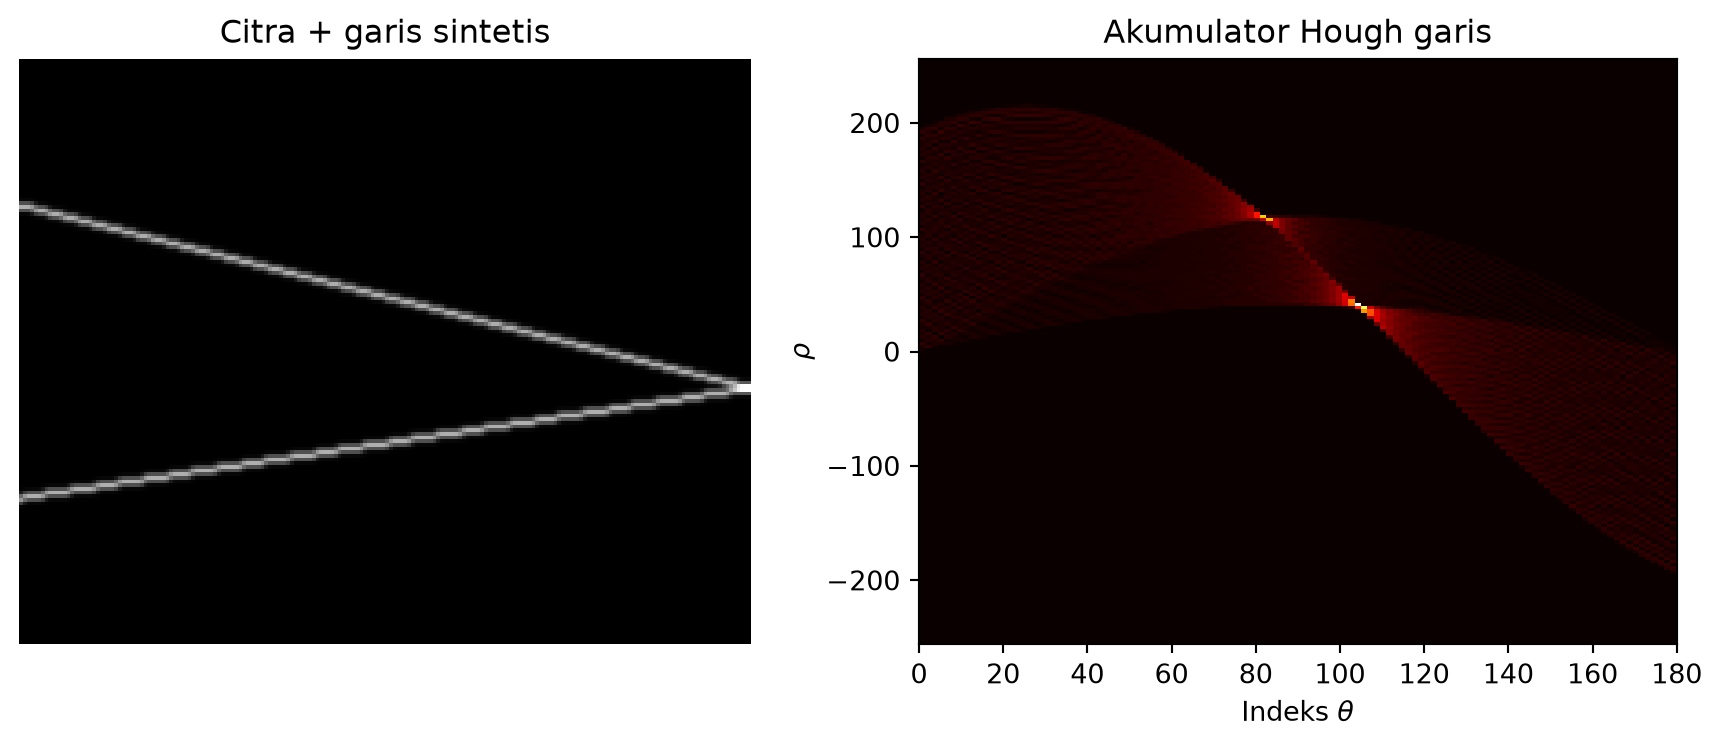
Praktik: OpenCV cv2.HoughLines, cv2.HoughCircles; scikit-image transform.hough_line, hough_circle. Pra-syarat: tepi bersih (Canny membantu mengurangi noise akumulator).
Klasifikasi per ROI memakai confusion matrix; deteksi membutuhkan metrik yang mempertimbangkan overlap kotak:
Pipeline klasik jarang mencapai mAP tinggi pada adegan kompleks; deep learning mendominasi benchmark modern.
Convolutional Neural Network (CNN) mempelajari representasi hierarkis langsung dari piksel. Untuk klasifikasi, CNN menggantikan vektor Hu+GLCM manual pada banyak dataset besar — tetapi butuh banyak data berlabel dan GPU untuk pelatihan praktis.
Deteksi objek modern (gambaran konsep, tanpa implementasi di modul ini):
| Keluarga | Ide utama | Contoh |
|---|---|---|
| Two-stage | proposal region → klasifikasi per region | R-CNN, Faster R-CNN |
| One-stage | grid langsung prediksi kotak + kelas | YOLO, SSD, RetinaNet |
| Transformer | attention global pada patch | DETR |
flowchart LR
  subgraph classic ["Pipeline klasik PCD"]
    C1[Segmentasi] --> C2[Fitur handcrafted]
    C2 --> C3[kNN / SVM]
  end
  subgraph dl ["Deep learning"]
    D1[CNN backbone] --> D2[Head klasifikasi / deteksi]
  end
  classic --> H[Baseline / data sedikit / explainability]
  dl --> I[Variasi kompleks / data banyak]
Kapan tetap pakai klasik? Data sedikit, aturan domain jelas (sortir ukuran), hardware terbatas, atau audit/regulasi mensyaratkan fitur interpretable. Hybrid (CNN embedding + fitur geometri) umum di industri.
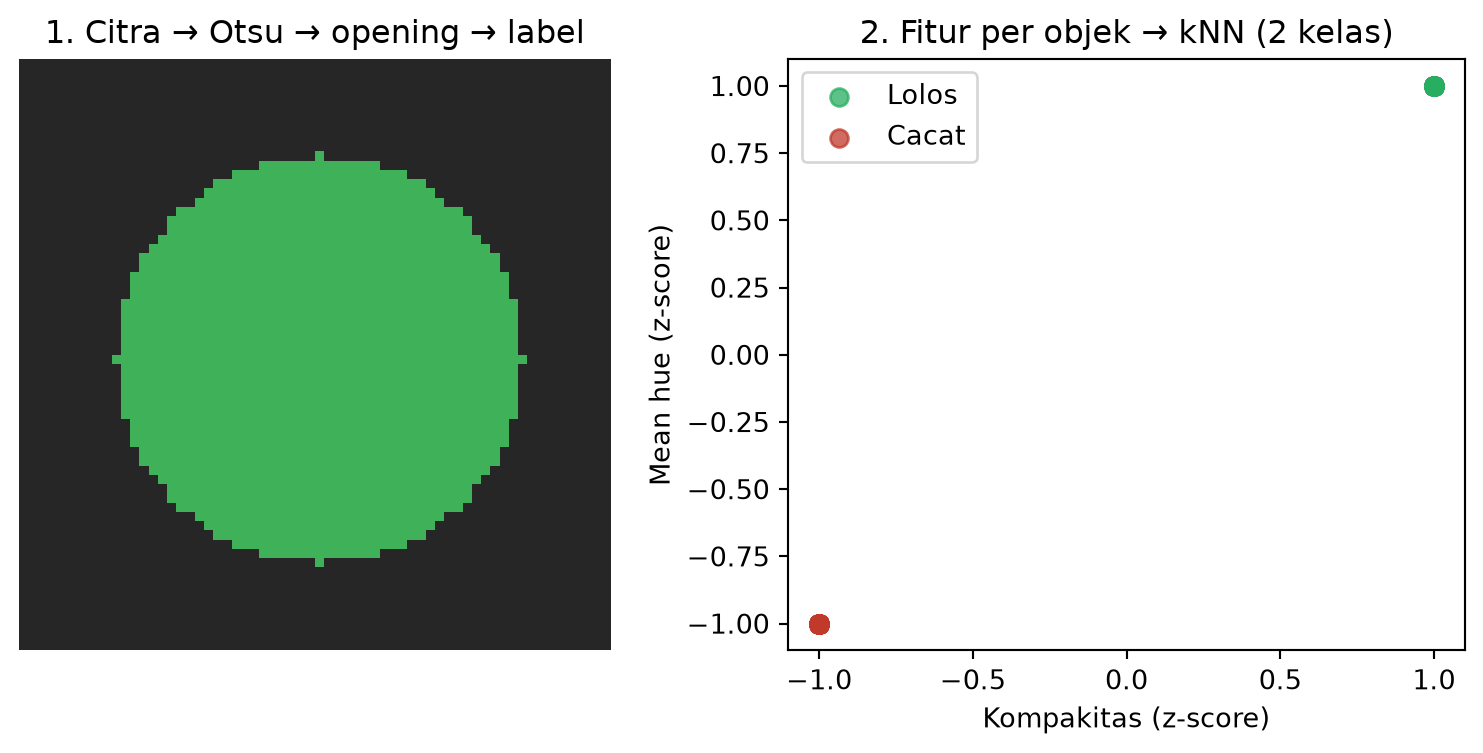
Studi kasus menyatukan modul PCD 09, 12, 11, 14, dan klasifikasi di modul ini:
flowchart TB
  subgraph edge ["Tepi & struktur PCD 10-11"]
    E1[Canny / Sobel]
    E2[Hough garis/lingkaran]
  end
  subgraph seg ["Segmentasi & morfologi PCD 09, 12-13"]
    S1[Threshold / warna]
    S2[Opening / closing]
    S3[Label komponen]
  end
  subgraph ml ["Keputusan PCD 14-15"]
    M1[Vektor ciri]
    M2[kNN / metrik]
    M3[Template / sliding window]
  end
  A[Citra masuk] --> S1 --> S2 --> S3 --> M1 --> M2
  A --> E1 --> E2
  A --> M3
  M2 --> Z[Aplikasi: sortir, QC, navigasi]
  E2 --> Z
  M3 --> Z
import numpy as np
from sklearn.metrics import confusion_matrix, classification_report


def knn_fit_predict(
    X_train: np.ndarray,
    y_train: np.ndarray,
    X_test: np.ndarray,
    k: int = 5,
) -> np.ndarray:
    """kNN brute-force; X sudah dinormalisasi."""
    preds = []
    for x in X_test:
        d = np.linalg.norm(X_train - x, axis=1)
        nn = np.argsort(d)[:k]
        vals, cnts = np.unique(y_train[nn], return_counts=True)
        preds.append(vals[cnts.argmax()])
    return np.array(preds)


def zscore_train_apply(X_train: np.ndarray, X_test: np.ndarray):
    mu = X_train.mean(axis=0)
    sig = X_train.std(axis=0) + 1e-9
    return (X_train - mu) / sig, (X_test - mu) / sig


# Contoh evaluasi
# y_pred = knn_fit_predict(X_tr_n, y_tr, X_te_n, k=5)
# print(confusion_matrix(y_te, y_pred))
# print(classification_report(y_te, y_pred))
Pustaka deteksi: OpenCV cv2.matchTemplate, cv2.HoughLines, cv2.HoughCircles; scikit-image feature.match_template, transform.hough_line, transform.hough_circle; deep learning (di luar cakupan modul): PyTorch + torchvision, Ultralytics YOLO.