Materi berdiri sendiri berdasarkan buku Josh Starmer
Penulis
Anggit Wirasto, S.Si., M.Eng.
Materi ini adalah modul berdiri sendiri yang merangkum The StatQuest Illustrated Guide to Machine Learning (Josh Starmer, StatQuest Publications, 2022). Filosofi StatQuest sederhana tetapi kuat: algoritme ML yang tampak rumit dipecah menjadi potongan kecil, setiap potongan dilengkapi gambar, analogi, dan contoh angka agar Anda memahami mengapa rumus bekerja — bukan sekadar menghafal bagaimana mengetiknya.
Josh Starmer sering memulai dengan pertanyaan nyata (“Bagaimana memprediksi berat badan dari tinggi?”), lalu secara bertahap memperkenalkan notasi. Materi ini mengikuti pola yang sama: bahasa awam dulu, formulasi matematis setelah intuisi terbentuk.
Referensi utama: Starmer, J. (2022). The StatQuest Illustrated Guide to Machine Learning!!! StatQuest Publications. PDF: 610435041-The-StatQuest-Illustrated-Guide-to-Machine-Learning-Josh-Starmer.pdf. Video pendukung: StatQuest with Josh Starmer.
0.1 Tujuan pembelajaran
Setelah mempelajari materi ini, mahasiswa diharapkan mampu:
Menjelaskan konsep dasar ML — supervised vs unsupervised, regresi vs klasifikasi, parameter vs hiperparameter, overfitting — dengan contoh domain yang relevan.
Menerapkan cross-validation untuk estimasi performa dan pemilihan model secara disiplin, serta menjelaskan mengapa satu split latih/uji saja bisa menipu.
Menggunakan statistik dasar (mean, varians, distribusi normal, korelasi, standard error) sebagai fondasi pemahaman algoritme.
Memformulasikan dan menginterpretasikan regresi linear, gradient descent, dan regresi logistik pada contoh kasus konkret.
Menjelaskan Naive Bayes, metrik evaluasi, dan regularisasi (Ridge/Lasso) serta memilih metrik yang selaras biaya kesalahan bisnis.
Membandingkan pohon keputusan, SVM, dan neural networks — kapan memakai masing-masing, dan apa trade-off-nya.
Menjalankan studi kasus end-to-end — dari EDA, baseline, pemodelan dengan Pipeline, cross-validation, hingga evaluasi final di set uji.
1 Peta materi (12 bab StatQuest)
Bab
Judul (StatQuest)
Inti yang dipelajari
1
Fundamental Concepts in Machine Learning
Apa itu ML, jenis pembelajaran, overfitting
2
Cross Validation
Estimasi performa stabil, pemilihan model
3
Fundamental Concepts in Statistics
Mean, varians, normal, korelasi
4
Linear Regression
Garis terbaik, residual, OLS
5
Gradient Descent
Optimasi iteratif, learning rate
6
Logistic Regression
Probabilitas kelas, sigmoid
7
Naive Bayes
Teorema Bayes, asumsi independensi
8
Assessing Model Performance
Confusion matrix, precision, ROC
9
Preventing Overfitting with Regularization
Ridge, Lasso, penalti parameter
10
Decision Trees
Split, entropy, interpretabilitas
11
Support Vector Classifiers and Machines
Margin, kernel, support vectors
12
Neural Networks
Lapisan, aktivasi, backpropagation
—
Studi kasus end-to-end
EDA → model → evaluasi (bab penutup)
2 Konsep dasar machine learning (Bab 1)
2.1 Apa itu machine learning?
Machine learning (ML) adalah cabang ilmu di mana komputer belajar pola dari data untuk membuat prediksi atau keputusan pada observasi baru — tanpa diprogram secara eksplisit aturan untuk setiap kemungkinan input.
2.1.1 Analogi StatQuest: tinggi → berat
Bayangkan klinik ingin memperkirakan berat badan (kg) pasien dari tinggi badan (cm). Pendekatan manual:
Dokter menulis aturan: “tinggi 170 cm → berat sekitar 65 kg.”
Aturan ini kaku; tidak menangkap variasi tubuh, usia, atau jenis kelamin.
Pendekatan ML:
Kumpulkan ribuan pasangan (tinggi, berat) dari pemeriksaan sebelumnya.
Algoritme menyesuaikan parameter (misalnya kemiringan garis) agar prediksi mendekati data.
Pasien baru yang belum pernah ada di data latih → model memprediksi beratnya.
Inilah inti ML: pola dipelajari dari contoh, bukan ditulis tangan.
2.1.2 Istilah dasar
Istilah
Makna
Contoh
Observasi / sampel
satu baris data
satu transaksi e-commerce
Fitur (\(x\))
variabel input
luas rumah, usia pelanggan
Target / label (\(y\))
yang ingin diprediksi
harga rumah, churn ya/tidak
Model
fungsi \(f\) yang memetakan \(x \to \hat{y}\)
garis regresi, pohon keputusan
Prediksi (\(\hat{y}\))
output model
harga perkiraan Rp 450 juta
2.1.3 Contoh aplikasi ML di berbagai domain
Domain
Pertanyaan bisnis
Jenis ML
Perbankan
Apakah pinjaman ini akan macet?
Klasifikasi (supervised)
Ritel
Berapa unit terjual minggu depan?
Regresi (supervised)
Kesehatan
Segmentasi pasien risiko tinggi/rendah
Klasifikasi atau klastering
Pertanian
Kelompokkan lahan dengan pola NDVI serupa
Klastering (unsupervised)
Media sosial
Rekomendasi konten yang relevan
Ranking / klasifikasi
2.2 Supervised vs unsupervised learning
2.2.1 Supervised learning — label sudah diketahui
Setiap contoh latih punya jawaban benar\(y\). Algoritme belajar: “jika fitur \(x\) seperti ini, target-nya biasanya \(y\).”
Contoh supervised:
Klasifikasi spam:\(x\) = kata-kata dalam email, \(y\) = spam / bukan spam.
Prediksi harga rumah:\(x\) = luas, lokasi, kamar tidur; \(y\) = harga transaksi (juta Rp).
Diagnosis penyakit:\(x\) = hasil lab; \(y\) = positif / negatif.
2.2.2 Unsupervised learning — tanpa label
Hanya ada fitur \(x\). Algoritme mencari struktur — klaster, outlier, komponen utama — tanpa “jawaban kunci.”
Contoh unsupervised:
Segmentasi pelanggan e-commerce: kelompokkan pembeli berdasarkan frekuensi & nilai belanja tanpa label “loyal/tidak” sebelumnya.
Deteksi anomali transaksi: temukan pola transaksi yang jarang terjadi tanpa daftar penipuan lengkap.
Kompresi fitur (PCA): ringkas 50 sensor menjadi 5 komponen utama.
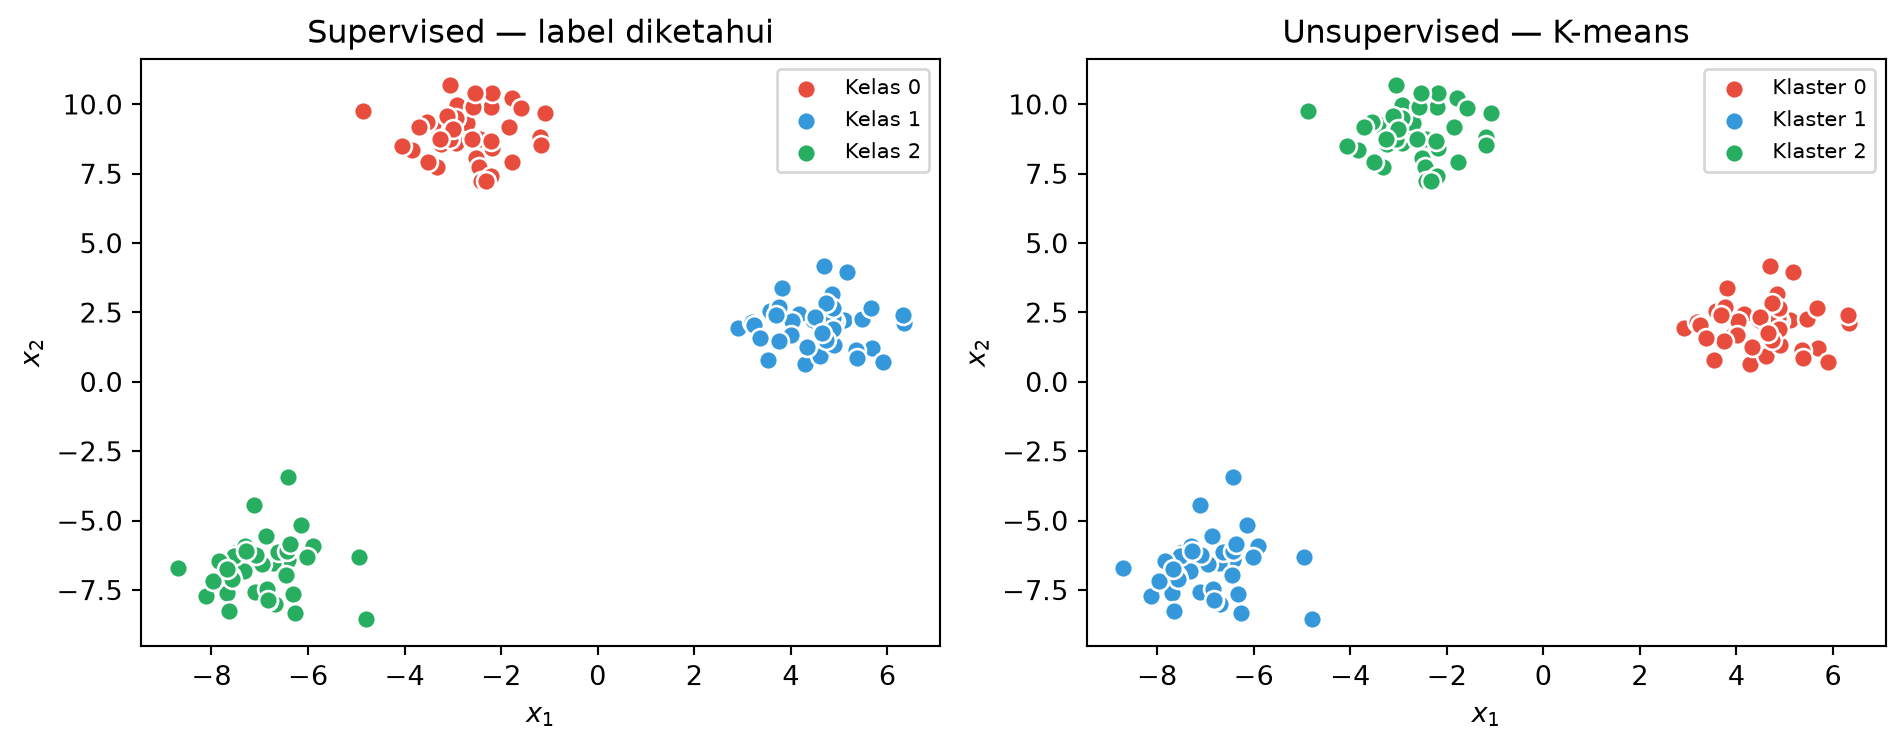
import matplotlib.pyplot as pltimport numpy as npfrom sklearn.cluster import KMeansfrom sklearn.datasets import make_blobsX, y = make_blobs(n_samples=120, centers=3, cluster_std=0.9, random_state=42)fig, axes = plt.subplots(1, 2, figsize=(10, 4))for k, c inzip(range(3), ["#e74c3c", "#3498db", "#27ae60"]): mask = y == k axes[0].scatter(X[mask, 0], X[mask, 1], c=c, s=50, edgecolors="white", label=f"Kelas {k}")axes[0].set_title("Supervised — label diketahui")axes[0].legend(fontsize=8)axes[0].set_xlabel("$x_1$")axes[0].set_ylabel("$x_2$")km = KMeans(n_clusters=3, n_init=10, random_state=42).fit(X)for k, c inzip(range(3), ["#e74c3c", "#3498db", "#27ae60"]): mask = km.labels_ == k axes[1].scatter(X[mask, 0], X[mask, 1], c=c, s=50, edgecolors="white", label=f"Klaster {k}")axes[1].set_title("Unsupervised — K-means")axes[1].legend(fontsize=8)axes[1].set_xlabel("$x_1$")axes[1].set_ylabel("$x_2$")plt.tight_layout()
Gambar 1: Kiri: supervised — warna = label kelas yang diketahui saat latih. Kanan: unsupervised — K-means menemukan 3 klaster tanpa label.
Membaca gambar: di kiri, warna titik adalah “kebenaran” yang diajarkan ke model. Di kanan, algoritme menebak pengelompokan hanya dari posisi titik — hasilnya bisa masuk akal, tetapi label klaster (0, 1, 2) tidak otomatis sama dengan label asli.
2.3 Regresi vs klasifikasi
Keduanya termasuk supervised learning, tetapi bentuk target \(y\) berbeda:
Target \(y\)
Nama tugas
Contoh \(y\)
Output model
Numerik kontinu
Regresi
harga, suhu, kWh
bilangan real (mis. 472,5)
Kategorik / diskret
Klasifikasi
spam/bukan, A/B/C
nama kelas atau probabilitas kelas
Contoh regresi — sewa apartemen: fitur = luas (m²), lantai, jarak ke stasiun; target = sewa bulanan (juta Rp). Model mengeluarkan angka, misalnya ŷ = 4,2 juta.
Contoh klasifikasi — persetujuan KPR: fitur = penghasilan, utang, skor kredit; target = disetujui / ditolak. Model mengeluarkan kelas atau \(P(\text{disetujui}) = 0{,}73\).
Kesalahan umum: memakai regresi linear langsung untuk klasifikasi (memprediksi 0,7 dan 1,3 untuk kelas 0/1). Regresi logistik (Bab 6) dirancang khusus untuk output probabilitas \([0, 1]\).
2.4 Parameter vs hiperparameter
Pembedaan ini sering membingungkan; StatQuest menekankannya sejak awal karena kesalahan di sini membuat eksperimen tidak reproduksibel dan evaluasi bias.
Istilah
Siapa yang menetapkan?
Kapan ditetapkan?
Contoh
Parameter model
Dipelajari dari data latih
saat fit()
\(\beta\) regresi, bobot neural net
Hiperparameter
Anda sebagai praktisi ML
sebelumfit()
\(k\) k-NN, kedalaman pohon, \(\alpha\) Ridge
2.4.1 Contoh konkret: k-Nearest Neighbors
Parameter: tidak ada bobot global — yang “disimpan” adalah seluruh data latih (instance-based).
Hiperparameter \(k\): berapa tetangga yang diambil suaranya?
\(k = 1\): sangat sensitif noise — satu titik anomali bisa mengubah prediksi.
\(k = 50\): batas keputusan halus — tetapi bisa mengaburkan pola lokal.
Anda tidak memilih \(k\) berdasarkan akurasi set uji berulang kali. Anda memilih \(k\) dengan cross-validation di data latih (Bab 2).
2.5 Data latih, data uji, dan kebocoran informasi
2.5.1 Analogi: buku latihan vs ujian resmi
Data latih = buku soal latihan yang dipakai berulang kali saat belajar.
Data uji = lembar ujian resmi yang sengaja tidak pernah dibuka saat belajar.
Jika Anda menghafal jawaban ujian karena kebetulan sudah melihatnya, nilai ujian tinggi tetapi kemampuan sebenarnya rendah. Model ML yang “melihat” set uji saat latih mengalami hal serupa — skor test terlalu optimis.
Subset
Peran
Kesalahan yang harus dihindari
Training
sesuaikan parameter
menilai performa final di sini saja
Testing
estimasi generalisasi
tuning hiperparameter berulang di sini
2.5.2 Data leakage — contoh nyata
Kebocoran
Mengapa menipu
Normalisasi dihitung dari train + test
Mean/std test ikut “mengajar” transformasi
Fitur “total pembayaran” untuk prediksi churn
Hanya terisi setelah pelanggan pergi
Duplikat baris di train dan test
Uji tidak independen
Aturan emas: semua langkah yang mempelajari statistik dari data (StandardScaler, imputasi median, encoding kategori langka) harus fit di train, lalu transform di test — idealnya dalam satu Pipeline.
2.6 Overfitting, underfitting, dan bias–varians
2.6.1 Underfitting — model terlalu sederhana
Model tidak cukup fleksibel menangkap pola. Contoh: memprediksi harga rumah selalu sama (rata-rata) tanpa mempedulikan luas. Error tinggi di latih dan uji.
2.6.2 Overfitting — model terlalu fleksibel
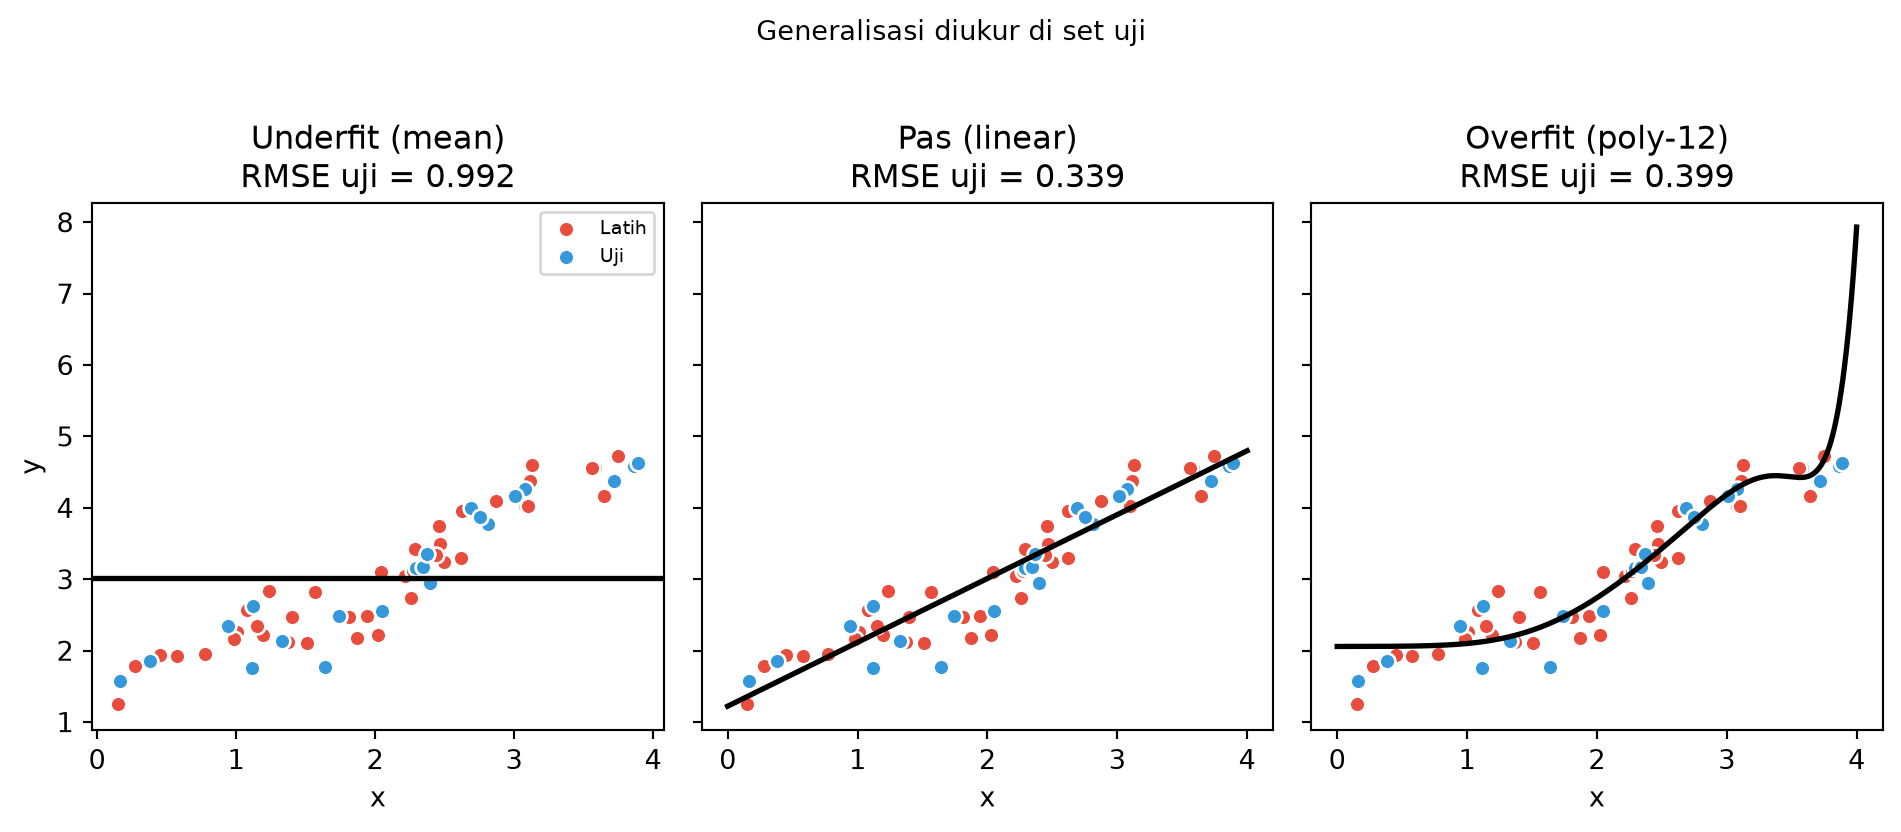
Model menghafal noise di data latih. Contoh: polinomial derajat 15 yang melengkung liar mengikuti setiap titik latih, tetapi meleset besar di uji.
StatQuest mengilustrasikan dengan tiga tingkat kompleksitas:
Gambar 2: Underfit (rata-rata), pas (linear), overfit (polinomial derajat 12). RMSE di set uji — bukan latih — menentukan pilihan.
Cara membaca: model tengah (linear) biasanya RMSE uji terendah — titik kompromi. Model kanan mungkin hampir sempurna di latih (merah) tetapi buruk di uji (biru).
2.6.3 Dekomposisi error (bias–varians)
\[
\mathbb{E}\bigl[(Y - \hat{f}(x))^2\bigr] \approx \underbrace{\text{Bias}^2(\hat{f}(x))}_{\text{model terlalu sederhana}} + \underbrace{\mathbb{V}\text{ar}(\hat{f}(x))}_{\text{model terlalu sensitif terhadap sampel}} + \underbrace{\sigma^2}_{\text{noise yang tidak bisa dihilangkan}}
\]
Evaluasi final di set uji — laporkan metrik yang sudah disepakati stakeholder.
Deploy — simpan model + preprocessor identik dengan yang dilatih.
3 Cross-validation (Bab 2)
3.1 Mengapa satu split latih/uji tidak cukup?
Bayangkan Anda mengocok 100 kartu mahasiswa, mengambil 80 untuk latih dan 20 untuk uji. Kebetulan, 20 kartu uji bisa berisi mahasiswa yang “mudah” atau “sulit” diprediksi. Skor uji 80% bisa turun menjadi 65% jika pengocokan diulang dengan random_state berbeda.
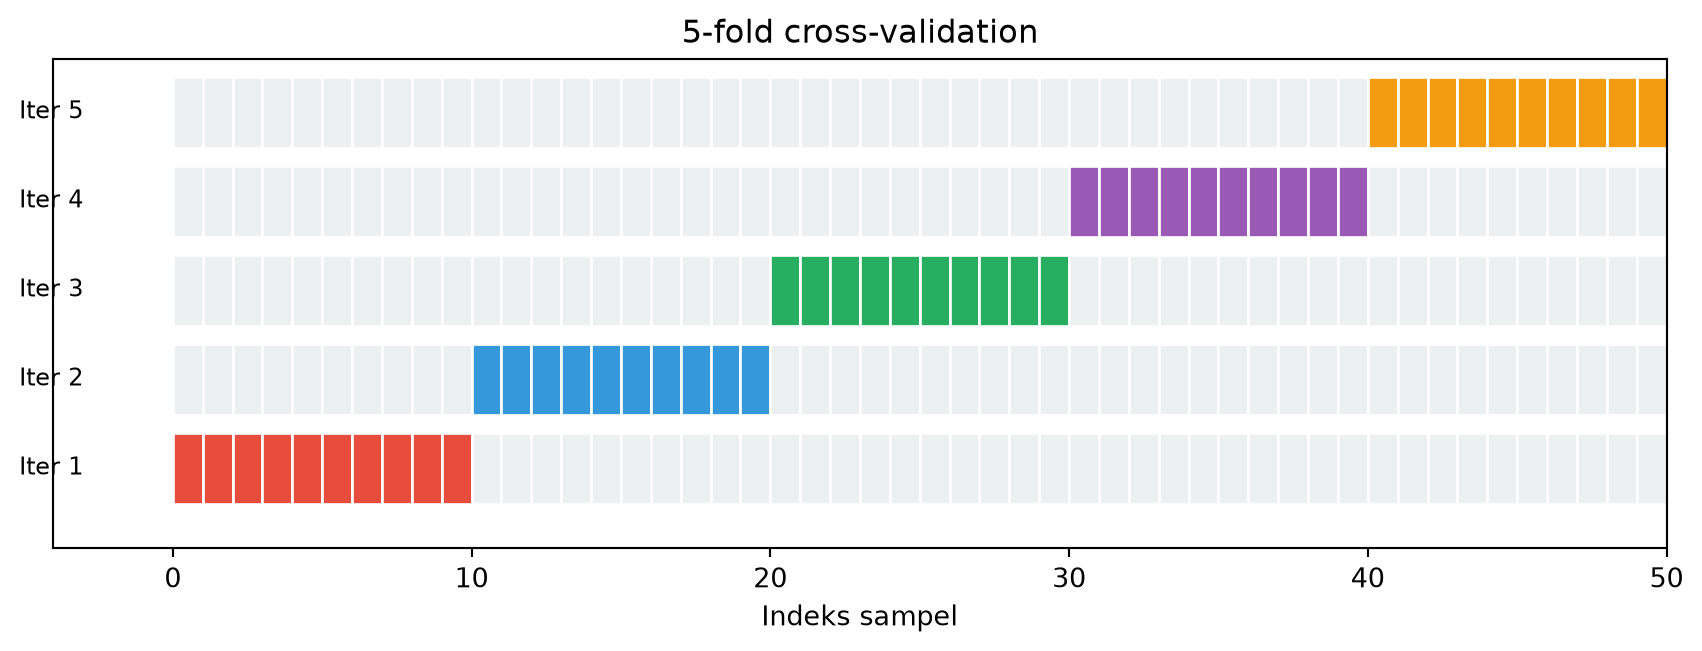
Cross-validation (CV) mengatasi ini dengan mengulang evaluasi berkali-kali pada fold berbeda, lalu merata-rata skor. Hasilnya lebih stabil dan lebih mencerminkan performa model pada data baru.
import matplotlib.pyplot as pltimport matplotlib.patches as mpatchesimport numpy as npK, n =5, 50fold_size = n // Kcolors = ["#e74c3c", "#3498db", "#27ae60", "#9b59b6", "#f39c12"]fig, ax = plt.subplots(figsize=(9, 3.5))for i inrange(K): start = i * fold_size end = start + fold_size if i < K -1else nfor j inrange(n): c = colors[i] if start <= j < end else"#ecf0f1" ax.add_patch(mpatches.Rectangle((j, i), 1, 0.8, facecolor=c, edgecolor="white")) ax.text(-3, i +0.4, f"Iter {i+1}", ha="right", va="center", fontsize=9)ax.set_xlim(-4, n)ax.set_ylim(-0.5, K)ax.set_xlabel("Indeks sampel")ax.set_yticks([])ax.set_title(f"{K}-fold cross-validation")plt.tight_layout()
Gambar 3: 5-fold CV — setiap baris = satu iterasi; kotak berwarna = fold validasi sementara.
3.2.1 Varian CV yang perlu dikenal
Varian
Kapan dipakai
Stratified \(K\)-fold
Klasifikasi — proporsi kelas di tiap fold ≈ populasi
Leave-one-out (LOOCV)
\(K = n\) — data sangat kecil; mahal komputasi
Time-series split
Data deret waktu — validasi selalu di masa depan
Contoh stratified: dataset pinjaman macet 5% vs lancar 95%. Tanpa stratify, satu fold validasi bisa kebetulan tanpa satupun macet → metrik tidak bermakna.
3.3 Protokol disiplin (StatQuest)
Pisahkan set uji sekali di awal — dikunci sampai laporan akhir.
Di data latih saja, jalankan \(K\)-fold CV untuk setiap kandidat model/hiperparameter.
Pilih kandidat dengan rata-rata skor CV terbaik (dan simpan standar deviasi skor fold).
Latih ulang model terpilih pada seluruh latih (praktik umum sebelum deploy).
Laporkan skor final sekali di set uji — tidak mengulang eksperimen karena skor test “kurang bagus.”
3.3.1 Contoh: memilih Ridge vs Linear pada diabetes
Dataset diabetes (sklearn): 10 fitur fisiologis, target = perkembangan penyakit satu tahun kemudian. Ini contoh regresi medis — RMSE mengukur seberapa jauh prediksi menyimpang dari nilai aktual.
Pilih model berdasarkan RMSE CV (rata-rata) — bukan kolom uji.
Kolom std fold besar → performa tidak stabil antar fold; waspada dataset kecil atau heterogen.
Kolom uji hanya konfirmasi sekali; jika jauh lebih buruk dari CV, cek kebocoran atau distribusi train/test yang berbeda.
4 Konsep statistik dasar (Bab 3)
StatQuest menempatkan statistik sebelum regresi karena hampir semua algoritme ML bergantung pada tiga ide: pusat data (mean), penyebaran (varians), dan bentuk distribusi (normal). Tanpa ini, koefisien regresi dan probabilitas Naive Bayes terasa seperti angka ajaib.
4.1 Populasi, sampel, mean, dan varians
Populasi — seluruh entitas yang diminati (semua penduduk Indonesia, semua transaksi tahun ini).
Sampel — subset yang kita ukur (500 responden survei, 10.000 transaksi bulan lalu).
Karena kita hampir tidak pernah punya populasi penuh, ML bekerja pada sampel — dan sampel membawa ketidakpastian.
Contoh — nilai ujian 30 mahasiswa:\(\bar{x} = 72\) berarti rata-rata kelas 72. Jika \(s = 18\), sebaran lebar — ada yang 40 dan ada yang 95. Model prediksi nilai individu akan lebih sulit dibanding jika \(s = 5\).
4.2 Distribusi normal
Banyak fenomena alam dan error pengukuran mendekati distribusi normal (Gaussian):
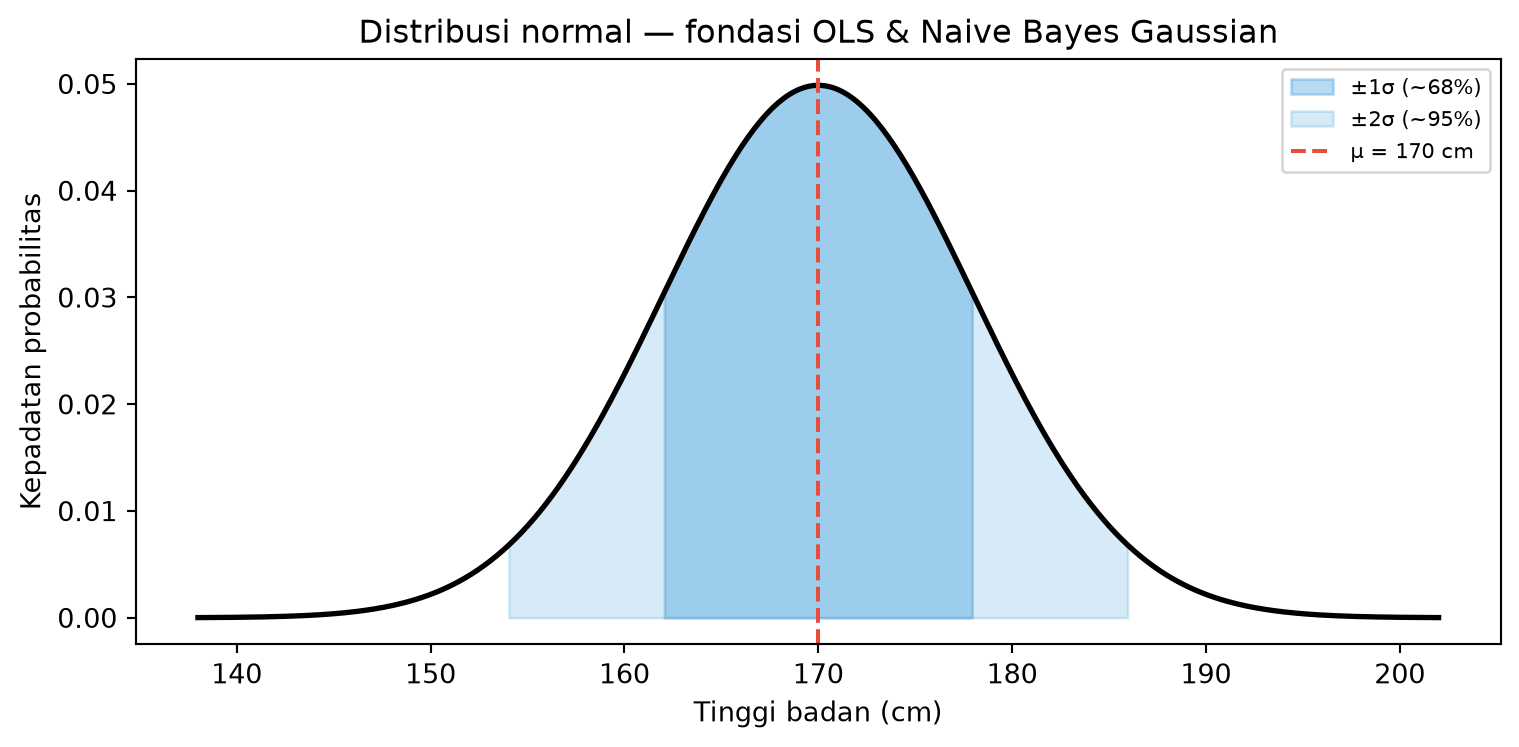
Contoh — tinggi badan mahasiswa:\(\mu = 170\) cm, \(\sigma = 8\) cm. Sekitar 68% berada antara 162–178 cm. Naive Bayes Gaussian memodelkan setiap fitur per kelas sebagai “lonceng” seperti ini.
import matplotlib.pyplot as pltimport numpy as npfrom scipy.stats import normmu, sigma =170, 8x = np.linspace(mu -4* sigma, mu +4* sigma, 400)y = norm.pdf(x, mu, sigma)fig, ax = plt.subplots(figsize=(8, 4))ax.plot(x, y, "k-", lw=2)ax.fill_between(x, y, where=(x >= mu - sigma) & (x <= mu + sigma), alpha=0.35, color="#3498db", label="±1σ (~68%)")ax.fill_between(x, y, where=(x >= mu -2*sigma) & (x <= mu +2*sigma), alpha=0.2, color="#3498db", label="±2σ (~95%)")ax.axvline(mu, color="#e74c3c", ls="--", label=f"μ = {mu} cm")ax.set_xlabel("Tinggi badan (cm)")ax.set_ylabel("Kepadatan probabilitas")ax.set_title("Distribusi normal — fondasi OLS & Naive Bayes Gaussian")ax.legend(fontsize=8)plt.tight_layout()
Gambar 4: Distribusi normal — μ = 170 cm, σ = 8 cm. Area biru = ±1σ (~68%) dan ±2σ (~95%).
4.3 Standard error — ketidakpastian estimasi
Mean sampel \(\bar{x}\)bervariasi jika kita ambil sampel berbeda. Standard error mengukur seberapa besar variasi itu:
\[
\mathrm{SE}(\bar{x}) = \frac{s}{\sqrt{n}}
\]
Ukuran sampel \(n\)
SE (jika \(s = 18\))
Interpretasi
30
\(18/\sqrt{30} \approx 3{,}3\)
Rata-rata sampel bisa menyimpang ±3 poin dari populasi
300
\(18/\sqrt{300} \approx 1{,}0\)
Estimasi jauh lebih presisi
3000
\(18/\sqrt{3000} \approx 0{,}3\)
Hampir stabil
Kaitan ML: model dengan data latih sedikit cenderung varians tinggi — performa uji tidak stabil. Ini alasan mengapa deep learning rakus data.
4.4 Korelasi — bukan kausalitas
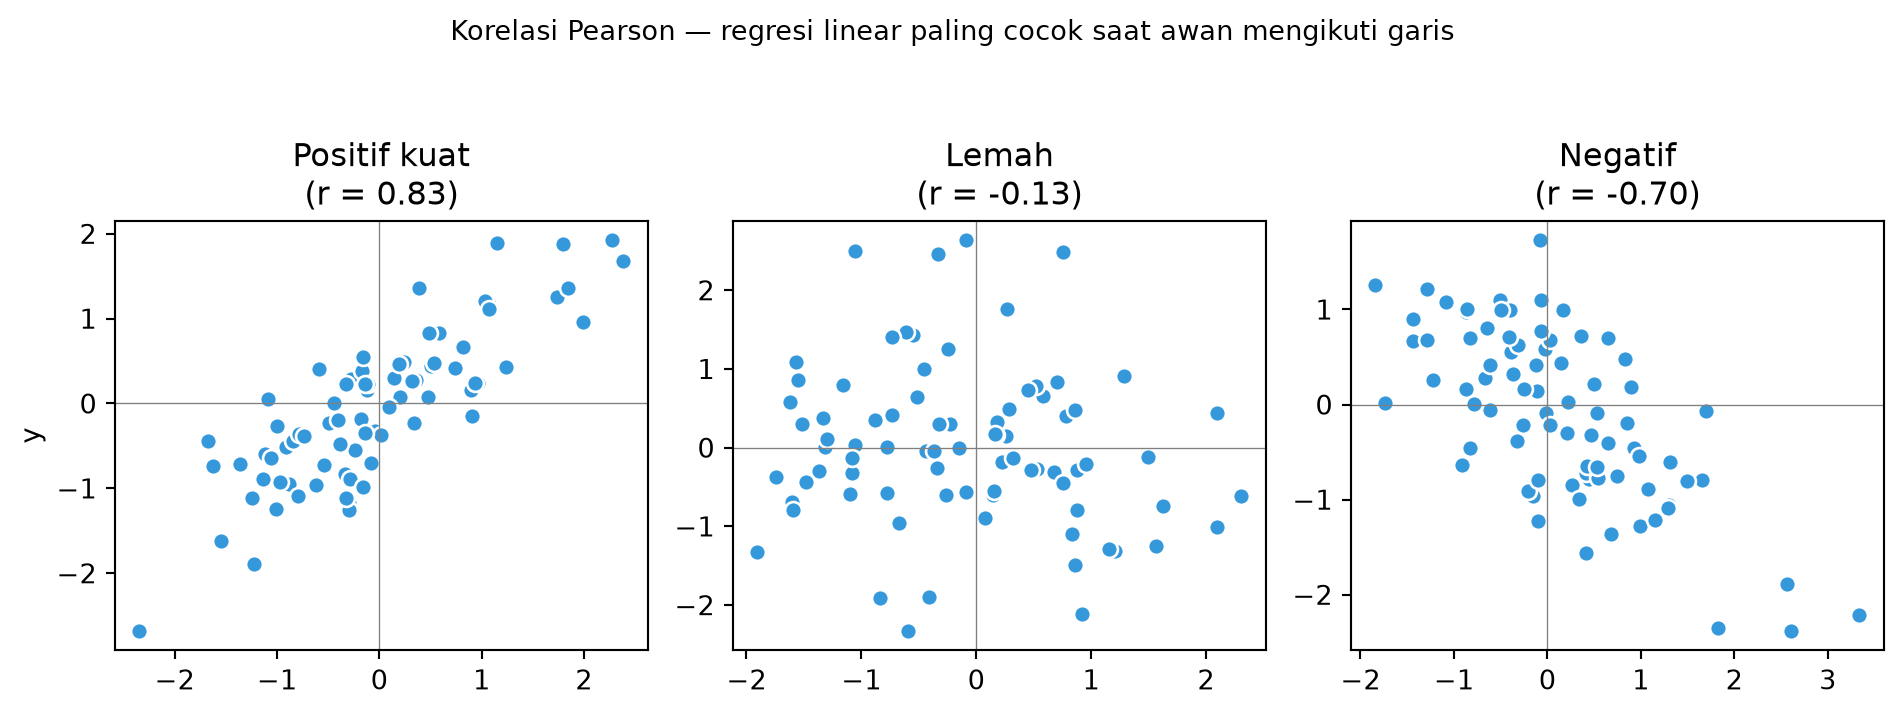
Korelasi Pearson\(r \in [-1, 1]\) mengukur kekuatan hubungan linear:
Contoh — harga rumah vs luas:\(r = 0{,}85\) wajar — luas besar cenderung harga tinggi. Regresi linear memanfaatkan ini.
Jebakan:\(r\) tinggi bukan bukti sebab-akibat. Penjualan es krim dan kasus tenggelam bisa berkorelasi karena keduanya naik di musim panas (variabel perancu: suhu).
Multikolinearitas: dua fitur \(r = 0{,}95\) (luas tanah & luas bangunan) membuat koefisien regresi tidak stabil — Ridge (Bab 9) sering membantu.
Gambar 5: Korelasi positif kuat, lemah, dan negatif — perhatikan bentuk awan titik.
5 Regresi linear (Bab 4)
Regresi linear menjawab: “Berapa nilai \(y\) yang diperkirakan jika fitur \(x\) bernilai tertentu?” Jawabannya berupa garis (atau hyperplane di dimensi tinggi) yang paling dekat dengan data menurut kriteria kuadrat error.
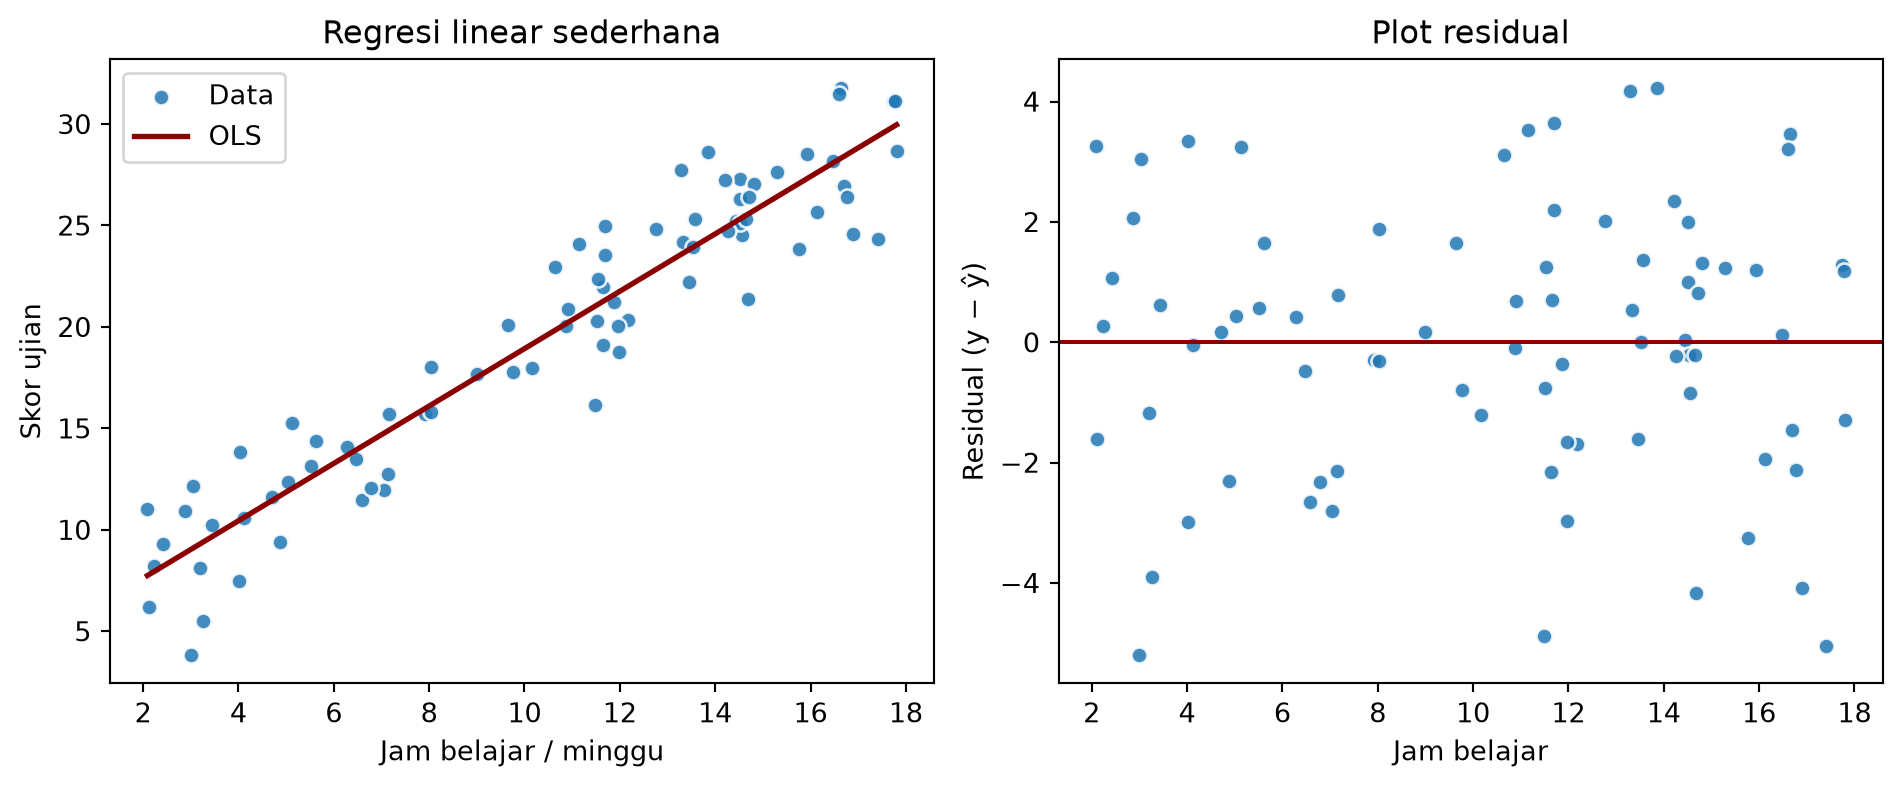
Residual\(e_i = y_i - \hat{y}_i\) = seberapa jauh titik data dari garis. OLS membuat jumlah \(e_i^2\) sekecil mungkin — residual besar dihukum sangat berat (kuadrat).
Seorang dosen mencatat jam belajar per minggu (\(x\)) dan skor ujian (\(y\)) 80 mahasiswa. Model menemukan \(\beta_1 \approx 1{,}35\): setiap jam tambahan belajar diasosiasikan dengan kenaikan skor 1,35 poin (linear, pada rentang data yang diamati).
import matplotlib.pyplot as pltimport numpy as npfrom sklearn.linear_model import LinearRegressionrng = np.random.default_rng(9)n =80x = rng.uniform(2, 18, size=n)y =5.0+1.35* x + rng.normal(0, 2.2, size=n)X = x.reshape(-1, 1)model = LinearRegression().fit(X, y)xp = np.linspace(x.min(), x.max(), 200).reshape(-1, 1)y_hat = model.predict(X)res = y - y_hatfig, axes = plt.subplots(1, 2, figsize=(10, 4.2))axes[0].scatter(x, y, alpha=0.85, edgecolors="white", label="Data")axes[0].plot(xp.ravel(), model.predict(xp), color="darkred", lw=2, label="OLS")axes[0].set_xlabel("Jam belajar / minggu")axes[0].set_ylabel("Skor ujian")axes[0].legend()axes[0].set_title("Regresi linear sederhana")axes[1].scatter(x, res, alpha=0.85, edgecolors="white")axes[1].axhline(0, color="darkred", lw=1.5)axes[1].set_xlabel("Jam belajar")axes[1].set_ylabel("Residual (y − ŷ)")axes[1].set_title("Plot residual")plt.tight_layout()print(f"β₀ (intercept) = {model.intercept_:.3f}")print(f"β₁ (slope) = {model.coef_[0]:.3f}")print("→ Setiap +1 jam belajar, skor diprediksi naik ≈", round(model.coef_[0], 2), "poin")
β₀ (intercept) = 4.785
β₁ (slope)     = 1.414
→ Setiap +1 jam belajar, skor diprediksi naik ≈ 1.41 poin
Gambar 6: Kiri: garis OLS menyeberangi awan titik. Kanan: residual tersebar acak di sekitar 0 — tanda model linear wajar.
Membaca residual: pola melengkung (U atau ∩) di plot kanan → hubungan mungkin nonlinear; pertimbangkan transformasi atau polinomial (dengan waspada overfitting).
\(\beta_1\) = kenaikan sewa per m² jika lantai dan jarak tetap. Ini interpretasi marginal — sangat berguna untuk stakeholder properti.
5.1.4 Metrik evaluasi regresi
Metrik
Rumus (intuisi)
Kapan diprioritaskan
RMSE
\(\sqrt{\text{mean}(e_i^2)}\)
Outlier penting; selaras dengan OLS
MAE
\(\text{mean}(|e_i|)\)
Outlier ekstrem harus tidak terlalu menghukum
\(R^2\)
proporsi varians terjelaskan
Perbandingan model pada dataset sama
\(R^2 = 0{,}85\) berarti model menjelaskan ~85% variasi \(y\) dibanding model “tebak rata-rata saja.” Jebakan:\(R^2\) tinggi di latih tetapi rendah di uji → overfitting.
5.1.5 Dampak outlier pada OLS
Satu rumah dengan harga ekstrem (mis. vila mewah) dapat menarik garis secara tidak proporsional karena error dikuadratkan. Solusi praktis: cek residual, pertimbangkan MAE sebagai metrik, transformasi \(\log(y)\), atau regularisasi.
6 Gradient descent (Bab 5)
OLS punya solusi tertutup untuk regresi linear — tidak perlu iterasi. Namun regresi logistik pada jutaan baris, pohon dengan loss kompleks, dan neural networks tidak punya rumus satu langkah. Di sinilah gradient descent menjadi fondasi.
6.1 Ide inti: turun lereng
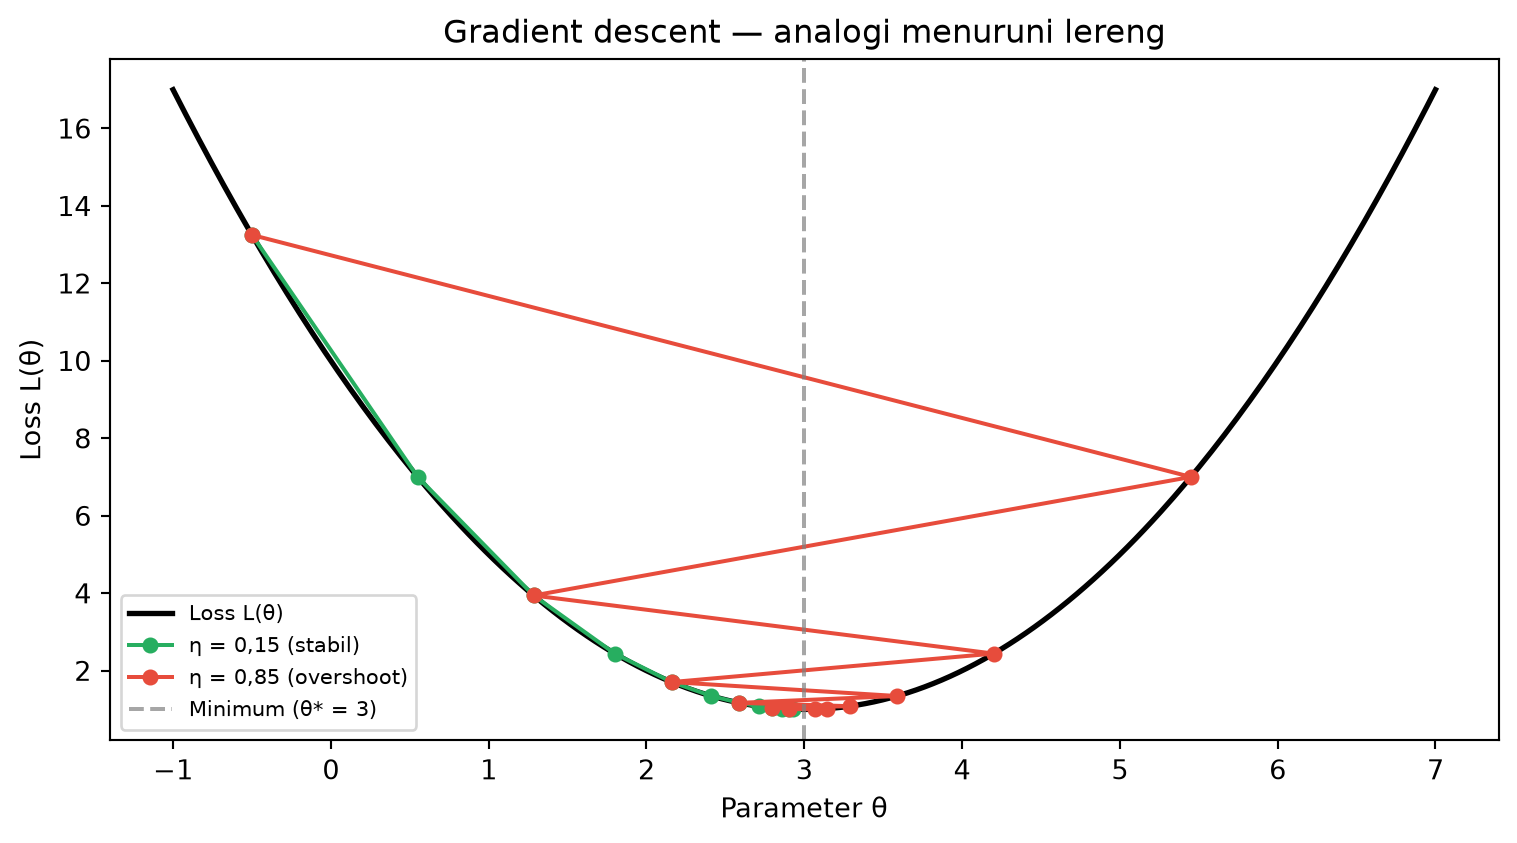
Bayangkan Anda berdiri di pegunungan berkabut dan ingin mencapai lembah terendah (minimum loss). Anda tidak melihat seluruh peta; Anda hanya merasakan kemiringan di bawah kaki (gradien) dan melangkah ke arah menurun.
\(\theta\) = parameter yang disesuaikan (misalnya \(\beta_1\)).
\(\mathcal{L}\) = fungsi kerugian (MSE, log-loss, dll.).
\(\eta\) = learning rate — seberapa besar langkah.
import matplotlib.pyplot as pltimport numpy as npdef loss(theta):return (theta -3.0) **2+1.0def grad(theta):return2* (theta -3.0)theta_grid = np.linspace(-1, 7, 300)fig, ax = plt.subplots(figsize=(8, 4.5))ax.plot(theta_grid, loss(theta_grid), "k-", lw=2, label="Loss L(θ)")for eta, color, label in [(0.15, "#27ae60", "η = 0,15 (stabil)"), (0.85, "#e74c3c", "η = 0,85 (overshoot)")]: theta, path =-0.5, []for _ inrange(12): path.append(theta) theta = theta - eta * grad(theta) ax.plot(path, [loss(t) for t in path], "o-", color=color, ms=5, label=label)ax.axvline(3.0, color="gray", ls="--", alpha=0.7, label="Minimum (θ* = 3)")ax.set_xlabel("Parameter θ")ax.set_ylabel("Loss L(θ)")ax.set_title("Gradient descent — analogi menuruni lereng")ax.legend(fontsize=8)plt.tight_layout()
Gambar 7: Learning rate kecil (hijau) konvergen stabil; terlalu besar (merah) overshoot dan osilasi.
6.1.1 Learning rate — contoh angka
\(\eta\)
Perilaku
Terlalu kecil (0,001)
Konvergen lambat — butuh ribuan iterasi
Pas (0,01–0,1)
Turun stabil ke minimum
Terlalu besar (1,0)
Melompati minimum — loss naik-turun atau divergen
6.1.2 Varian gradient descent
Varian
Gradien dihitung dari
Kelebihan / kekurangan
Batch GD
seluruh data latih
Stabil; mahal jika \(n\) besar
SGD
satu sampel acak
Cepat; noisy
Mini-batch
subset kecil (32–256)
Standar deep learning
Contoh kapan GD wajib: neural network dengan jutaan bobot — tidak ada \((X^TX)^{-1}X^Ty\) tertutup. Setiap mini-batch memperbarui bobot sedikit demi sedikit hingga loss turun.
7 Regresi logistik (Bab 6)
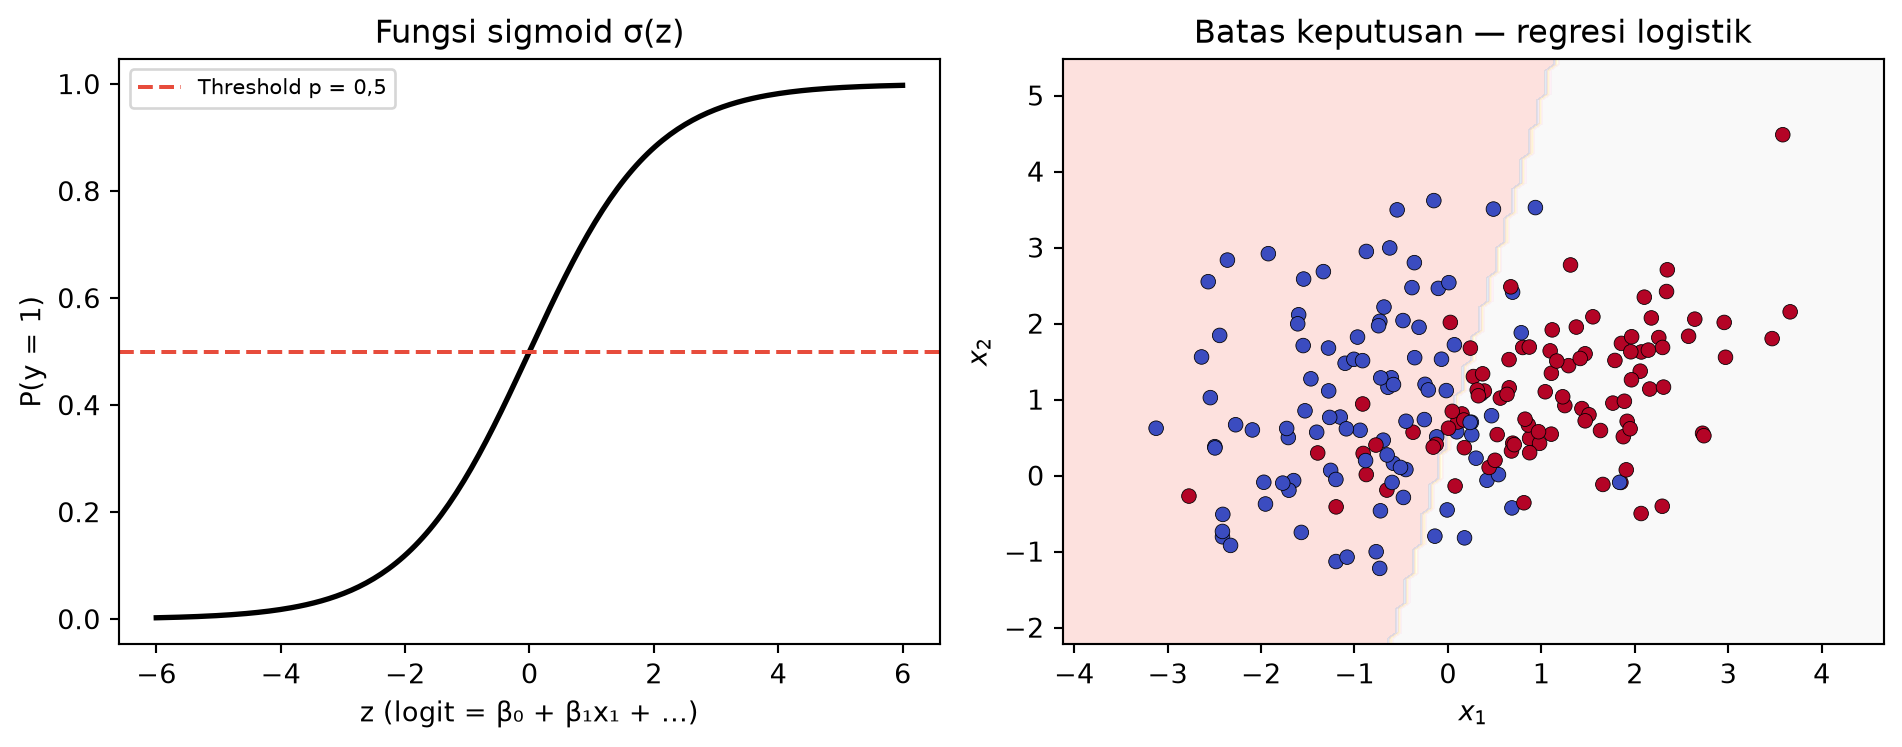
Klasifikasi biner membutuhkan output di \([0, 1]\) — probabilitas. Regresi linear bisa menghasilkan 1,3 atau −0,2 untuk “probabilitas,” yang tidak bermakna. Regresi logistik memetakan kombinasi linear fitur melalui sigmoid:
Threshold default 0,5: jika \(P(y=1) \geq 0{,}5\), prediksi kelas 1. Threshold bisa digeser jika false negative lebih mahal — misalnya deteksi kanker: turunkan threshold agar lebih banyak yang diperiksa lanjut (recall tinggi, Bab 8).
7.0.2 Log-odds (logit)
\[
\log\!\left(\frac{p}{1-p}\right) = z
\]
Hubungan linear pada skala logit, tetapi nonlinear pada skala probabilitas — inilah kekuatan model untuk batas keputusan melengkung.
7.0.3 Contoh kasus: persetujuan pinjaman KPR
Fitur
Contoh nilai
Penghasilan bulanan
Rp 12 juta
Rasio utang/pendapatan
35%
Skor kredit
720
Model mengeluarkan \(P(\text{disetujui}) = 0{,}78\). Bank bisa menetapkan kebijakan: setujui otomatis jika \(p > 0{,}7\).
Gambar 8: Kiri: kurva sigmoid — output selalu antara 0 dan 1. Kanan: batas keputusan linear pada ruang fitur (garis lurus setelah transformasi logit).
Pelatihan: memaksimumkan log-likelihood ≡ meminimumkan log-loss (cross-entropy). Optimasi biasanya via gradient descent atau solver numerik (L-BFGS di sklearn).
8 Naive Bayes (Bab 7)
Naive Bayes adalah salah satu algoritme tercepat dan sering mengejutkan efektif — terutama klasifikasi teks (spam) dan baseline awal.
8.1 Teorema Bayes — bahasa awam
“Seberapa yakin kita objek ini kelas \(C_k\), setelah melihat fitur \(x\)?”
Artinya: fitur dianggap independen satu sama lain dalam kelas. Contoh spam: “gratis” dan “klik” dianggap tidak saling mempengaruhi — jelas simplifikasi, tetapi sering cukup baik.
Membaca output: prior setara proporsi kelas di latih. Laporan per kelas menunjukkan apakah satu spesies sering tertukar — petunjuk fitur mana yang kurang memisahkan.
9 Penilaian performa model (Bab 8)
StatQuest menekankan: tetapkan metrik utama sebelum melihat hasil uji. Metrik yang salah membuat model terlihat bagus padahal gagal di dunia nyata.
9.1 Metrik regresi — contoh bisnis
Skenario: prediksi konsumsi listrik (kWh). RMSE = 45 kWh artinya rata-rata kesalahan kuadrat setara ~45 kWh — stakeholder bisa mengalikan dengan tarif Rp/kWh untuk estimasi biaya kesalahan.
Metrik
Bahasa awam
RMSE = 45 kWh
Prediksi meleset “sekitar 45 kWh” (dengan penalti besar untuk error ekstrem)
MAE = 30 kWh
Rata-rata meleset 30 kWh — lebih mudah dijelaskan ke non-teknis
Model yang selalu prediksi “sehat” mencapai akurasi 98% — tetapi recall = 0% (tidak ada penyakit yang tertangkap). Untuk penyakit serius, recall biasanya lebih penting daripada accuracy.
Metrik
Pertanyaan yang dijawab
Contoh prioritas
Precision
“Dari yang saya flag positif, berapa % benar?”
Spam filter — FP mengganggu
Recall
“Dari semua positif sebenarnya, berapa % ketangkap?”
Kanker — FN berbahaya
F1
Keseimbangan precision & recall
Kelas tidak seimbang
9.2.2 ROC & AUC
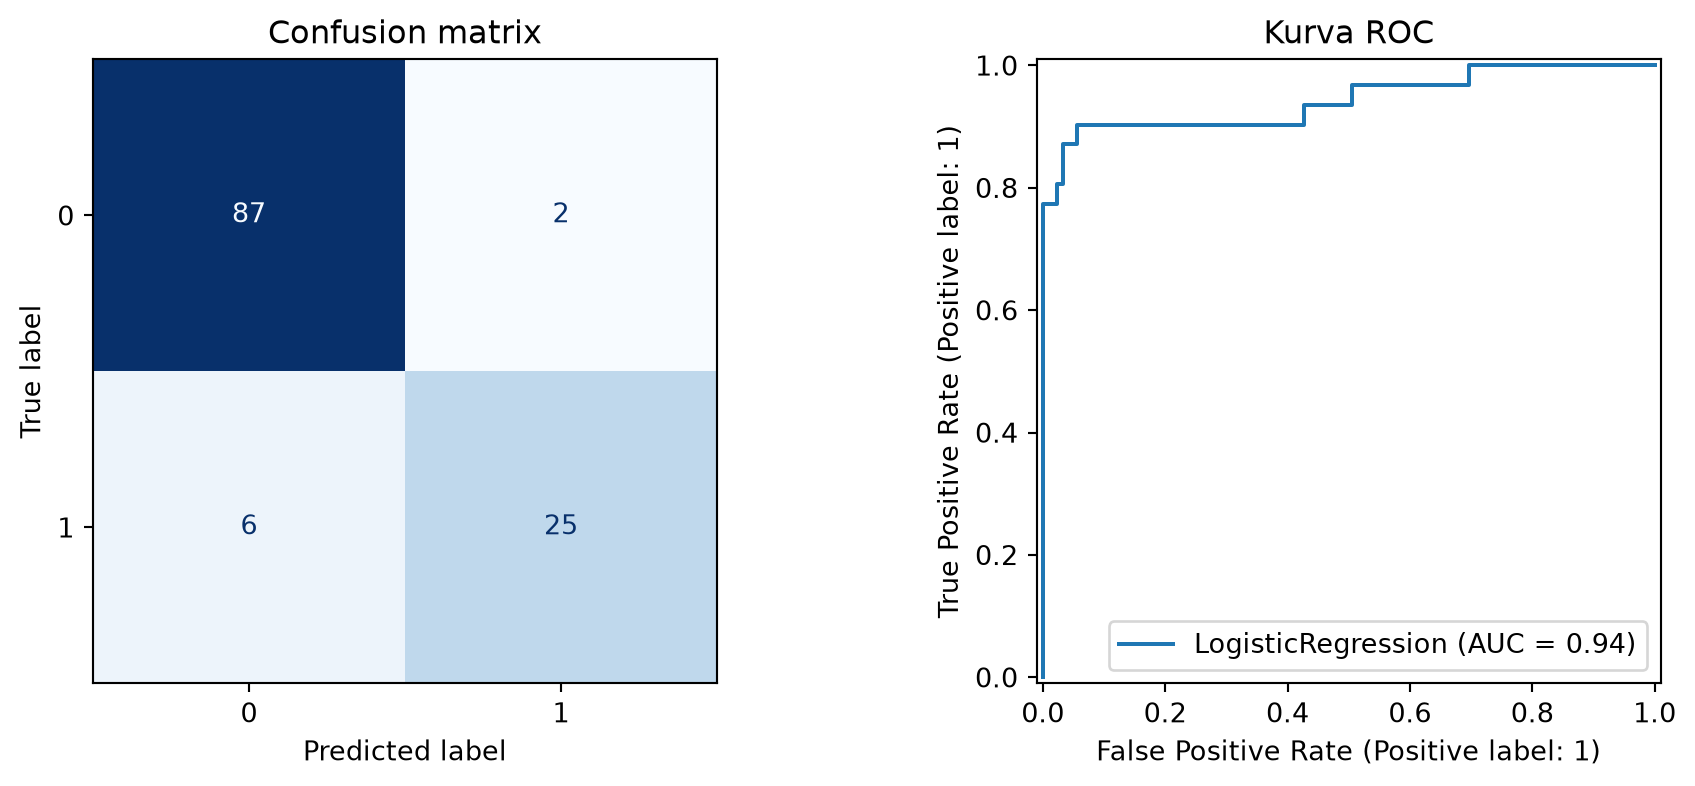
ROC memplot True Positive Rate vs False Positive Rate saat threshold \(p\) bervariasi dari 0 ke 1.
AUC ≈ 1 — model memisahkan kelas dengan baik.
AUC ≈ 0,5 — seburuk tebakan koin.
Contoh: model AUC = 0,87 untuk prediksi churn — cukup untuk ranking pelanggan risiko tinggi, meskipun threshold operasional (mis. hubungi jika \(p > 0{,}3\)) ditetapkan terpisah oleh bisnis.
Gambar 9: Kiri: confusion matrix — 75% negatif, 25% positif (tidak seimbang). Kanan: ROC — AUC mengukur kemampuan ranking tanpa memilih threshold tunggal.
10 Regularisasi — mencegah overfitting (Bab 9)
Tanpa regularisasi, OLS atau polinomial tinggi bisa membuat koefisien sangat besar untuk menyesuaikan noise — overfitting. Regularisasi menambah penalti pada besaran parameter.
10.1 Ridge (L2) dan Lasso (L1)
Metode
Penalti
Efek geometris (intuisi StatQuest)
Kapan dipakai
Ridge
\(\alpha \sum_j \beta_j^2\)
Mengecilkan semua \(\beta\)
Banyak fitur berkorelasi
Lasso
\(\alpha \sum_j |\beta_j|\)
Bisa nolkan \(\beta_j\) → seleksi fitur
Ingin model parsimonius
Elastic Net
L1 + L2
Kompromi
Banyak fitur + korelasi
Hiperparameter \(\alpha\): semakin besar → penalti kuat → model lebih sederhana (bias naik, varians turun). Pilih \(\alpha\) via cross-validation.
10.1.1 Contoh: kurva sinus dengan polinomial tinggi
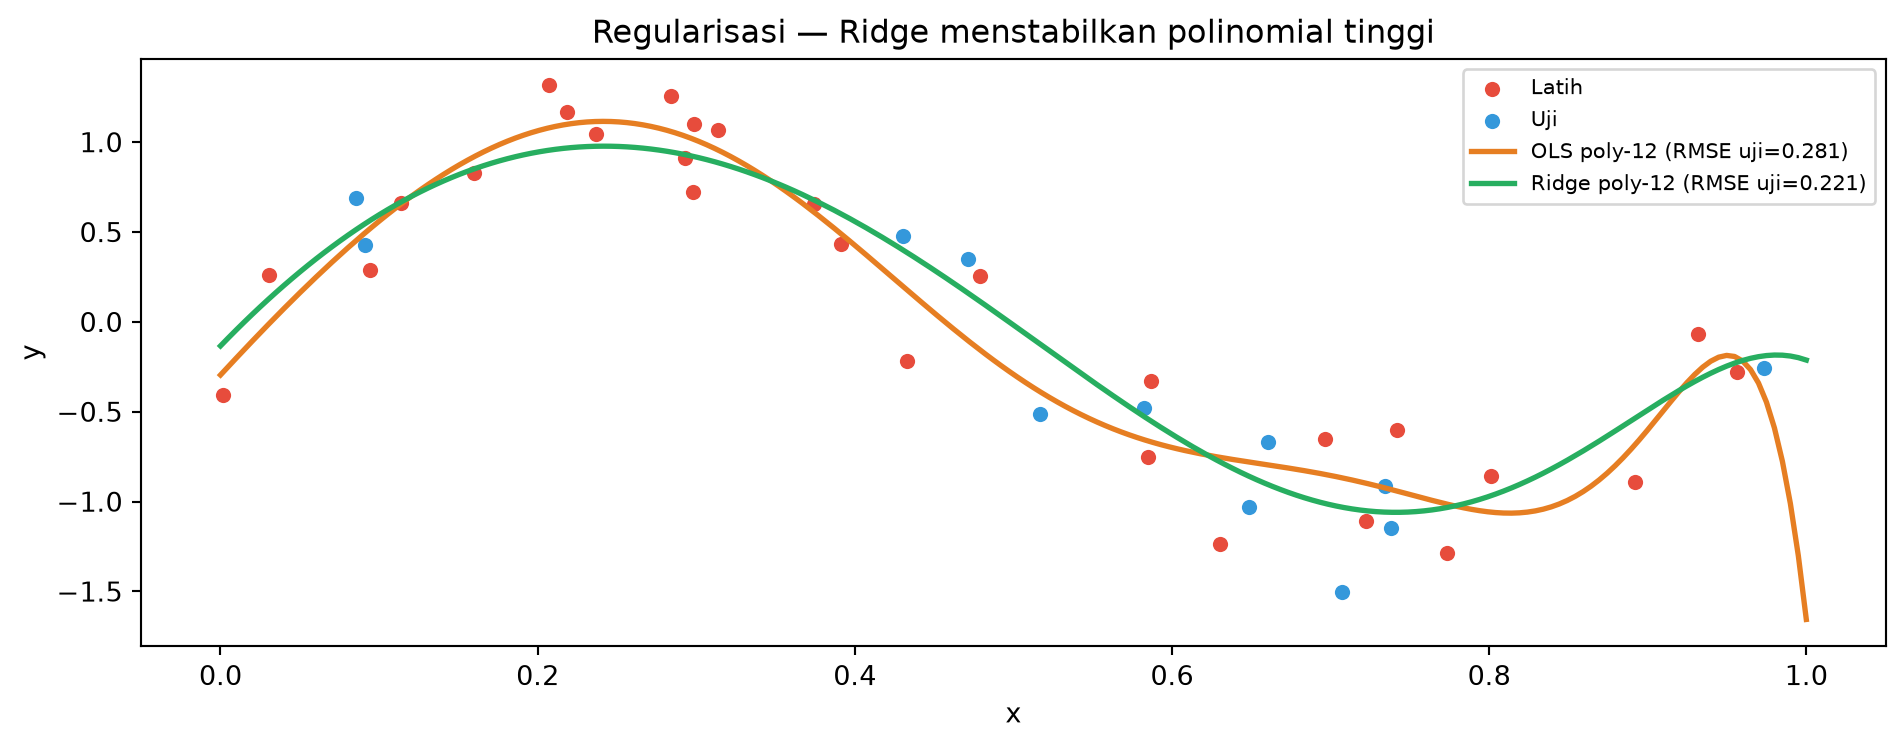
Data mengikuti \(\sin(2\pi x)\) + noise. Polinomial derajat 12 menghafal titik latih; Ridge menghaluskan kurva dan RMSE uji membaik.
Gambar 10: OLS poly-12 berliku-liuk (overfit); Ridge poly-12 lebih halus dan RMSE uji lebih rendah.
Contoh domain: prediksi harga rumah dengan 50 fitur — banyak yang redundan (luas tanah, luas bangunan, jumlah kamar). Lasso bisa mengecilkan koefisien fitur tidak penting menjadi nol, menyederhanakan model untuk audit regulator.
11 Pohon keputusan (Bab 10)
Pohon keputusan mempartisi data dengan pertanyaan berurutan — sangat mirip flowchart yang bisa dibaca manusia non-teknis.
11.1 Cara kerja — contoh narasi
Prediksi: apakah pelanggan akan churn?
Apakah masa aktif < 6 bulan?
Ya → lanjut ke (2)
Tidak → prediksi tidak churn (daun)
Apakah keluhan > 2?
Ya → prediksi churn
Tidak → prediksi tidak churn
Setiap split memilih fitur dan threshold yang memisahkan kelas paling baik.
11.2 Entropy dan information gain
Entropy mengukur “kekacauan” campuran kelas di sebuah node:
\[
H = -\sum_{k} p_k \log_2 p_k
\]
Komposisi node
Entropy
100% kelas A
0 (murni)
50% A, 50% B
1 (maksimum untuk 2 kelas)
90% A, 10% B
Rendah
Information gain = \(H_{\text{sebelum}} - H_{\text{setelah split}}\). Split yang baik menurunkan entropy — anak node lebih murni.
Contoh angka: node induk 50% churn / 50% tidak → \(H = 1\). Setelah split “keluhan > 2”, anak kiri 90% churn → entropy turun → gain tinggi → split ini dipilih.
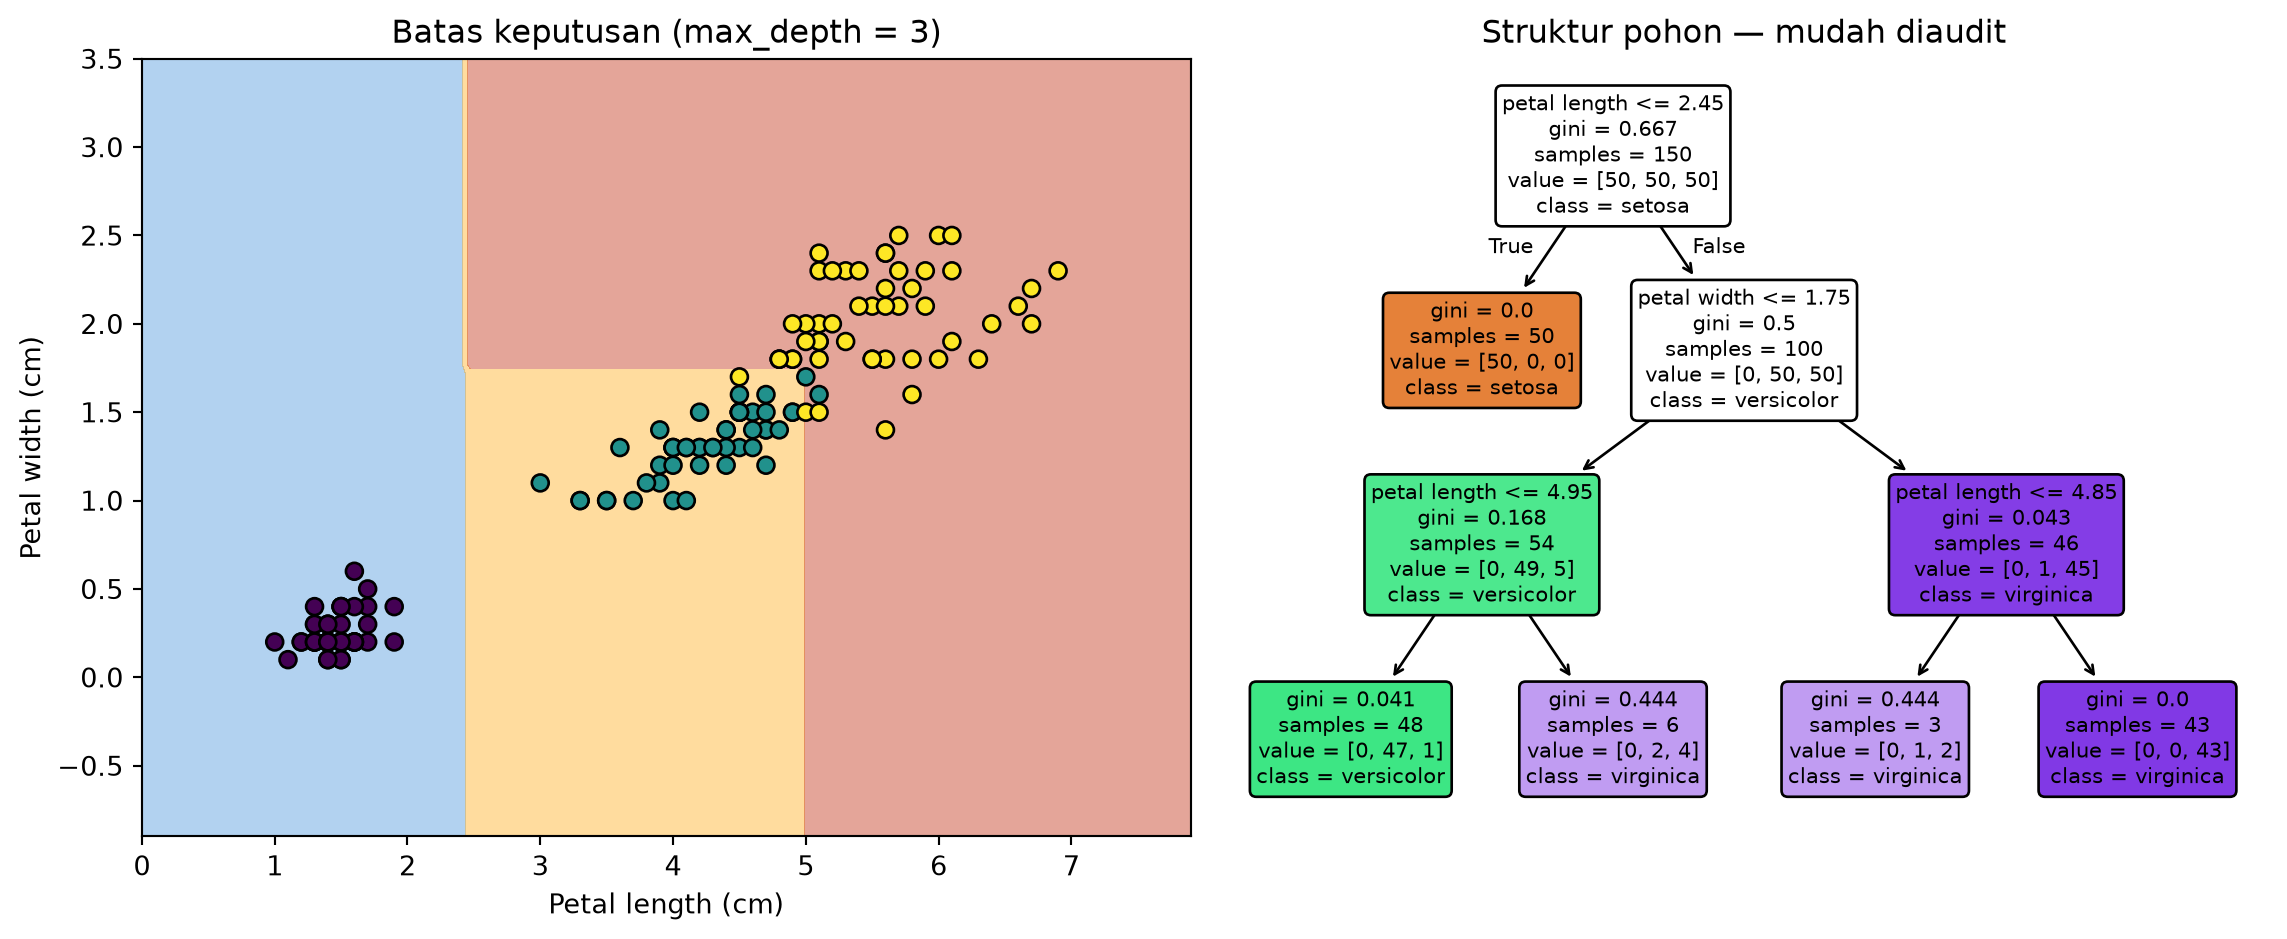
Gambar 11: Kiri: batas keputusan berbentuk kotak (axis-aligned). Kanan: struktur pohon — setiap node = pertanyaan, daun = prediksi kelas.
Hiperparameter penting:max_depth (kedalaman), min_samples_leaf (minimal sampel di daun), max_features (Random Forest). Semua dipilih via CV — pohon terlalu dalam = overfit.
12 Support Vector Machine (Bab 11)
SVM mencari batas pemisah yang bukan sekadar memisahkan kelas, tetapi memisahkan dengan margin selebar mungkin — jarak terbesar ke titik terdekat dari kedua kelas.
12.1 Margin dan support vectors
Bayangkan dua kelompok titik di kertas. Banyak garis bisa memisahkan. SVM memilih garis yang sejauh mungkin dari titik terdekat kedua sisi — titik-titik di tepi inilah support vectors. Hanya mereka yang menentukan posisi batas; titik jauh di tengah kelas tidak memengaruhi.
Soft margin (hiperparameter \(C\)):
\(C\) besar → sedikit misclassification ditoleransi; margin sempit; bisa overfit.
\(C\) kecil → margin lebar; beberapa titik “salah sisi” diizinkan; lebih robust.
12.2 Kernel trick — data bulan sabit
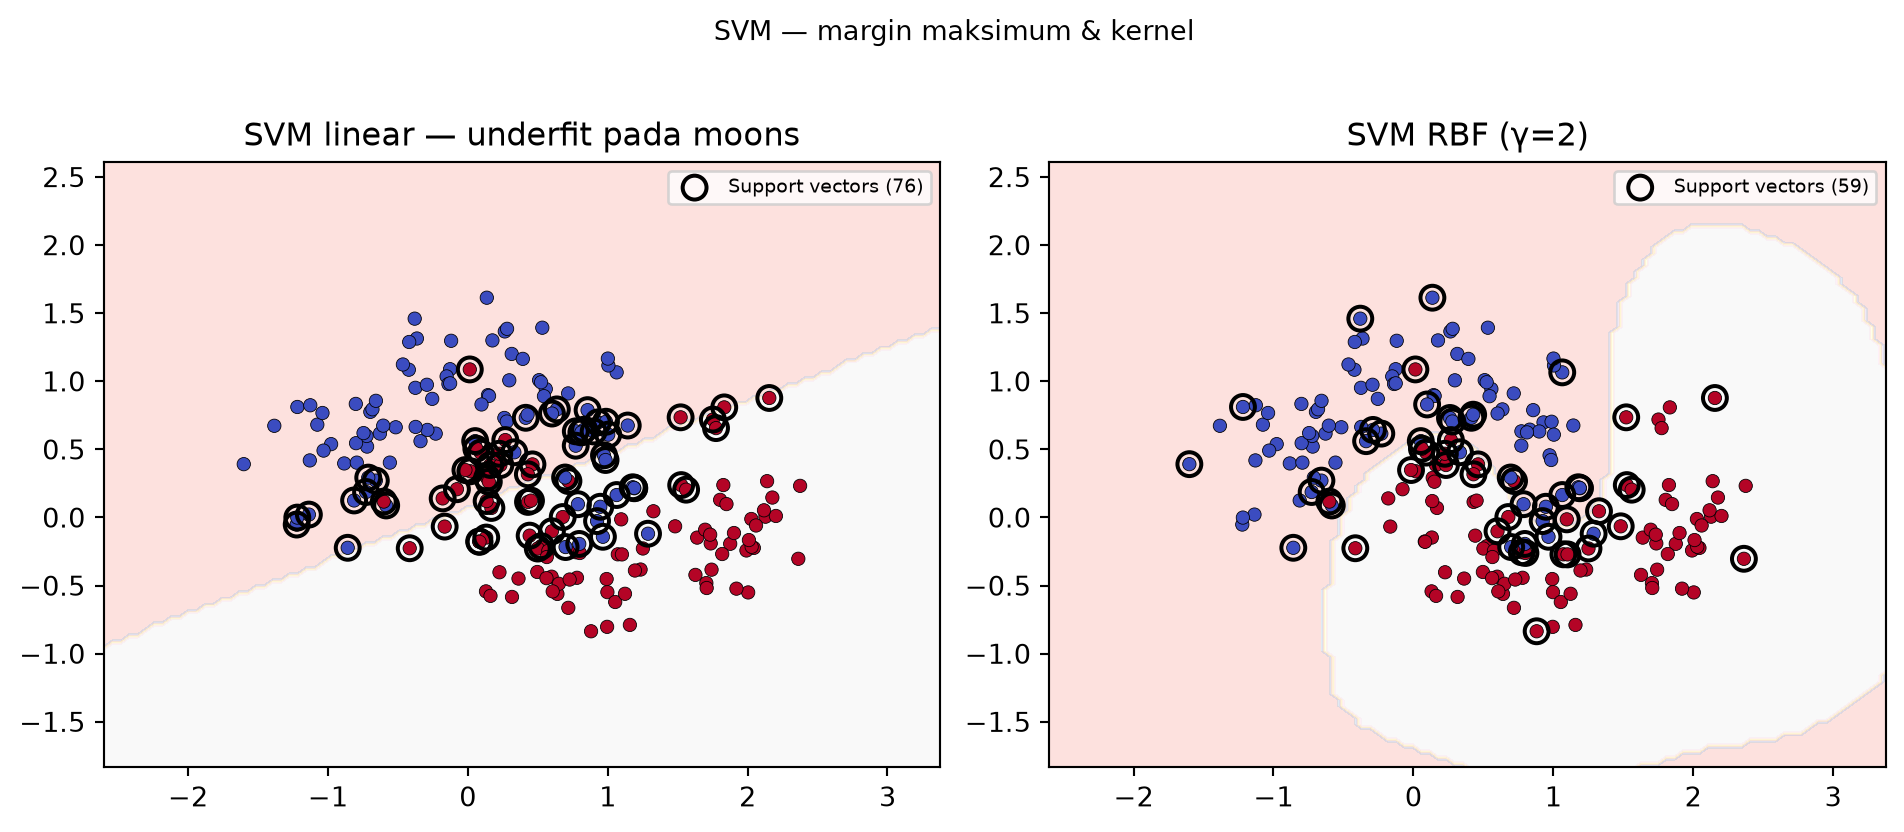
Data tidak linear separable di ruang asli (contoh: dua bulan sabit bersinggungan). Kernel RBF memetakan titik ke dimensi lebih tinggi di mana kelas bisa dipisahkan linear — tanpa menghitung koordinat eksplisit:
Gambar 12: SVM linear gagal pada bulan sabit; SVM RBF menangkap batas non-linear. Lingkaran hitam = support vectors.
Kapan SVM cocok: dataset tidak terlalu besar (kernel RBF mahal \(O(n^2)\)–\(O(n^3)\)), fitur berdimensi sedang–tinggi, butuh batas non-linear. Untuk jutaan baris, gradient boosting atau neural net sering lebih praktis.
13 Neural networks (Bab 12)
Neural network adalah rantai fungsi yang disusun berlapis. Setiap neuron menerima input berbobot, menjumlahkan, lalu menerapkan fungsi aktivasi non-linear — tanpa aktivasi non-linear, jaringan dalam hanya setara satu regresi linear.
Backward pass: propagasi gradien loss ke setiap bobot (backpropagation).
Update bobot dengan gradient descent pada mini-batch.
Contoh: klasifikasi gambar digit — input 784 pixel, hidden 128 neuron, output 10 kelas (0–9). Setiap epoch melihat seluruh data dalam batch kecil; loss turun bertahap.
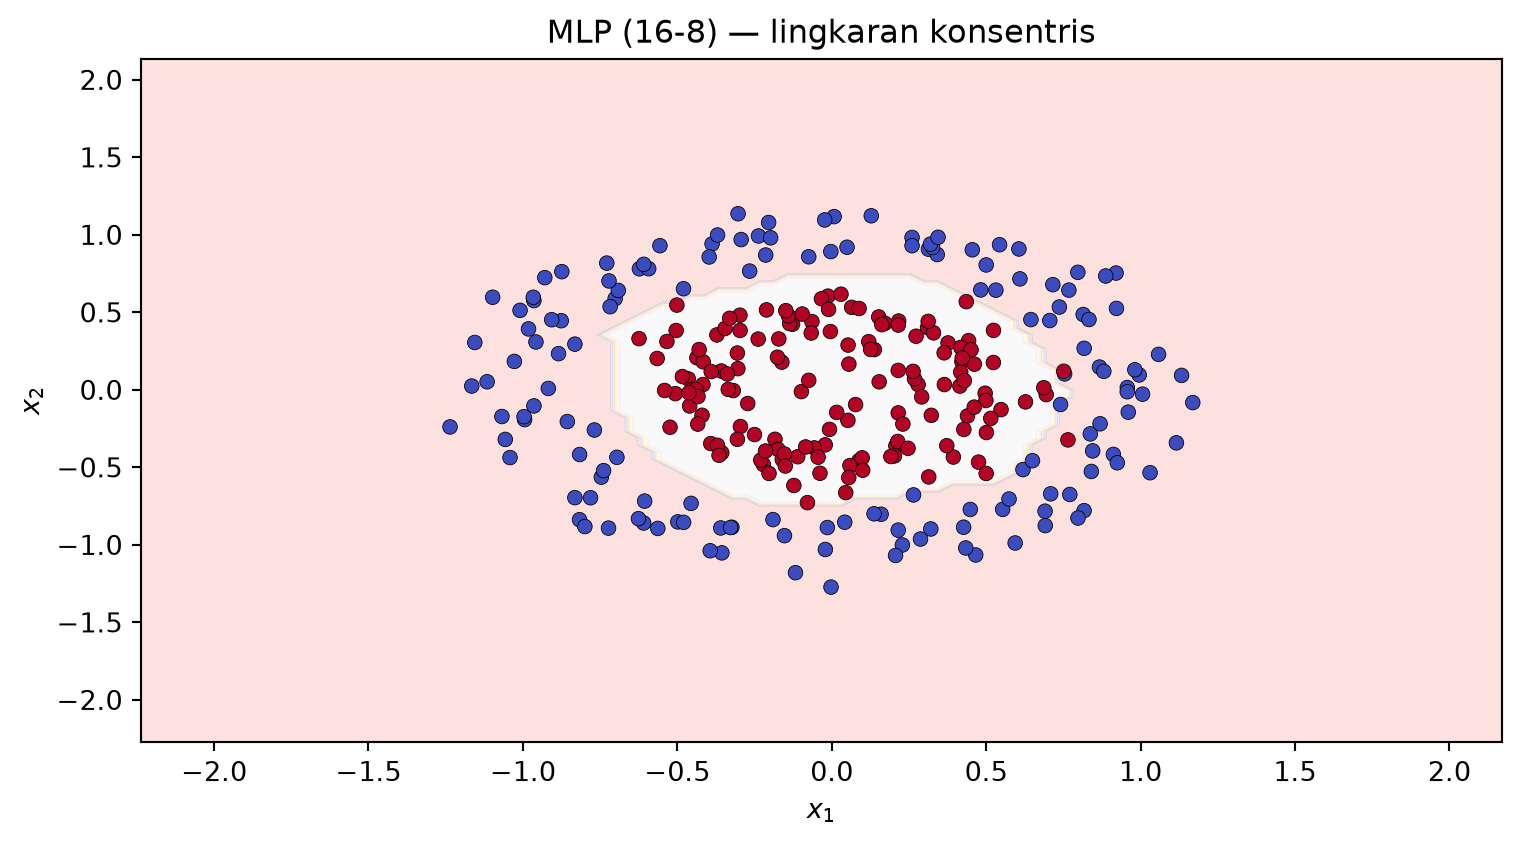
Arsitektur hidden: (16, 8)
Iterasi hingga konvergen: 641
Gambar 13: MLP dengan 2 hidden layer (16-8 neuron) memisahkan lingkaran konsentris — pola non-linear yang sulit untuk regresi logistik linear.
13.2.1 Kapan neural network — dan kapan tidak
Gunakan NN
Pertimbangkan model lebih sederhana
Gambar, audio, teks panjang
Tabel kecil (< 10.000 baris)
Data sangat besar
Butuh interpretabilitas penuh (regulasi)
Pola non-linear kompleks
Baseline linear/logistic sudah cukup baik
Risiko: butuh banyak data, tuning banyak hiperparameter (lapisan, neuron, learning rate, dropout), dan interpretabilitas rendah — sulit menjelaskan ke auditor mengapa satu nasabah ditolak.
14 Studi kasus end-to-end: prediksi tumor jinak vs ganas
Bab 1–12 memperkenalkan konsep dan algoritme secara terpisah. Bab penutup ini menyatukan semuanya dalam satu alur kerja lengkap — dari pertanyaan bisnis hingga laporan evaluasi final — mengikuti protokol StatQuest: set uji dikunci, CV di latih, Pipeline tanpa kebocoran.
14.1 Latar masalah dan definisi skenario
Konteks (fiktif operasional, data nyata): unit patologi rumah sakit ingin model pendukung yang memperkirakan apakah tumor payudara ganas (malignant) atau jinak (benign) berdasarkan 30 pengukuran morfometrik sel dari aspirasi jarum halus (FNAB). Model bukan pengganti dokter — ia membantu prioritas kasus yang perlu pemeriksaan lanjut.
Elemen
Keputusan proyek
Jenis ML
Supervised, klasifikasi biner
Target \(y\)
malignant (1) vs benign (0)
Fitur \(X\)
30 nilai numerik (radius, tekstur, perimeter, …)
Metrik utama
Recall kelas ganas — FN (ganas terlewat) lebih berbahaya daripada FP
Metrik pendukung
Precision, F1, ROC-AUC
Baseline
Selalu prediksi kelas mayoritas (jinak)
Dataset: Wisconsin Breast Cancer (sklearn) — 569 observasi, 212 ganas (37%), 357 jinak (63%). Cukup kecil untuk diajar, cukup kaya untuk membandingkan beberapa algoritme Bab 6–11.
Bentuk data: (569, 32)

Distribusi kelas:
label_name
benign       357
malignant    212
Name: count, dtype: int64

Proporsi ganas: 0.373

Contoh 3 baris (5 fitur pertama):
   mean radius  mean texture  mean perimeter  mean area  mean smoothness  mean compactness
0        17.99         10.38           122.8     1001.0          0.11840           0.27760
1        20.57         17.77           132.9     1326.0          0.08474           0.07864
2        19.69         21.25           130.0     1203.0          0.10960           0.15990

Missing values: 0
Membaca output: tidak ada missing — langkah imputasi tidak diperlukan. Kelas tidak seimbang 37/63 — accuracy saja bisa menipu; gunakan stratified split dan metrik yang sensitif terhadap kelas minoritas (ganas).
14.3 Langkah 2 — EDA: statistik deskriptif dan korelasi
Explorasi data memvalidasi asumsi Bab 3: fitur numerik, rentang berbeda-beda (perlu penskalaan), dan beberapa fitur saling berkorelasi.
import matplotlib.pyplot as pltimport numpy as npfeature_cols = cancer.feature_namesX_all = df[feature_cols]summary = X_all.describe().T[["mean", "std", "min", "max"]].round(2)print("Ringkasan 5 fitur pertama:")print(summary.head().to_string())# Korelasi fitur dengan target (point-biserial via pearson pada 0/1)corr_target = X_all.apply(lambda col: np.corrcoef(col, df["target"])[0, 1])top5 = corr_target.abs().sort_values(ascending=False).head(5)print("\n5 fitur paling berkorelasi dengan target (|r|):")for feat, r in top5.items():print(f" {feat[:30]:30s} r = {corr_target[feat]:+.3f}")
Ringkasan 5 fitur pertama:
                   mean     std     min      max
mean radius       14.13    3.52    6.98    28.11
mean texture      19.29    4.30    9.71    39.28
mean perimeter    91.97   24.30   43.79   188.50
mean area        654.89  351.91  143.50  2501.00
mean smoothness    0.10    0.01    0.05     0.16

5 fitur paling berkorelasi dengan target (|r|):
  worst concave points            r = -0.794
  worst perimeter                 r = -0.783
  mean concave points             r = -0.777
  worst radius                    r = -0.776
  mean perimeter                  r = -0.743
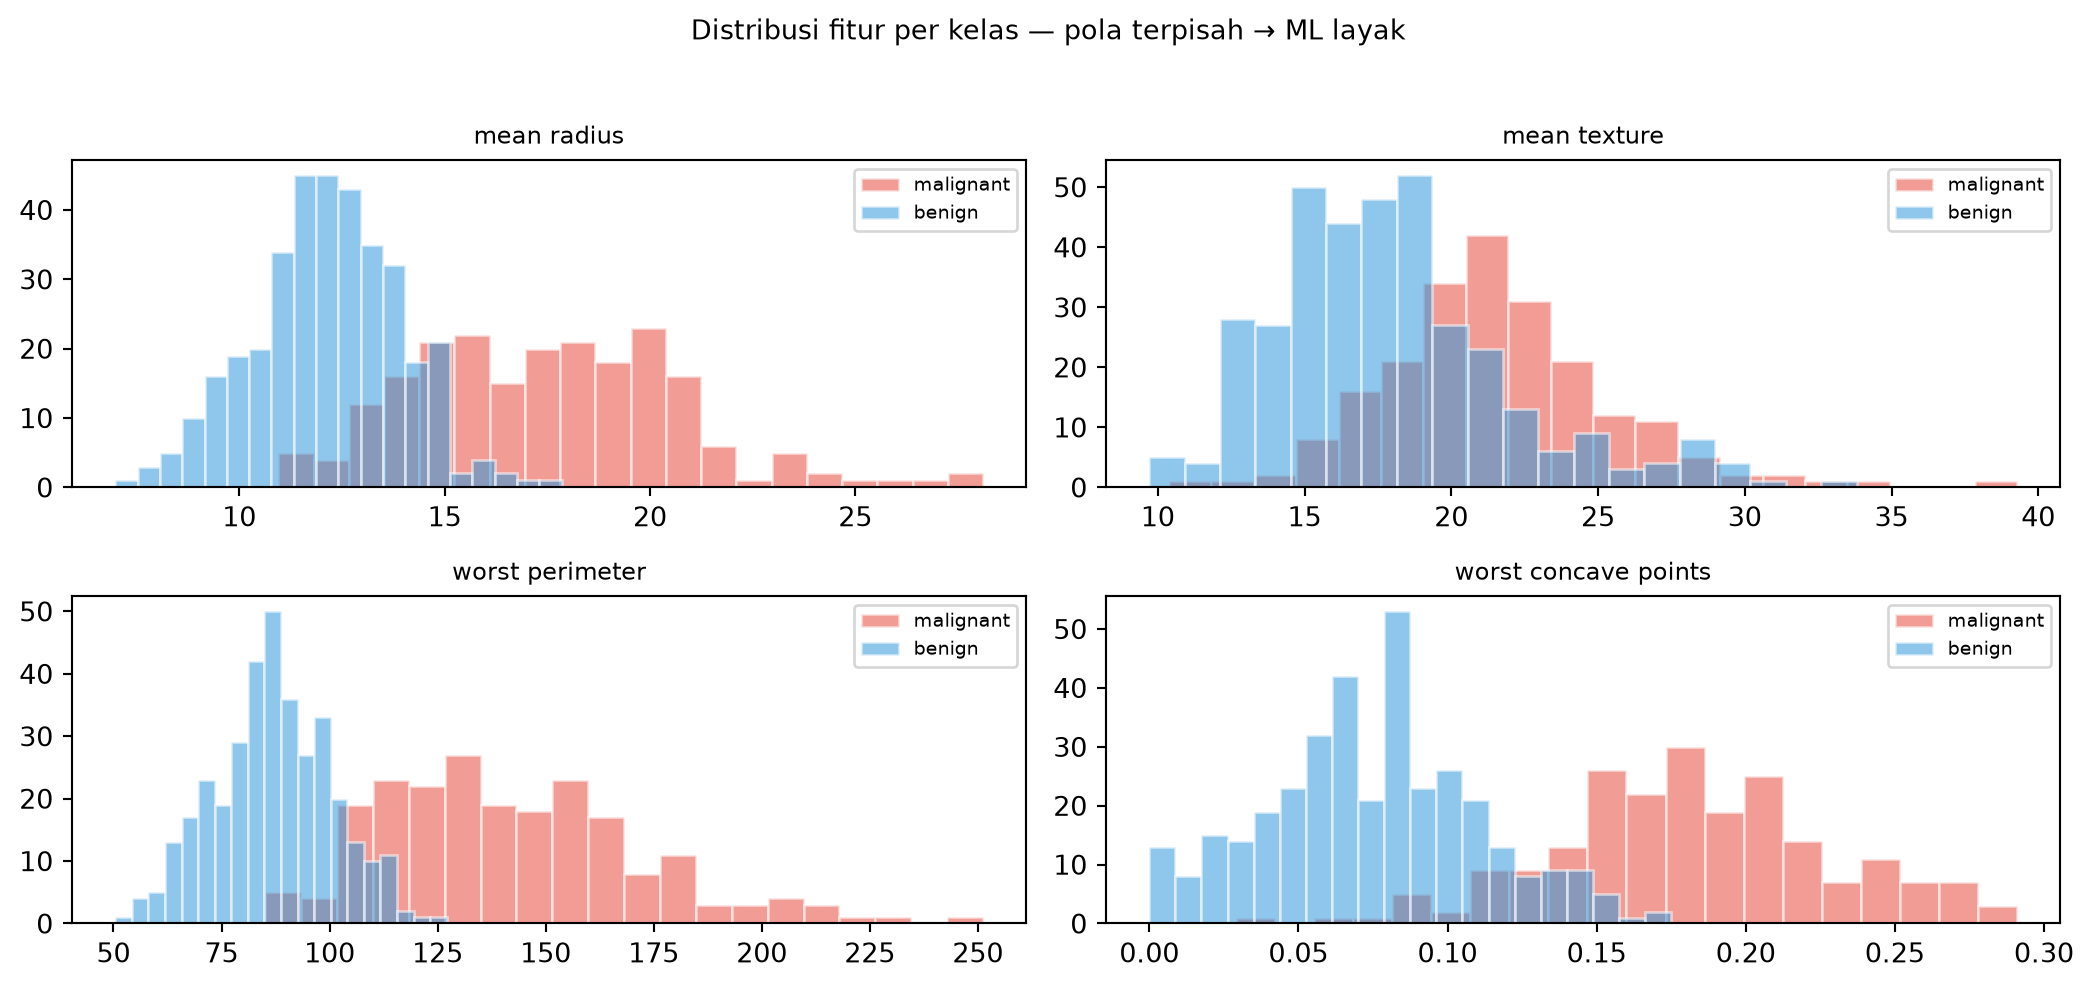
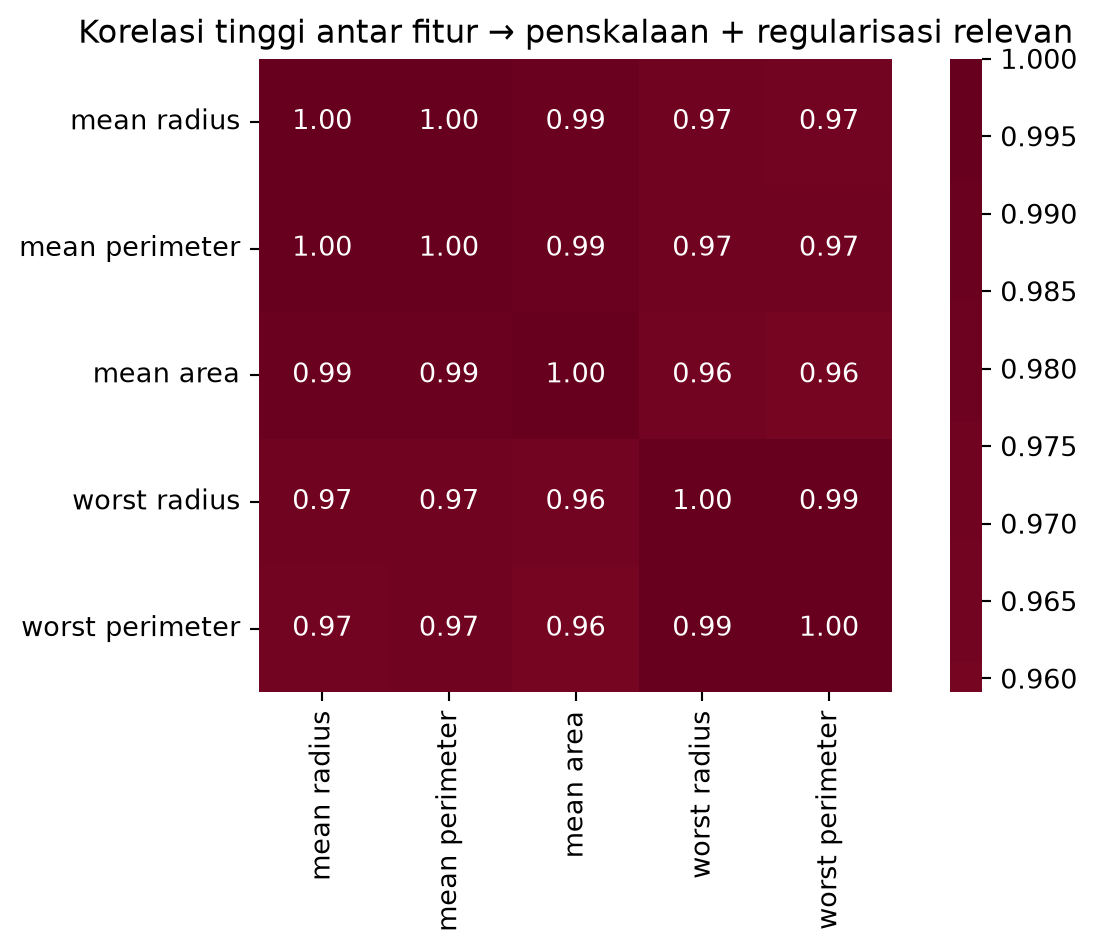
EDA: histogram fitur utama per kelas (ganas vs jinak) dan heatmap korelasi antar fitur terkait.
Temuan EDA:
Fitur worst concave points dan worst perimeter kuat memisahkan kelas — sel ganas cenderung punya nilai lebih tinggi.
mean radius, mean perimeter, mean area sangat berkorelasi (\(r > 0{,}9\)) — multikolinearitas; model linear tetap bisa dipakai dengan StandardScaler; pohon/SVM juga perlu skala untuk beberapa kernel.
Tidak ada kebocoran waktu: semua fitur dari pengukuran yang sama dengan label — aman untuk skenario prediksi simultan.
Ukuran latih / uji: 426 / 143

Baseline — selalu prediksi 'benign':
  Accuracy: 0.6294
  Balanced acc.: 0.5
  Recall malignant: 0.0
  F1 macro: 0.3863

→ Recall malignant = 0: model baseline TIDAK PERNAH mendeteksi ganas.
Pelajaran: accuracy baseline ≈ 63% (proporsi jinak di uji) tetapi recall ganas = 0 — model ML harus secara nyata mengalahkan baseline pada recall malignant dan balanced accuracy.
14.5 Langkah 4 — Pipeline, kandidat model, dan cross-validation
Semua model dibungkus Pipeline dengan StandardScaler agar tidak ada kebocoran: scaler fit hanya di fold latih CV.
Prioritaskan CV Recall malignant — sesuai biaya FN di rumah sakit.
Jika recall seri, bandingkan ROC-AUC dan F1 macro.
Pertimbangkan interpretabilitas — Logistic Regression / Decision Tree lebih mudah diaudit daripada RBF SVM.
14.6 Langkah 5 — Latih model terpilih dan evaluasi final di set uji
Asumsikan Logistic Regression atau model teratas CV dipilih. Di bawah, kita latih dua model teratas untuk demonstrasi laporan final — hanya sekali di set uji.
Model terbaik menurut CV: Logistic Regression

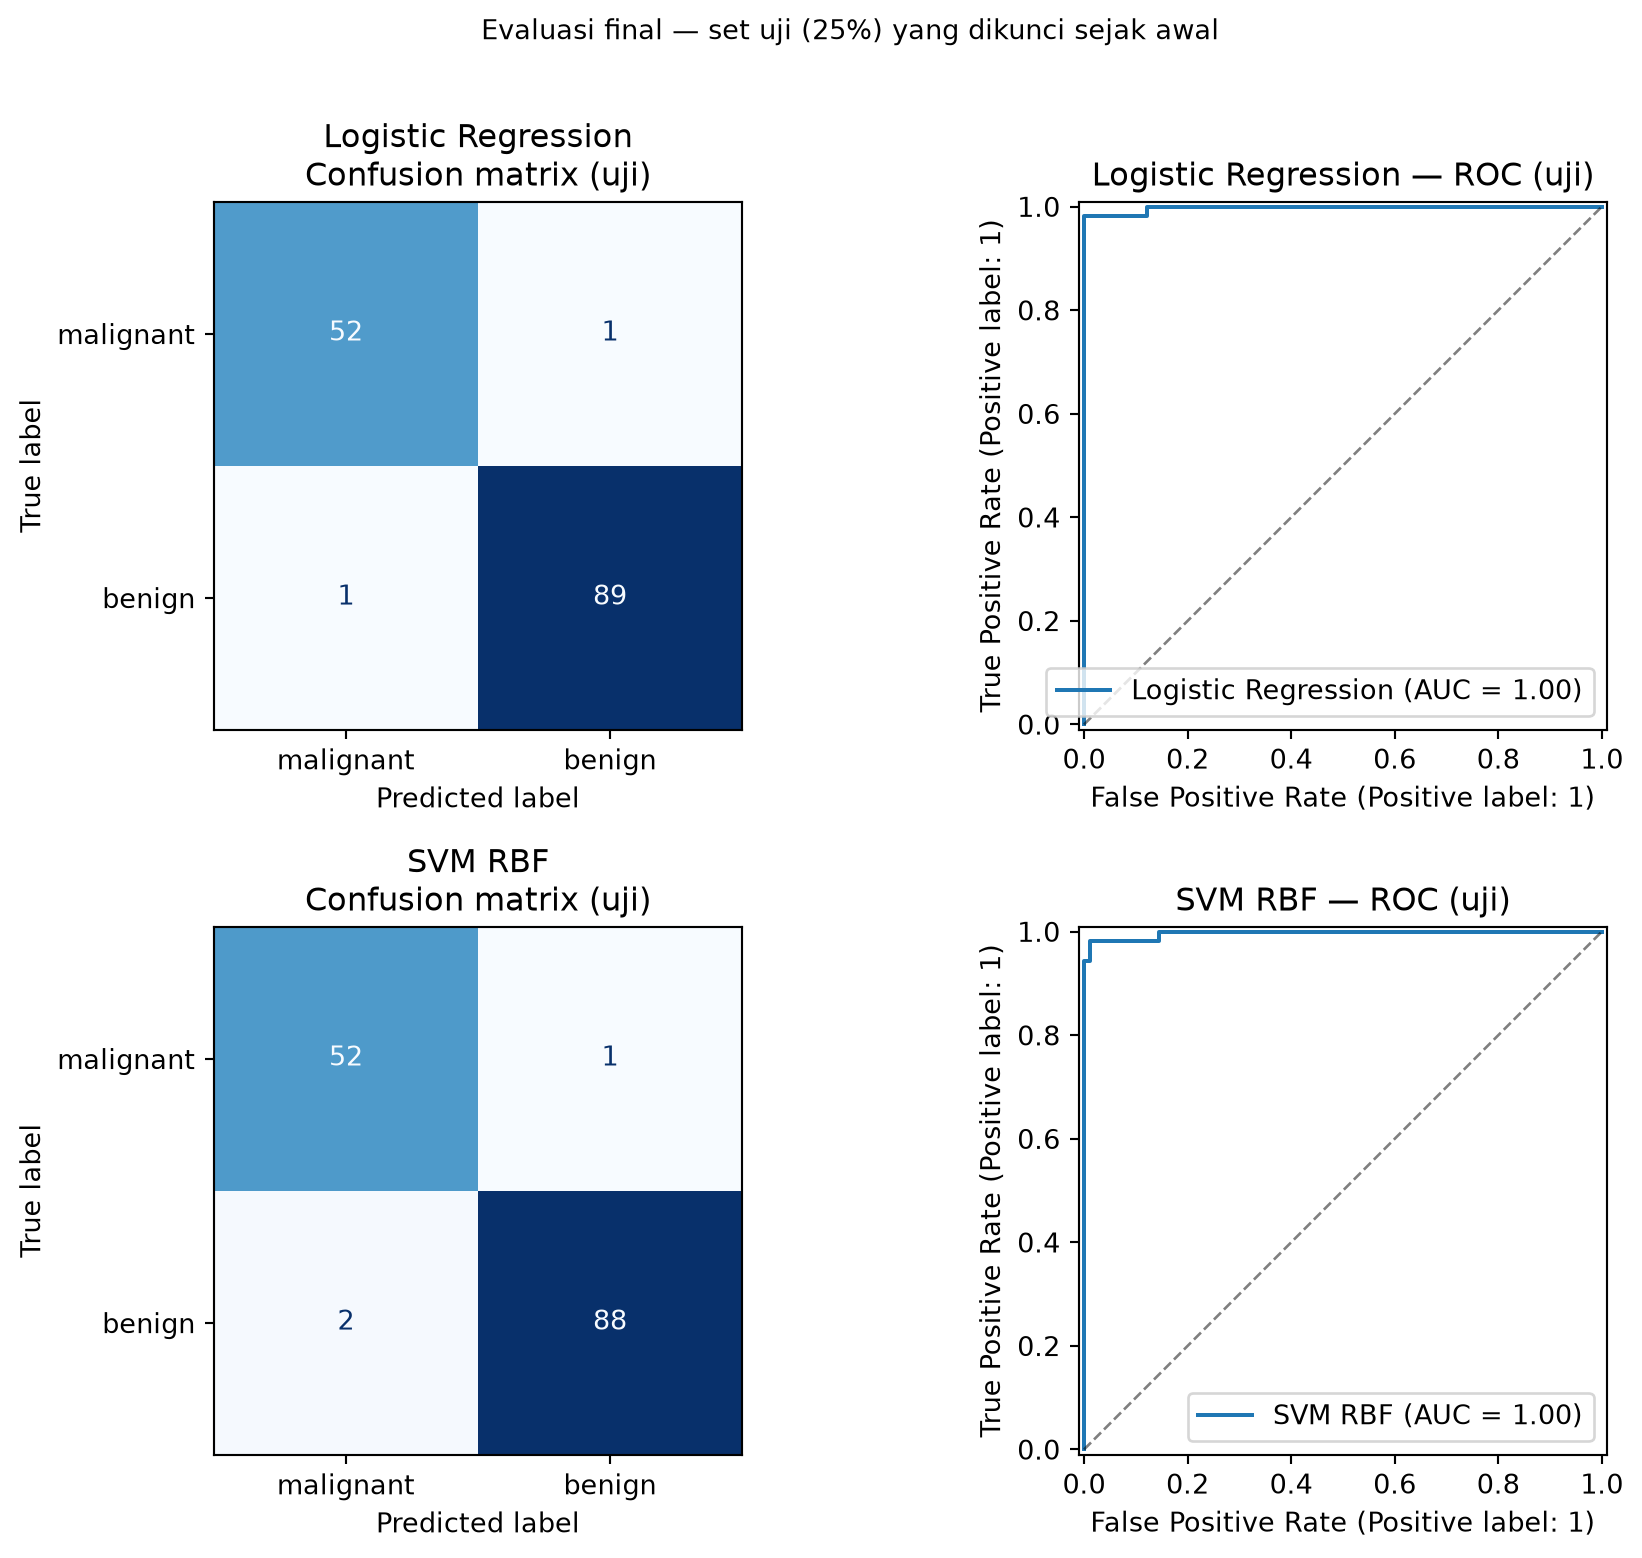
=== Perbandingan final di SET UJI ===
              Model  Accuracy  Balanced acc.  Recall malignant  F1 macro  ROC-AUC (malignant)
Logistic Regression     0.986         0.9850            0.9811    0.9850               0.9977
            SVM RBF     0.979         0.9795            0.9811    0.9776               0.9969

=== Classification report — Logistic Regression (uji) ===
              precision    recall  f1-score   support

   malignant     0.9811    0.9811    0.9811        53
      benign     0.9889    0.9889    0.9889        90

    accuracy                         0.9860       143
   macro avg     0.9850    0.9850    0.9850       143
weighted avg     0.9860    0.9860    0.9860       143
Membaca confusion matrix:
FN (kanan atas): ganas diprediksi jinak — paling berbahaya; minimalkan dengan threshold atau model recall tinggi.
FP (kiri bawah): jinak diprediksi ganas — menambah pemeriksaan lanjut, biaya lebih rendah.
Threshold operasional:predict_proba default threshold 0,5 bisa digeser — misalnya prediksi ganas jika \(P(\text{malignant}) > 0{,}35\) untuk recall lebih tinggi (trade-off precision).
Human-in-the-loop — model hanya pendukung, bukan keputusan otomatis.
Dokumentasi — versi data, seed, hiperparameter, metrik uji, tanggal evaluasi.
Kesimpulan pedagogis: studi kasus ini menerapkan Bab 1 (supervised, train/test), Bab 2 (CV), Bab 3 (korelasi), Bab 6 (logistic), Bab 7 (Naive Bayes), Bab 8 (confusion matrix, ROC), Bab 9 (implisit via regularisasi di logistic C), Bab 10–11 (pohon, SVM, RF), dalam satu narasi koheren — pola yang sama bisa Anda ulangi pada dataset regresi (mis. prediksi harga rumah) dengan RMSE sebagai metrik utama.
15 Ringkasan alur pembelajaran ML
Definisikan masalah — regresi/klasifikasi? apa biaya FN vs FP?
Kumpulkan data — pastikan fitur tersedia saat inferensi.
Baseline — rata-rata / kelas mayoritas / Naive Bayes sederhana.
Pisahkan latih / uji — kunci uji.
Latih kandidat — linear → pohon → SVM → NN (naik kompleksitas jika perlu).
Tuning hiperparameter via cross-validation di latih.
Evaluasi final di uji — metrik yang disepakati stakeholder.
Deploy & monitor — drift data bisa menurunkan performa seiring waktu.
16 Latihan konseptual
Jelaskan perbedaan supervised dan unsupervised dengan satu contoh di bidang kesehatan dan satu di ritel.
Sebuah model polinomial derajat 15 mencapai \(R^2 = 0{,}99\) di latih tetapi \(R^2 = 0{,}45\) di uji. Diagnosis? Tiga langkah mitigasi?
Dataset churn: 95% tidak churn, 5% churn. Model selalu prediksi “tidak churn” — berapa accuracy? Apa masalahnya? Metrik apa yang lebih tepat?
Pada 5-fold CV dengan 500 sampel latih, berapa ukuran fold validasi? Mengapa stratify penting untuk klasifikasi pinjaman macet?
Dua fitur punya \(r = 0{,}92\). Apa implikasinya untuk OLS? Metode Bab 9 mana yang membantu?
Filter spam Naive Bayes: mengapa asumsi independensi kata naïf tetapi model tetap bisa berguna?
Bandingkan precision dan recall untuk skrining diabetes — metrik mana yang Anda prioritaskan dan mengapa?
SVM linear vs RBF pada data bulan sabit — jelaskan perbedaan batas keputusan.
Sebutkan tiga hiperparameter MLP dan efeknya jika nilainya terlalu besar/kecil.
Kapan Anda memilih pohon keputusan tunggal daripada Random Forest?
Pada studi kasus tumor: mengapa baseline “selalu jinak” punya accuracy ~63% tetapi recall ganas = 0? Model ML mana yang Anda deploy jika FN sangat mahal?
Jelaskan mengapa StandardScaler harus berada di dalamPipeline, bukan dihitung dari train + test sekaligus.
17 Referensi
Starmer, J. (2022). The StatQuest Illustrated Guide to Machine Learning!!! StatQuest Publications. PDF lokal: 610435041-The-StatQuest-Illustrated-Guide-to-Machine-Learning-Josh-Starmer.pdf.
StatQuest YouTube: StatQuest with Josh Starmer — video pendamping per bab (Linear Regression, Gradient Descent, Logistic Regression, dll.).