Metrik evaluasi & cross-validation model prediktif
Data Science — pertemuan ke-11
Penulis
Anggit Wirasto, S.Si., M.Eng.
Setelah model regresi atau klasifikasi dilatih, fokus bergeser ke evaluasi: seberapa baik model generalisasi pada data baru, dan metrik mana yang selaras dengan konteks bisnis. Modul ini membahas metrik regresi (MAE, RMSE, \(R^2\)), metrik klasifikasi (confusion matrix, precision, recall, F1, ROC & AUC), serta cross-validation untuk estimasi performa dan tuning hiperparameter tanpa mengutak-atik set uji.
Prasyarat: regresi (DS-09) dan klasifikasi (DS-10).
0.1 Tujuan pembelajaran
Setelah mempelajari materi ini, mahasiswa diharapkan mampu:
Menghitung dan menginterpretasikan metrik regresi: MAE, RMSE, dan \(R^2\) pada data uji, serta memilih metrik yang selaras dengan konteks bisnis.
Membaca confusion matrix dan menghitung accuracy, precision, recall, dan F1-score (kasus biner dan multi-kelas); membangun dan menginterpretasikan kurva ROC serta AUC untuk model probabilistik.
Merancang protokol cross-validation untuk estimasi performa yang stabil dan memilih hiperparameter tanpa menyentuh set uji.
10 contoh kasus pembacaan metrik (regresi + klasifikasi + AUC)
9.3
Cross-validation
2 Landasan evaluasi
Algoritme menjawab bagaimana mempelajari \(f(x)\) dari data latih; evaluasi menjawab seberapa baik\(f\) bekerja pada observasi baru. Prinsip utamanya: ukur performa pada Testing Data — data yang belum pernah dipakai saat latih.
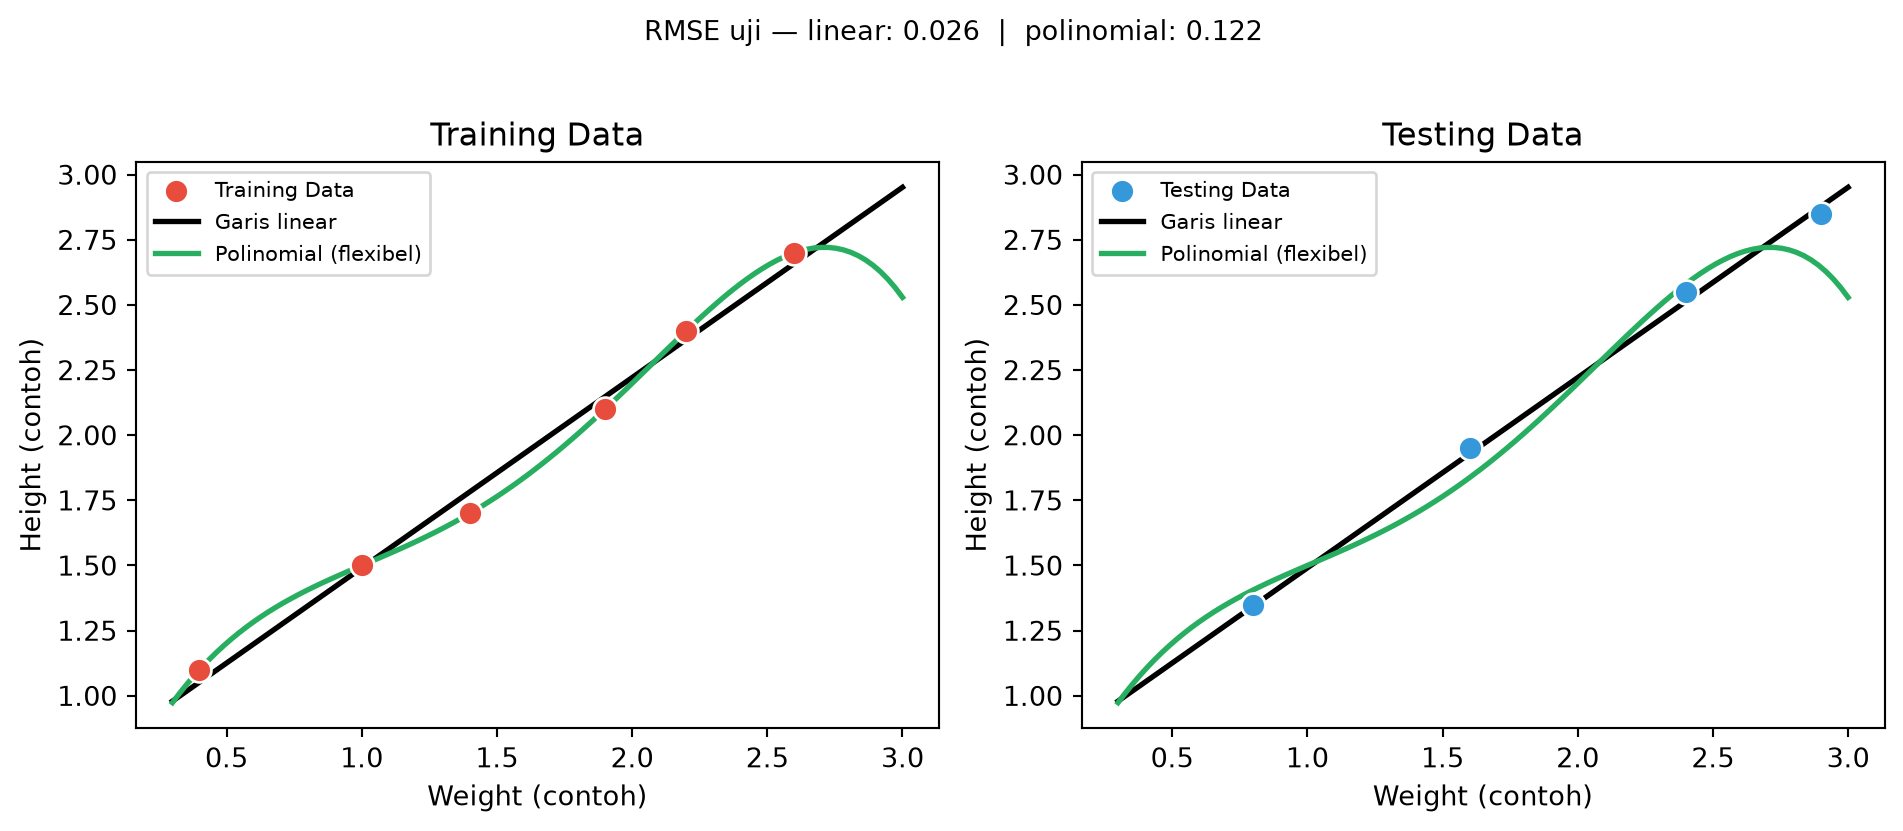
Gambaran overfitting: model sederhana (garis linear) versus model sangat fleksibel (kurva berliku). Yang fleksibel sering pas sempurna di latih tetapi meleset besar di uji — model “menghafal” noise, bukan pola generik.
Subset
Makna
Peran
Training Data
data untuk menyesuaikan parameter model
latih garis/pohon/SVM, dll.
Testing Data
data baru yang tidak dipakai saat latih
estimasi generalisasi; mendeteksi overfitting
Data leakage — memakai data yang sama untuk latih dan uji — membuat skor terlihat lebih baik dari kenyataan. Untuk tuning hiperparameter, gunakan cross-validation di dalam train (bab 9.3), bukan set uji.
Gambar 1: Garis linear (hitam) vs polinomial derajat tinggi (hijau) pada latih (merah) dan uji (biru). Model fleksibel overfit — error total di uji jauh lebih besar.
Kesimpulan: pilih model berdasarkan error di Testing Data, bukan skor latih.
2.1 Protokol evaluasi
Tetapkan metrik utama (dan metrik pendukung) sebelum melihat hasil uji.
Pisahkan set latih / uji (atau validasi) — set uji dikhususkan untuk laporan akhir.
Semua transformasi (skala, imputasi, encoding) → fit di set latih, transform di set uji (Pipeline).
Tuning hiperparameter → cross-validation di latih, bukan mengulang skor test.
3 Metrik evaluasi regresi (9.1)
Regresi linear dilatih dengan meminimalkan jumlah kuadrat residual pada data latih; pada set uji kita mengukur seberapa dekat prediksi \(\hat{y}_i\) dengan nilai aktual \(y_i\). Selisih per observasi disebut residual:
\[
e_i = y_i - \hat{y}_i
\]
Cara membaca notasi umum.
\(y_i\) — nilai target aktual observasi ke-\(i\) (contoh: harga rumah dalam juta Rp, konsumsi kWh).
\(\hat{y}_i\) — prediksi model untuk observasi yang sama (dibaca “y-hat”).
\(i = 1,\ldots,n\) — indeks observasi; \(n\) biasanya ukuran set uji (bukan latih).
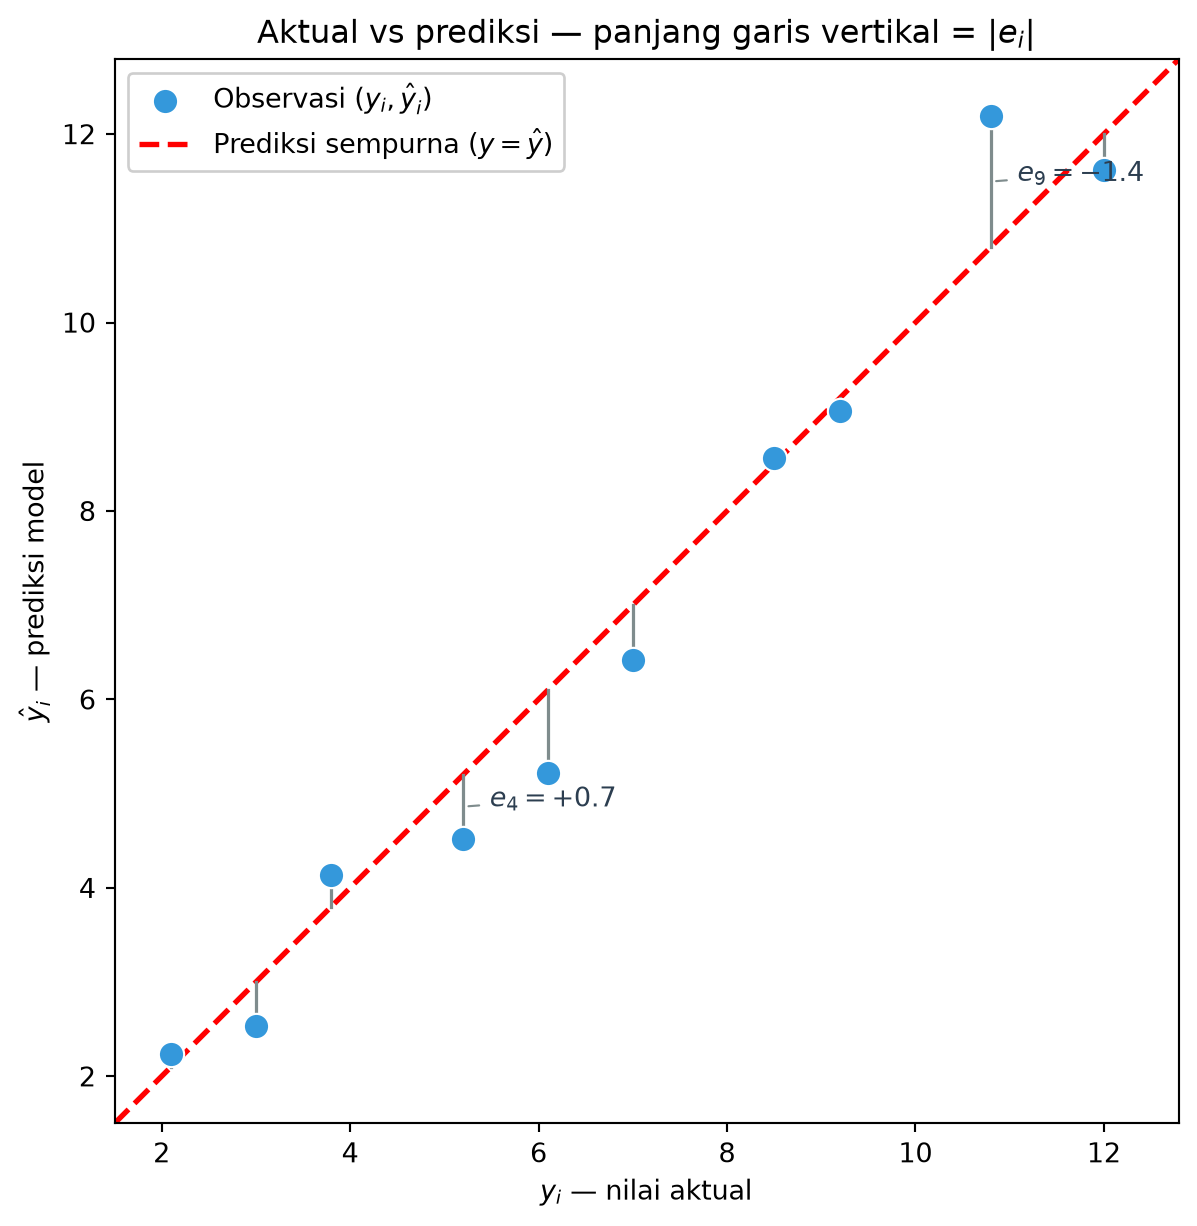
\(e_i > 0\) → model underestimate (prediksi terlalu rendah); \(e_i < 0\) → overestimate.
import matplotlib.pyplot as pltimport numpy as nprng = np.random.default_rng(42)y = np.array([2.1, 3.0, 3.8, 5.2, 6.1, 7.0, 8.5, 9.2, 10.8, 12.0], dtype=float)yhat = y + rng.normal(0, 0.45, size=len(y))yhat[3] -=1.1# underestimate: ŷ di bawah garis identitasyhat[8] +=1.4# overestimate: ŷ di atas garis identitasfig, ax = plt.subplots(figsize=(7, 6.5))ax.scatter( y, yhat, s=90, color="#3498db", edgecolors="white", linewidths=0.8, zorder=3, label="Observasi $(y_i, \\hat{y}_i)$",)lo =min(y.min(), yhat.min()) -0.6hi =max(y.max(), yhat.max()) +0.6ax.plot([lo, hi], [lo, hi], "r--", linewidth=2, label="Prediksi sempurna ($y = \\hat{y}$)")for yi, yhi inzip(y, yhat): ax.plot([yi, yi], [yhi, yi], color="#7f8c8d", linewidth=1.2, zorder=2)for idx in [3, 8]: ei = y[idx] - yhat[idx] mid_y = (yhat[idx] + y[idx]) /2 ax.annotate(f"$e_{{{idx +1}}} = {ei:+.1f}$", xy=(y[idx], mid_y), xytext=(10, 0), textcoords="offset points", fontsize=10, color="#2c3e50", arrowprops=dict(arrowstyle="-", color="#7f8c8d", lw=0.8), )ax.set_xlabel("$y_i$ — nilai aktual")ax.set_ylabel("$\\hat{y}_i$ — prediksi model")ax.set_xlim(lo, hi)ax.set_ylim(lo, hi)ax.set_aspect("equal", adjustable="box")ax.legend(loc="upper left", framealpha=0.95)ax.set_title("Aktual vs prediksi — panjang garis vertikal = $|e_i|$")plt.tight_layout()
Gambar 2: Scatter \(y_i\) vs \(\hat{y}_i\): garis putus-putus merah = prediksi sempurna (\(y = \hat{y}\)). Garis vertikal abu-abu = residual \(e_i = y_i - \hat{y}_i\); titik di bawah garis identitas → \(e_i > 0\) (underestimate), di atas → \(e_i < 0\) (overestimate).
Pada grafik di atas, semakin dekat titik ke garis identitas \(y = \hat{y}\), semakin kecil \(|e_i|\).
Tiga metrik agregat yang paling lazim: MAE, RMSE, dan \(R^2\).
Cara membaca rumus MAE. Jumlahkan nilai absolut selisih prediksi–aktual untuk semua observasi uji, lalu bagi \(n\) → rata-rata besar meleset tanpa mempedulikan arah ( atas/bawah).
Simbol
Makna
\(\|y_i - \hat{y}_i\|\)
kesalahan absolut observasi ke-\(i\); selalu \(\geq 0\)
\(\sum_{i=1}^n\)
jumlahkan over \(n\) observasi uji
\(\frac{1}{n}\)
rata-rata aritmetika → satuan MAE sama dengan\(y\)
Interpretasi. MAE = 50 (kWh) artinya rata-rata, prediksi meleset sekitar 50 kWh. Metrik ini robust terhadap outlier moderat (error besar dihitung linear).
Cara membaca rumus RMSE. Kuadratkan setiap residual \((y_i - \hat{y}_i)^2\) (menghapus tanda ± sekaligus menghukum error besar lebih berat), rata-rata hasil kuadrat → Mean Squared Error (MSE), lalu ambil akar kuadrat agar satuan kembali sama dengan \(y\).
Simbol
Makna
\((y_i - \hat{y}_i)^2\)
kuadrat residual; error 10× lebih besar → kontribusi 100× lebih besar
\(\sqrt{\cdot}\)
mengembalikan satuan ke satuan \(y\) (juta Rp, kWh, …)
MSE (tanpa akar)
\(\mathrm{MSE} = \frac{1}{n}\sum (y_i - \hat{y}_i)^2\) — fungsi loss yang dioptimalkan OLS
Interpretasi. RMSE selalu \(\geq\) MAE. Jika RMSE jauh lebih besar dari MAE, ada prediksi ekstrem yang meleset — selaras dengan loss kuadrat yang dioptimalkan OLS/Ridge.
Implementasi scikit-learn:mean_squared_error(y_true, y_pred, squared=False) atau np.sqrt(mean_squared_error(...)).
dengan \(\bar{y} = \frac{1}{n}\sum_i y_i\) = rata-rata target pada set yang sama (umumnya uji).
Cara membaca rumus \(R^2\). Bandingkan kesalahan kuadrat model (pembilang) dengan kesalahan kuadrat baseline “tebak rata-rata \(\bar{y}\) saja” (penyebut). Jika model jauh lebih baik dari baseline, rasio mendekati 0 dan \(R^2\) mendekati 1.
Simbol
Makna
\(\sum_i (y_i - \hat{y}_i)^2\)
SS\(_{\mathrm{res}}\) — total kuadrat residual model (sisa yang belum terjelaskan)
\(\sum_i (y_i - \bar{y})^2\)
SS\(_{\mathrm{tot}}\) — total variasi \(y\) di sekitar rata-ratanya
outlier moderat; laporan “rata-rata salah X rupiah/kWh”
RMSE
sama dengan \(y\)
residual besar dihukum kuadrat
selaras dengan optimasi MSE; penalti ekstrem lebih berat
\(R^2\)
tanpa satuan (skala 0–1, bisa negatif)
proporsi varians terjelaskan
perbandingan model pada dataset yang sama
MAE dan RMSE mengukur besar error (satuan \(y\)); \(R^2\) mengukur proporsi variasi relatif terhadap baseline — ketiganya melengkapi satu sama lain.
3.4.1 Contoh kasus 1 — Prediksi tagihan listrik rumah tangga (prioritas MAE)
Perusahaan utilitas melatih model regresi untuk memperkirakan konsumsi listrik bulan depan (satuan kWh). Manajer operasional ingin menjawab pertanyaan sederhana: “Rata-rata, prediksi kita meleset berapa kWh per pelanggan?” — bukan memaksimalkan penalti kuadrat.
Tabel berikut menampilkan delapan rumah tangga pada set uji (data sintetis dengan pola realistis; angka dibulatkan):
import numpy as npimport pandas as pdfrom sklearn.metrics import mean_absolute_error, mean_squared_errorrng = np.random.default_rng(7)aktual_kwh = np.array([210, 285, 340, 410, 520, 610, 780, 920], dtype=float)# Model cukup baik; error kecil–sedang, tanpa outlier ekstremprediksi_kwh = aktual_kwh + rng.integers(-35, 36, size=len(aktual_kwh))df_listrik = pd.DataFrame( {"ID pelanggan": [f"RT-{i:03d}"for i inrange(1, 9)],"Aktual (kWh)": aktual_kwh.astype(int),"Prediksi (kWh)": prediksi_kwh.astype(int),"|Error| (kWh)": np.abs(aktual_kwh - prediksi_kwh).astype(int), })mae1 = mean_absolute_error(aktual_kwh, prediksi_kwh)rmse1 =float(np.sqrt(mean_squared_error(aktual_kwh, prediksi_kwh)))df_listrik
Tabel 1: Contoh kasus 1 — prediksi konsumsi listrik (kWh/bulan): aktual vs prediksi model regresi.
ID pelanggan
Aktual (kWh)
Prediksi (kWh)
|Error| (kWh)
0
RT-001
210
242
32
1
RT-002
285
294
9
2
RT-003
340
353
13
3
RT-004
410
438
28
4
RT-005
520
526
6
5
RT-006
610
630
20
6
RT-007
780
804
24
7
RT-008
920
900
20
import matplotlib.pyplot as pltfig, axes = plt.subplots(1, 2, figsize=(10, 4))ids = df_listrik["ID pelanggan"]errs = df_listrik["|Error| (kWh)"]axes[0].bar(ids, errs, color="#3498db", edgecolor="white")axes[0].axhline(mae1, color="#e74c3c", linestyle="--", linewidth=1.5, label=f"MAE = {mae1:.0f} kWh")axes[0].set_ylabel("Kesalahan absolut (kWh)")axes[0].set_title("Tagihan listrik — |error| per pelanggan")axes[0].tick_params(axis="x", rotation=45)axes[0].legend()metrics = ["MAE", "RMSE"]vals = [mae1, rmse1]colors = ["#3498db", "#9b59b6"]axes[1].bar(metrics, vals, color=colors, edgecolor="white", width=0.5)axes[1].set_ylabel("kWh")axes[1].set_title(f"Metrik agregat (RMSE/MAE = {rmse1/mae1:.2f})")for i, v inenumerate(vals): axes[1].text(i, v +1.5, f"{v:.0f}", ha="center", fontsize=11)plt.tight_layout()
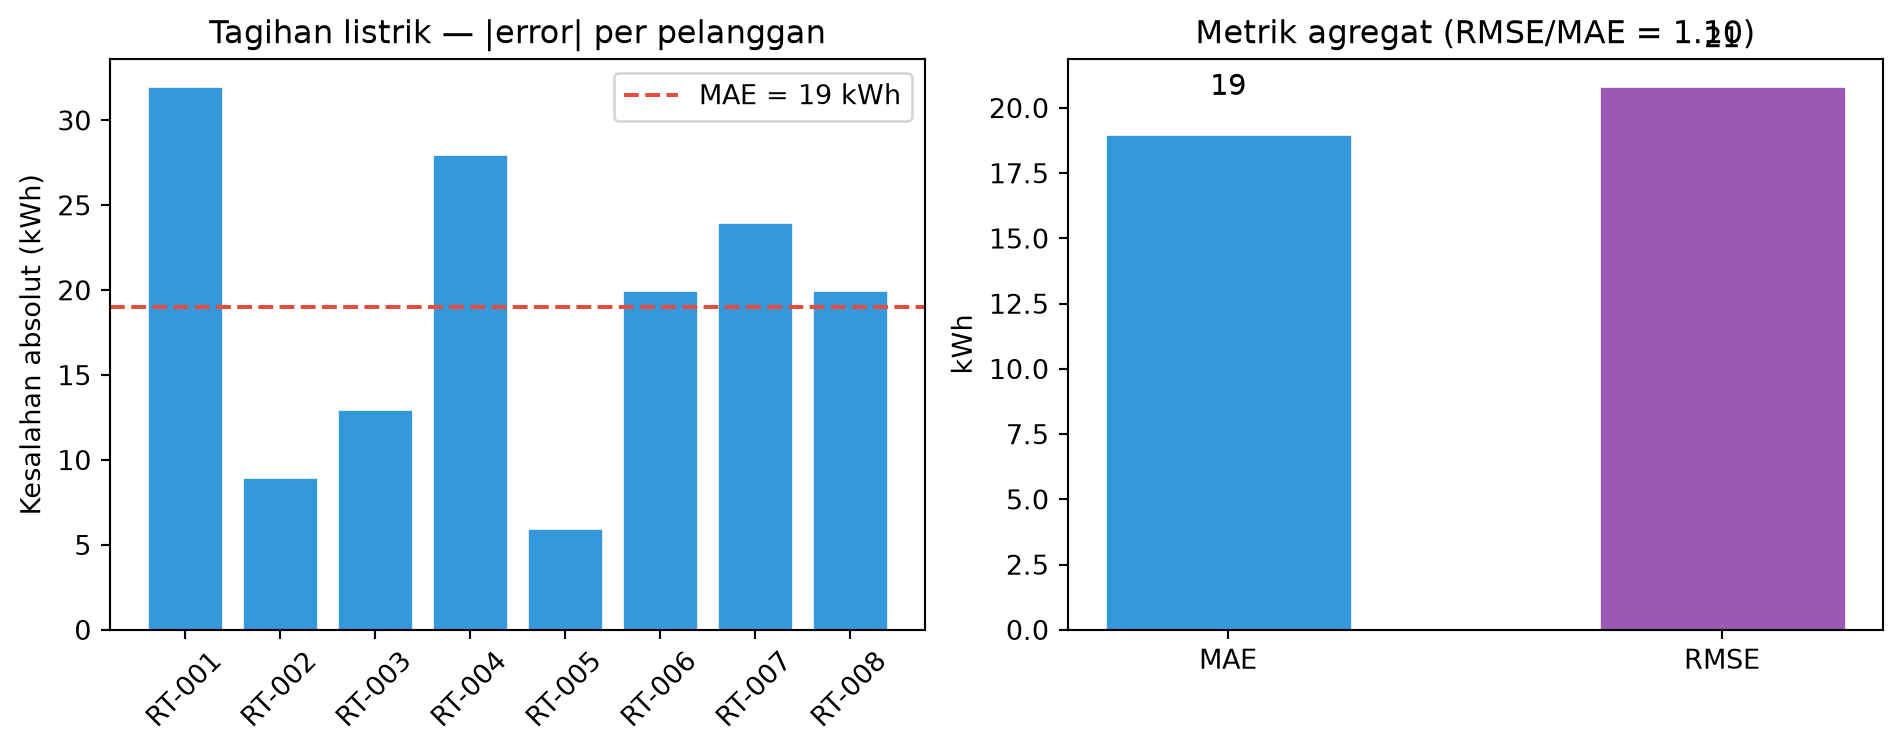
Gambar 3: Kiri: |error| per pelanggan — skala linear, mudah dibaca stakeholder. Kanan: MAE vs RMSE; rasio RMSE/MAE ≈ 1,2 menandakan tidak ada outlier prediksi yang dominan.
Interpretasi: MAE (satuan kWh, sama dengan target) langsung terbaca sebagai rata-rata meleset per pelanggan. RMSE hanya sedikit di atas MAE — rasio RMSE/MAE mendekati 1 — sehingga tidak ada prediksi yang jauh melenceng. Untuk komunikasi ke manajemen operasional, MAE biasanya dipilih karena mudah dijelaskan tanpa rumus; metrik ini cocok ketika setiap kWh yang meleset diperlakukan hampir setara biayanya.
3.4.2 Contoh kasus 2 — Prediksi harga jual properti (RMSE mengekspos outlier)
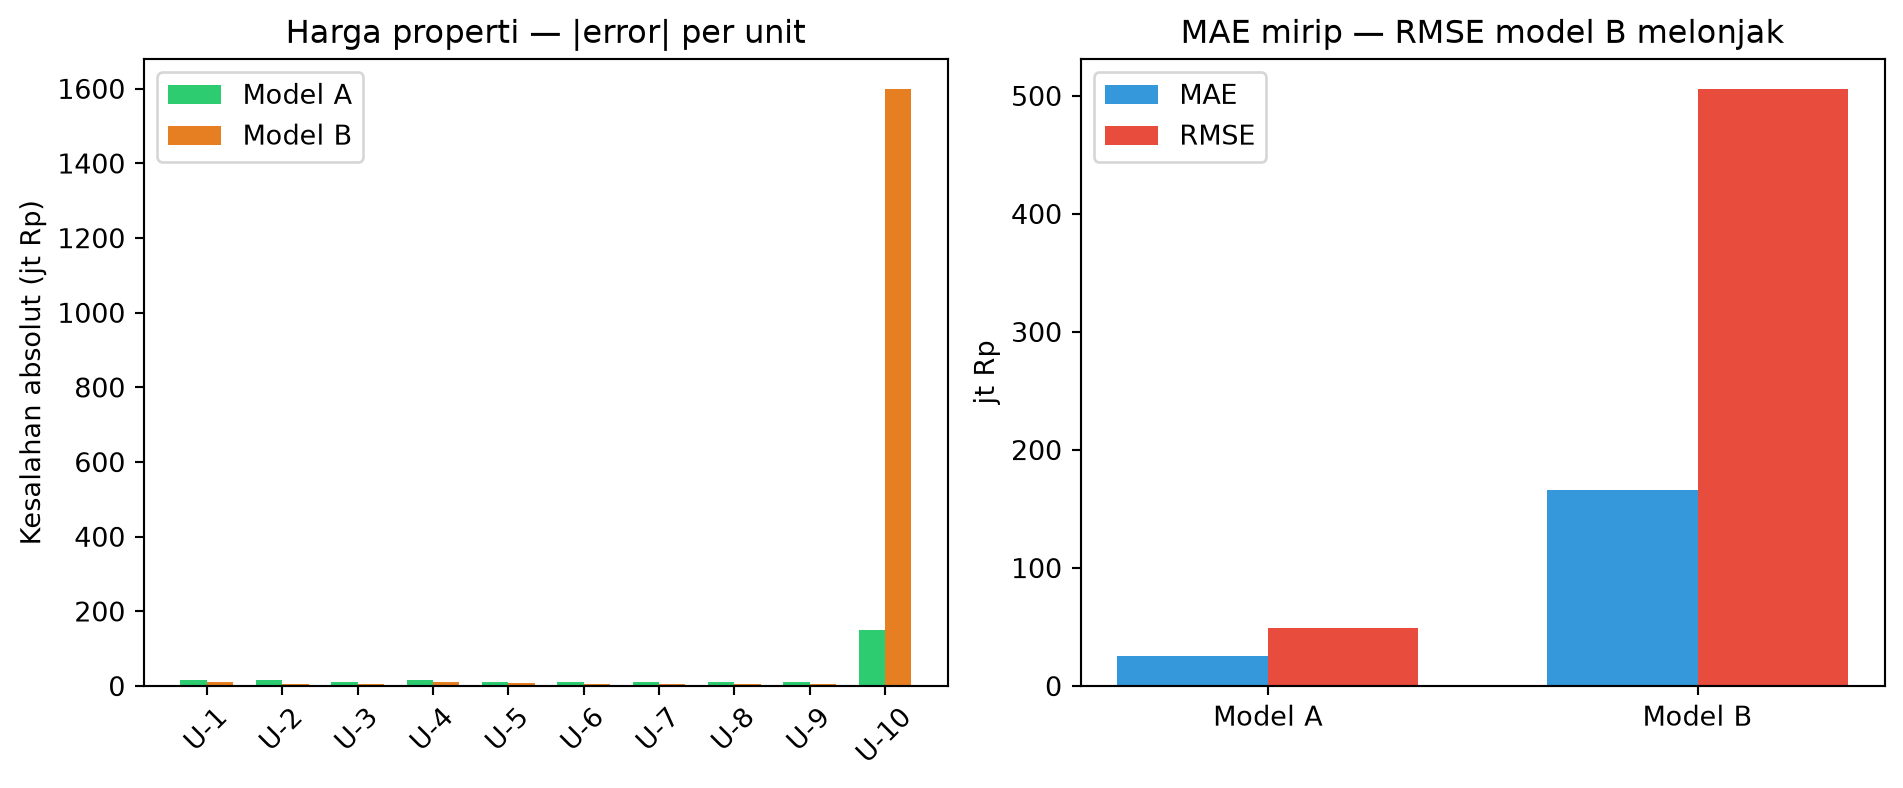
Dua model (A dan B) dipakai memprediksi harga jual (juta Rp) pada 10 unit apartemen serupa. MAE keduanya hampir sama, tetapi RMSE model B jauh lebih besar — karena satu unit mewah diprediksi jauh di bawah harga pasar.
Gambar 4: Kiri: |error| per unit — unit U-10 (villa mewah) membuat model B meleset ekstrem. Kanan: MAE hampir sama, RMSE model B jauh lebih besar.
Interpretasi: Jika stakeholder hanya melihat MAE, model A dan B tampak setara. RMSE model B jauh lebih besar karena unit U-10 (villa senilai 2,8 M) diprediksi hanya 1,2 M — kesalahan 1,6 M yang fatal untuk penawaran atau penilaian agunan. Konteks seperti ini:
MAE → laporan “rata-rata meleset X juta” untuk mayoritas transaksi tipikal.
RMSE → alarm jika beberapa prediksi ekstrem tidak boleh dibiarkan (penalti kuadrat selaras dengan optimasi MSE dan risiko finansial besar).
Rasio RMSE / MAE ≈ 1 → error seragam; > 1,5 → ada outlier prediksi dominan.
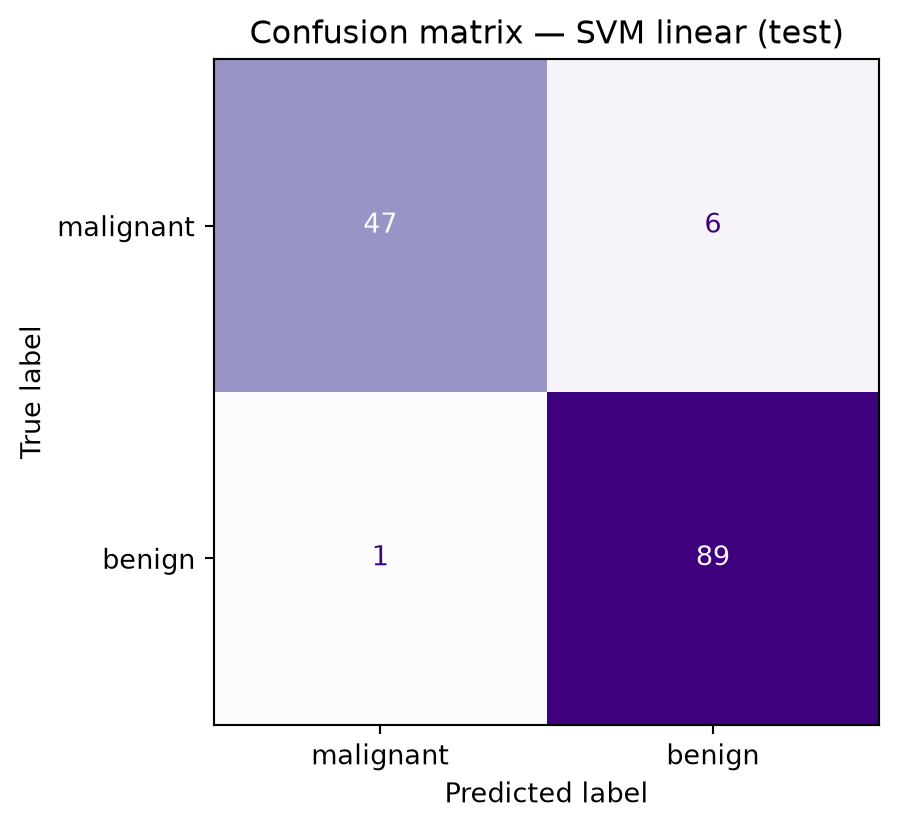
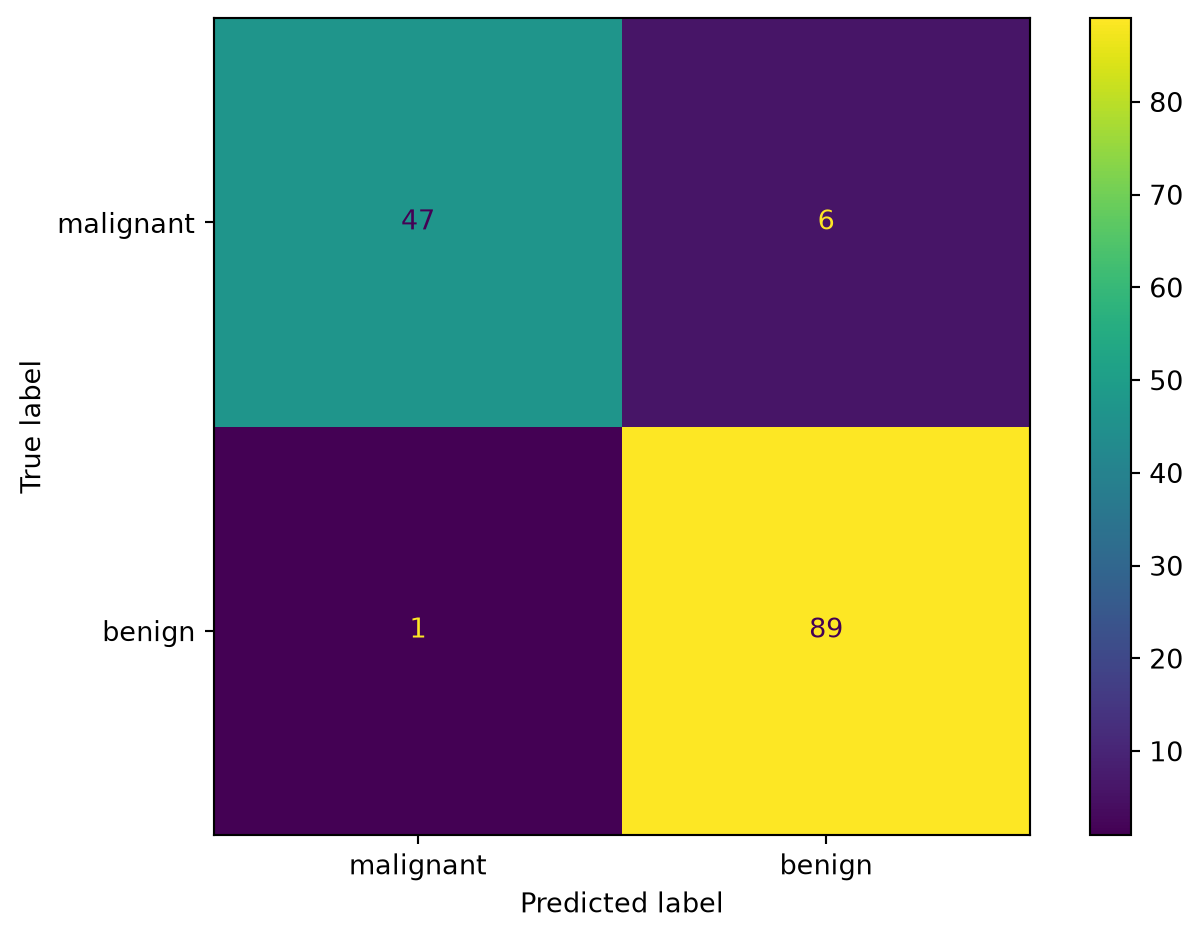
TN — aktual No, prediksi No → benar mengenali negatif.
FP — aktual No, prediksi Yes → alarm palsu.
Pada multi-kelas, matriks \(C \times C\): baris = aktual, kolom = prediksi; diagonal = benar per kelas.
Bahasa awam: bayangkan skrining penyakit — diagonal = tepat sasaran; FN (positif terlewat) sering lebih berbahaya daripada FP (alarm palsu), tergantung konteks. Akurasi saja menyesatkan pada kelas tidak seimbang: model yang selalu prediksi kelas mayoritas bisa tampak akurat tetapi gagal menemukan minoritas.
4.2 Metrik dari confusion matrix
Empat sel confusion matrix (TP, FN, FP, TN) dapat dirangkum menjadi satu angka agar mudah dibandingkan model. Setiap metrik menjawab pertanyaan berbeda — tidak ada satu metrik yang selalu “paling benar”.
Kunci membaca: perhatikan pembilang (bagian atas pecahan) dan penyebut (bagian bawah). Pembilang = “berapa yang benar menurut definisi metrik”; penyebut = “dari populasi mana kita menghitung proporsi”.
Cara membaca rumus. Jumlahkan semua prediksi benar (TP + TN), bagi total semua observasi uji.
Simbol
Makna
\(TP + TN\)
semua keputusan model yang tepat (positif benar + negatif benar)
\(TP + TN + FP + FN\)
ukuran set uji \(n\)
Interpretasi. Accuracy = 0,92 artinya 92% baris uji diklasifikasi benar. Mudah dipahami stakeholder, tetapi menyesatkan jika kelas tidak seimbang: model yang hampir selalu memprediksi kelas mayoritas bisa accuracy tinggi sambil gagal total pada kelas minoritas (lihat Kasus 5 di latihan).
Implementasi:accuracy_score(y_true, y_pred).
4.2.2 Precision (presisi)
\[
\mathrm{Precision} = \frac{TP}{TP + FP}
\]
Cara membaca rumus. Dari semua observasi yang model labeli positif (\(TP + FP\)), berapa proporsi yang benar-benar positif (\(TP\))?
Simbol
Makna
\(TP\)
prediksi positif yang tepat
\(TP + FP\)
semua prediksi positif (benar + alarm palsu)
Bahasa awam:“Jika model bilang YA, seberapa sering YA itu benar?” — fokus pada kepercayaan terhadap alarm positif.
Contoh angka:\(TP = 90\), \(FP = 10\) → Precision \(= 90/100 = 0{,}90\). Dari 100 kali model bilang “positif”, 90 kali memang positif; 10 kali FP (alarm palsu).
Kapan diprioritaskan: biaya FP tinggi — email penting salah masuk spam, iklan salah ke pengguna premium, penahanan tanpa bukti. Naikkan precision biasanya dengan threshold lebih tinggi atau model yang lebih konservatif memprediksi positif.
Implementasi:precision_score(y_true, y_pred) — untuk kelas positif biner (label 1).
Cara membaca rumus. Dari semua observasi yang benar-benar positif di dunia nyata (\(TP + FN\)), berapa yang berhasil ditangkap model (\(TP\))?
Simbol
Makna
\(TP\)
aktual positif yang terdeteksi
\(TP + FN\)
semua aktual positif (terdeteksi + terlewat)
Bahasa awam:“Dari semua yang memang positif, berapa persen yang kita dapat?” — fokus pada kelengkapan penangkapan kelas positif, bukan pada prediksi positif model.
Contoh angka:\(TP = 80\), \(FN = 20\) → Recall \(= 80/100 = 0{,}80\). Ada 100 kasus positif nyata; model hanya menemukan 80; 20 FN (terlewat).
Kapan diprioritaskan: biaya FN tinggi — penyakit tidak terdiagnosis, fraud terlewat, kebocoran keamanan. Naikkan recall dengan threshold lebih rendah atau model yang lebih agresif memprediksi positif.
Cara membaca rumus. Dari semua observasi yang benar-benar negatif (\(TN + FP\)), berapa yang benar dikenali sebagai negatif (\(TN\))?
Simbol
Makna
\(TN\)
aktual negatif yang tepat diprediksi negatif
\(TN + FP\)
semua aktual negatif (benar + salah dinyatakan positif)
Bahasa awam:“Dari semua yang memang negatif, seberapa sering model bilang TIDAK dengan benar?” — kebalikan dari FPR (False Positive Rate): \(\mathrm{FPR} = FP/(FP+TN) = 1 - \mathrm{Specificity}\).
Kapan diprioritaskan: penting memastikan negatif yang sehat tidak salah masuk jalur positif — rule-out sebelum tindakan invasif, atau menjaga pengalaman pengguna mayoritas yang bukan target kampanye.
Pasangan dengan Recall: Recall menjaga positif tidak terlewat; Specificity menjaga negatif tidak salah positif. Keduanya bisa trade-off saat threshold digeser.
4.2.5\(F_1\)-score (harmonic mean precision–recall)
Cara membaca rumus.\(F_1\) adalah rata-rata harmonik precision dan recall — lebih berat menghukum jika salah satu sangat rendah (berbeda dari rata-rata aritmetika biasa).
Situasi
Precision
Recall
\(F_1\) (kira-kira)
Seimbang baik
0,80
0,80
0,80
Precision tinggi, recall rendah
0,95
0,40
≈ 0,56
Recall tinggi, precision rendah
0,50
0,95
≈ 0,66
Interpretasi.\(F_1 = 0{,}75\) artinya precision dan recall berada pada keseimbangan yang cukup untuk kelas positif — berguna saat Anda ingin satu angka perbandingan model dan kelas tidak terlalu seimbang (accuracy menipu).
Kapan diprioritaskan: tidak tahu pasti mana yang lebih mahal antara FP dan FN, tetapi keduanya sama-sama penting; juga lazim pada imbalanced classification sebagai pengganti accuracy.
4.2.6 Ringkas: pertanyaan yang dijawab setiap metrik
Metrik
Pertanyaan inti
“Dunia” yang dihitung
Accuracy
Berapa % semua prediksi benar?
seluruh uji
Precision
Prediksi positif kita seberapa bisa dipercaya?
subkumpulan prediksi +
Recall / Sensitivity
Aktual positif seberapa banyak tertangkap?
subkumpulan aktual +
Specificity
Aktual negatif seberapa sering benar?
subkumpulan aktual −
\(F_1\)
Keseimbangan precision & recall pada +?
kelas positif (agregat)
Memilih metrik:Precision jika FP mahal; Recall jika FN mahal; Specificity jika menjaga negatif benar sangat penting; \(F_1\) jika perlu ringkasan seimbang; Accuracy hanya jika kelas relatif seimbang dan biaya kesalahan simetris.
4.2.7 Contoh perbandingan dua model
Model
TP
FN
FP
TN
Naive Bayes
142
22
29
110
Logistic Regression
137
22
29
115
Dengan FN dan FP sama, Naive Bayes unggul di TP, Logistic Regression di TN. Jika keempat sel berbeda, bandingkan Sensitivity, Specificity, dan Precision.
Micro-F1 pada multi-kelas sering setara dengan akurasi jika setiap observasi satu label.
4.6 Memilih metrik — contoh domain
Konteks
Metrik yang sering diprioritaskan
Harga / permintaan (regresi)
RMSE + MAE; \(R^2\) sebagai pelengkap
Deteksi fraud / penyakit
Recall kelas positif, F1; PR-AUC jika kelas sangat langka
Filter spam / rekomendasi iklan
Precision (kurangi gangguan FP)
Klasifikasi multi-kelas seimbang
F1-macro, confusion matrix per kelas
Model probabilistik / ranking skor
ROC & AUC; lalu precision/recall pada threshold operasional
4.7 ROC curve & AUC (klasifikasi probabilistik)
Metrik precision, recall, dan F1 di atas mengasumsikan keputusan biner sudah dibuat (mis. predict() dengan ambang default 0,5). Banyak model klasifikasi modern — Logistic Regression, Random Forest, Gradient Boosting, jaringan saraf — justru mengeluarkan skor atau probabilitas\(P(Y=1 \mid x) \in [0,1]\). Pertanyaan evaluasi bergeser:
Seberapa baik skor memisahkan kelas positif dan negatif (tanpa memilih satu ambang)?
Jika bisnis memilih ambang tertentu, berapa TPR, FPR, precision, dan recall di titik itu?
ROC (Receiver Operating Characteristic) dan AUC menjawab pertanyaan (1). Pertanyaan (2) tetap memakai confusion matrix pada threshold yang dipilih.
Berapa proporsi aktual negatif yang salah dinyatakan positif?
Cara membangun kurva ROC (konseptual):
Urutkan observasi uji menurut skor\(P(Y{=}1 \mid x)\) menurun.
Geser \(\tau\) dari 1 → 0; setiap perubahan \(\tau\) yang memindahkan satu titik dari negatif ke positif (atau sebaliknya) menambah satu titik\((\mathrm{FPR}, \mathrm{TPR})\).
Hubungkan titik-titik → kurva ROC. Titik (0, 0) = tidak ada yang diprediksi positif; (1, 1) = semua diprediksi positif.
Garis diagonal dari (0,0) ke (1,1) = klasifikator acak (AUC = 0,5). Kurva menjauhi diagonal ke kiri-atas = pemisahan lebih baik.
Pada praktik dihitung numerik dari pasangan \((\mathrm{FPR}, \mathrm{TPR})\) — sklearn.metrics.auc(fpr, tpr) atau roc_auc_score(y_true, y_score).
AUC
Interpretasi praktis
1,0
pemisahan sempurna (jarang di data nyata)
0,9 – 1,0
sangat baik
0,8 – 0,9
baik
0,7 – 0,8
cukup / usable tergantung domain
0,5
tidak lebih baik dari tebak acak
< 0,5
lebih buruk dari acak (skor terbalik — cek encoding label)
Bahasa probabilitas (opsional): AUC ≈ probabilitas bahwa skor observasi positif acak lebih tinggi dari skor observasi negatif acak — ukuran ranking kelas.
Yang AUC tidak beri tahu: precision, biaya FP/FN, atau metrik pada satu threshold operasional. Setelah membandingkan model dengan AUC, tetap pilih \(\tau\) sesuai kebijakan bisnis dan laporkan confusion matrix / precision / recall di titik itu.
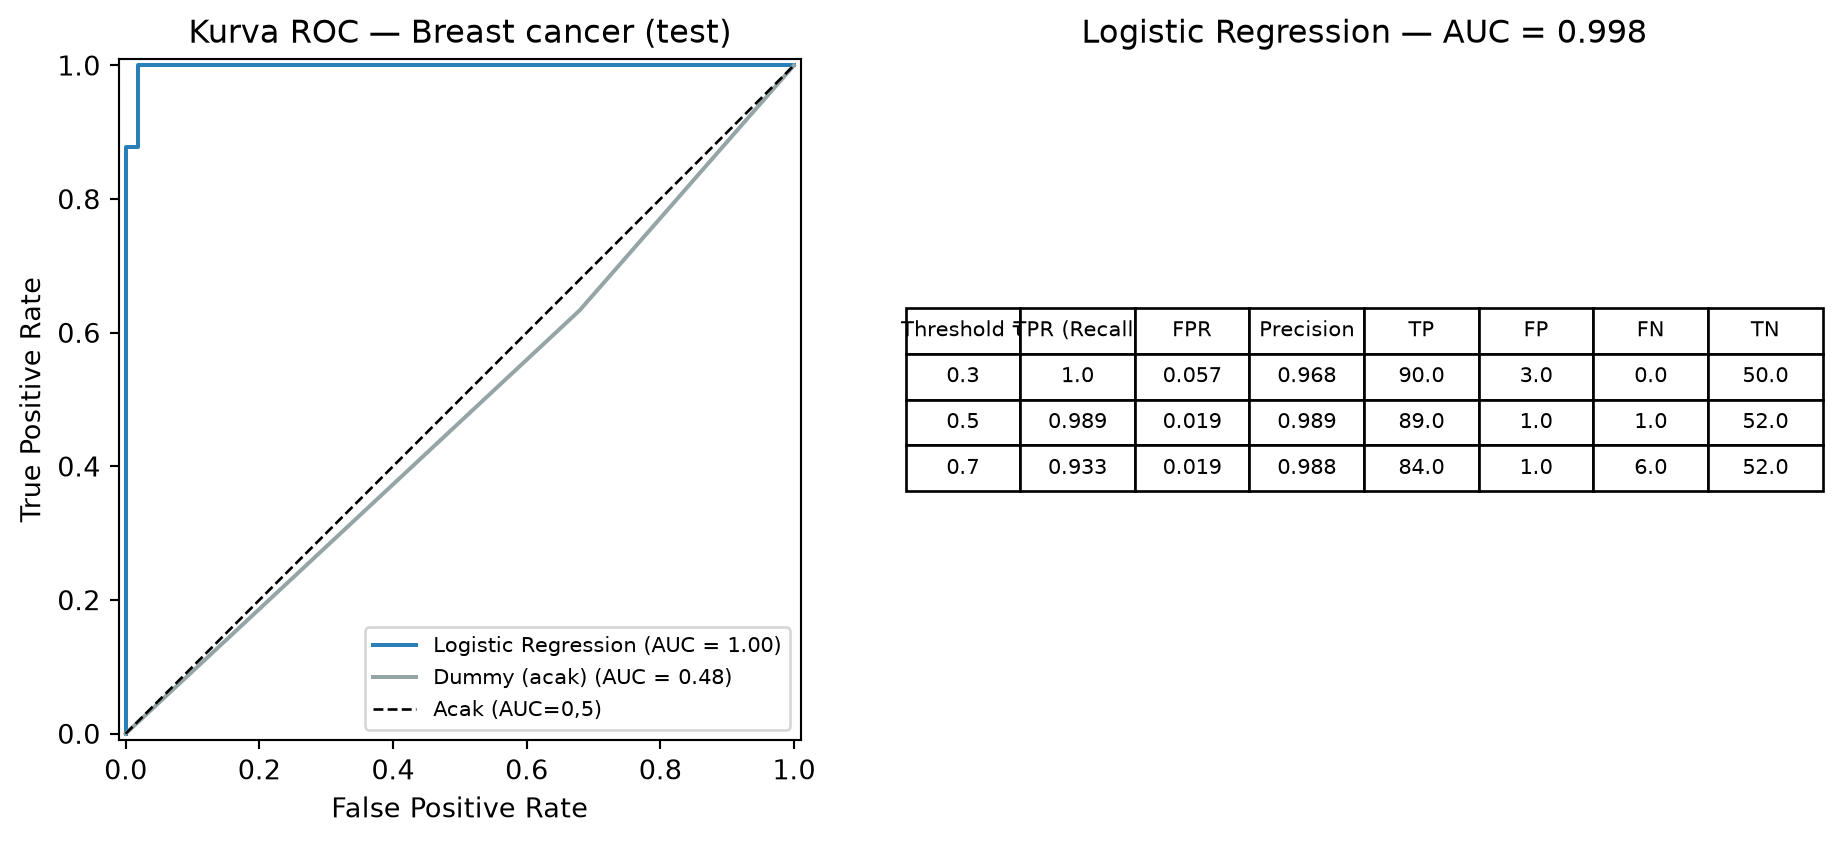
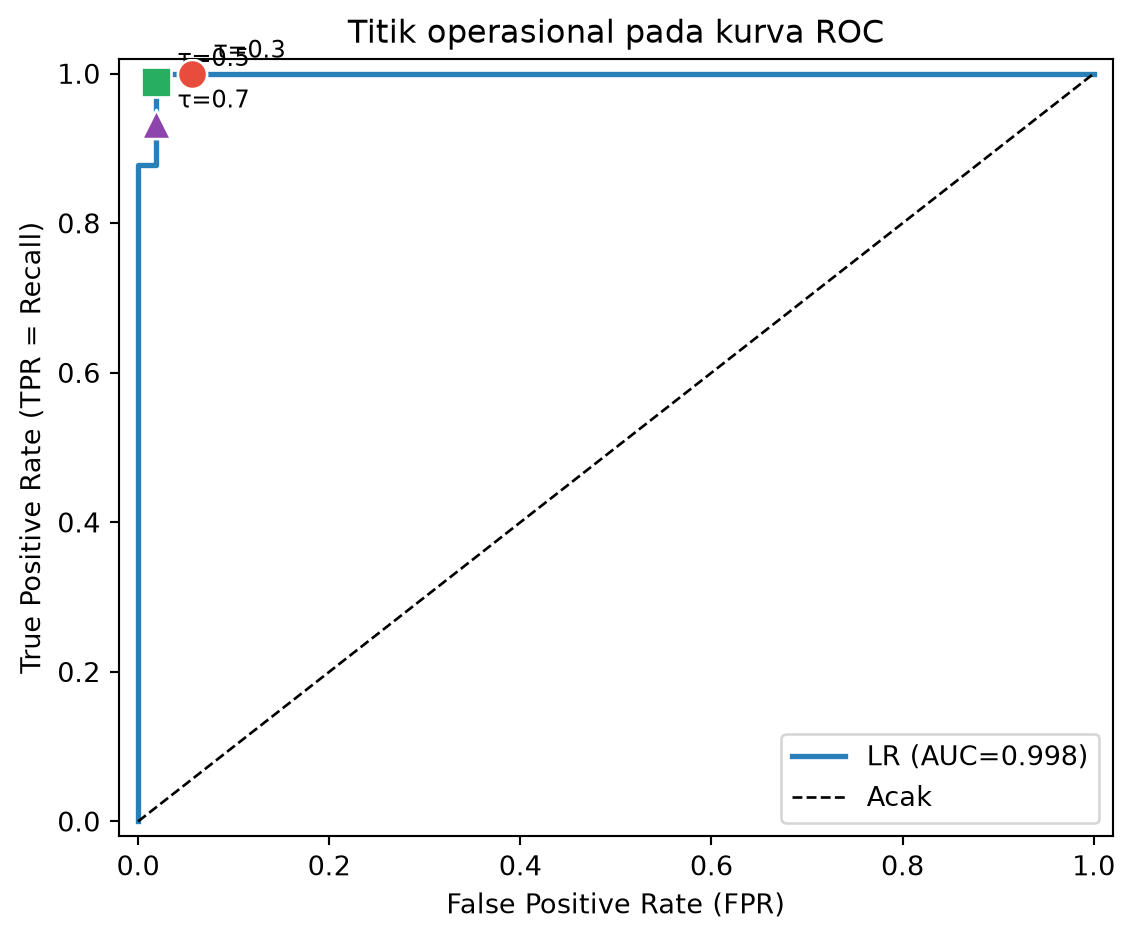
Kiri: kurva ROC Logistic Regression vs Dummy (acak) pada uji Breast cancer. Kanan: AUC dan metrik pada tiga threshold untuk model terbaik.
Interpretasi demo:
AUC Logistic Regression jauh di atas 0,5 dan di atas dummy → skor probabilitas memisahkan malignan vs benign dengan baik.
Kurva ROC di kiri: semakin ke kiri-atas, semakin baik. Dummy mengikuti diagonal → AUC ≈ 0,5.
Tabel threshold:\(\tau = 0{,}3\) → TPR tinggi (lebih banyak malignan tertangkap) tetapi FPR naik; \(\tau = 0{,}7\) → Precision naik, FN naik. Tidak ada \(\tau\) “terbaik” tanpa konteks biaya.
Gambar 7: Tiga titik operasional pada kurva ROC (τ = 0,3, 0,5, 0,7) — setiap titik = pasangan (FPR, TPR) dari tabel di atas.
4.7.5 Memilih threshold setelah melihat ROC
Alur yang disarankan:
Bandingkan model dengan AUC (atau kurva ROC) pada set uji yang sama — model dengan AUC lebih tinggi biasanya ranking skor lebih baik.
Tentukan \(\tau\) operasional dari kebijakan bisnis (biaya FN vs FP, kuota intervensi manusia, dll.) — bisa dengan memindai tabel precision/recall per \(\tau\) atau kurva precision–recall.
Laporkan confusion matrix dan metrik hanya pada \(\tau\) terpilih untuk stakeholder operasional.
Keduanya melengkapi: AUC-ROC untuk membandingkan pemisahan skor; PR-AUC jika kelas positif jarang dan Anda peduli pada precision pada recall tinggi.
4.7.7 Jebakan ROC/AUC
AUC tinggi ≠ model siap produksi — tetap validasi pada threshold dan subset bisnis.
Data leakage pada skor → AUC optimis; pipeline harus fit hanya di latih.
Kelas tidak seimbang — AUC-ROC bisa tetap tinggi sementara precision rendah; baca PR curve atau metrik pada \(\tau\) operasional.
Multi-kelas — gunakan ROC one-vs-rest per kelas atau metrik macro; materi inti DS-11 fokus biner.
5 Latihan pembacaan: 10 contoh kasus metrik evaluasi
Sepuluh skenario berikut memakai data uji sintetis (angka dibulatkan agar mudah dilacak). Setiap kasus menampilkan data mentah atau confusion matrix, metrik yang relevan, lalu interpretasi dalam bahasa operasional. Gunakan sebagai latihan setelah bab 9.1–9.2; contoh regresi mendalam (listrik & properti) tetap ada di atas.
Ringkasan numerik — verifikasi hitungan 10 contoh kasus (sel tidak ditampilkan di narasi).
Kasus
MAE
RMSE
RMSE/MAE
R²
Accuracy
Precision
Recall
F1
Specificity
0
1 MAE pengiriman
3.67
4.73
1.29
0.920
NaN
NaN
NaN
NaN
NaN
1
2 RMSE gaji
10.97
26.54
2.42
0.415
NaN
NaN
NaN
NaN
NaN
2
3 R² baik
3.80
4.07
1.07
0.997
NaN
NaN
NaN
NaN
NaN
3
4 R² negatif
24.00
28.28
1.18
-3.000
NaN
NaN
NaN
NaN
NaN
4
5 klasifikasi
NaN
NaN
NaN
NaN
0.900
0.600
0.273
0.375
0.978
5
6 klasifikasi
NaN
NaN
NaN
NaN
0.945
0.989
0.450
0.619
0.999
6
7 klasifikasi
NaN
NaN
NaN
NaN
0.981
0.760
0.950
0.844
0.982
7
8 klasifikasi
NaN
NaN
NaN
NaN
0.950
0.800
0.727
0.762
0.978
8
9 klasifikasi
NaN
NaN
NaN
NaN
0.982
0.118
0.400
0.182
0.985
5.1 Kasus 1 — Membaca MAE (estimasi waktu pengiriman)
Konteks: Kurir memprediksi waktu tiba paket (menit) untuk enam pengiriman same-day.
ID
Aktual (menit)
Prediksi (menit)
|Error| (menit)
P-01
32
30
2
P-02
48
52
4
P-03
55
54
1
P-04
61
58
3
P-05
70
68
2
P-06
85
95
10
Metrik (uji)
Nilai
MAE
3,7 menit
RMSE
4,7 menit
Interpretasi:MAE ≈ 3,7 menit berarti rata-rata prediksi meleset sekitar 3–4 menit per paket — mudah disampaikan ke operasional (“biasanya salah kurang dari 5 menit”). Satu pengiriman (P-06) meleset 10 menit; MAE tetap moderat karena error besar dihitung linear. RMSE hanya sedikit di atas MAE → tidak ada satu prediksi yang mendominasi keseluruhan.
5.2 Kasus 2 — RMSE vs MAE (prediksi gaji karyawan baru)
Konteks: HR memprediksi gaji awal (juta Rp). Mayoritas karyawan junior (5–9 juta); satu outlier direktur (100 juta) diprediksi jauh terlalu rendah.
ID
Aktual (jt)
Prediksi (jt)
|Error| (jt)
K-01 … K-05
5–9
5,2–9,1
0,1–0,2
K-06
100
35
65
Metrik
Nilai
MAE
≈ 11,0 jt
RMSE
≈ 26,5 jt
RMSE / MAE
≈ 2,4
Interpretasi:MAE ≈ 11 jt terdengar “lumayan” meski lima karyawan hampir tepat — karena satu kesalahan 65 jt ikut dirata-rata secara linear. RMSE ≈ 26,5 jt jauh lebih besar: kuadrat error 65 jt mendominasi. Rasio RMSE/MAE > 2 adalah sinyal outlier prediksi; stakeholder risiko kompensasi harus melihat RMSE (ataun residual terbesar), bukan hanya MAE.
5.3 Kasus 3 — Membaca \(R^2\) tinggi (penjualan harian toko)
Konteks: Model regresi memprediksi penjualan harian (juta Rp) pada lima hari uji; pola naik linier.
Hari
Aktual
Prediksi
Sen
100
105
Sel
150
148
Rab
200
205
Kam
250
248
Jum
300
295
\(R^2\) (uji)
≈ 0,997
Interpretasi:\(R^2\) mendekati 1 → model menjelaskan hampir seluruh variasi penjualan di set uji ini, jauh lebih baik daripada baseline “tebak rata-rata”. Tetap ingat: \(R^2\) tanpa satuan — tidak menggantikan MAE/RMSE untuk “salah berapa juta per hari”. Laporkan juga MAE/RMSE jika keputusan operasional butuh satuan rupiah.
5.4 Kasus 4 — \(R^2\) negatif (model salah arah di uji)
Konteks: Model yang overfit di latih dipakai pada uji dengan pola berbeda; prediksi hampir terbalik terhadap aktual.
Obs.
Aktual
Prediksi
1–5
10 → 50 (naik)
50 → 10 (turun)
\(R^2\) (uji)
≈ −3,5
Interpretasi:\(R^2 < 0\) artinya model lebih buruk daripada selalu memprediksi \(\bar{y}\) pada set uji. Ini bukan “sedikit kurang bagus”, melainkan gagal generalisasi — cek distribusi latih/uji, leakage, atau model terlalu kompleks. Jangan membandingkan \(R^2\) negatif ini dengan \(R^2\) = 0,85 di dataset lain.
5.5 Kasus 5 — Akurasi menyesatkan (gagal bayar kredit)
Konteks: 1.000 nasabah uji; 9% gagal bayar (kelas positif = risiko). Model jarang memprediksi “gagal bayar”.
Pred. gagal (+)
Pred. lancar (−)
Aktual gagal (+)
TP = 30
FN = 80
Aktual lancar (−)
FP = 20
TN = 870
Metrik
Nilai
Accuracy
90,0%
Recall (+)
27,3%
Precision (+)
60,0%
Interpretasi:Akurasi 90% terdengar bagus karena mayoritas lancar. Namun Recall = 27,3% → dari 110 yang benar-benar gagal bayar, model hanya menangkap 30; 80 terlewat (FN). Untuk mitigasi kredit, recall kelas risiko (atau F1) lebih relevan daripada akurasi. Model “selalu lancar” bisa mencapil ~91% akurasi tanpa nilai bisnis.
5.6 Kasus 6 — Prioritas Precision (filter spam email)
Konteks: 10.000 email uji; 10% spam. Salah klasifikasi email penting sebagai spam (FP) sangat merugikan.
Pred. spam (+)
Pred. bukan spam (−)
Aktual spam (+)
TP = 450
FN = 550
Aktual bukan spam (−)
FP = 5
TN = 8.995
Metrik
Nilai
Precision (+)
≈ 98,9%
Recall (+)
45,0%
Accuracy
94,5%
Interpretasi:Precision ≈ 99% → hampir semua yang dilabel spam memang spam; hanya 5 FP dari ribuan email penting. Trade-off: Recall 45% → lebih dari setengah spam lolos (FN). Untuk kotak masuk eksekutif, precision tinggi bisa diterima; untuk keamanan massal, naikkan recall (threshold lebih rendah) meski FP naik.
5.7 Kasus 7 — Prioritas Recall (skrining penyakit dini)
Interpretasi:Recall 95% → 475 dari 500 kasus positif tertangkap; 25 FN masih perlu tindak lanjut protokol. Precision 76% → sekitar seperempat alarm positif palsu (150 FP); biaya tes lanjutan vs biaya melewatkan penyakit menentukan ambang. Specificity 98,2% tinggi — sehat yang sehat jarang salah dinyatakan sakit.
5.8 Kasus 8 — Menghitung & membaca \(F_1\) (shortlist kandidat)
Konteks: 500 lamaran uji; 11% diterima (positif). HR ingin keseimbangan antara FP (interview sia-sia) dan FN (talenta terlewat).
Pred. terima (+)
Pred. tolak (−)
Aktual terima (+)
TP = 40
FN = 15
Aktual tolak (−)
FP = 10
TN = 435
Metrik
Nilai
Precision (+)
80,0%
Recall (+)
72,7%
\(F_1\)
≈ 0,76
Interpretasi:\(F_1 = 2 \cdot \frac{0{,}80 \times 0{,}727}{0{,}80 + 0{,}727} \approx 0{,}76\) merangkum kompromi precision–recall pada kelas positif. Akurasi\((40+435)/500 = 95\%\) tinggi tetapi menutupi performa pada 55 kandidat “layak” (40+15). Bandingkan dua model dengan \(F_1\) (bukan akurasi saja) jika kelas tidak seimbang.
5.9 Kasus 9 — Membaca Specificity (tes konfirmasi langka)
Konteks: Penyakit sangat langka (0,5% prevalensi di uji). Tes dipakai untuk memastikan pasien sehat bisa dipulangkan (rule-out).
Pred. positif (+)
Pred. negatif (−)
Aktual positif (+)
TP = 2
FN = 3
Aktual negatif (−)
FP = 15
TN = 980
Metrik
Nilai
Specificity
≈ 98,5%
Recall (Sensitivity)
40,0%
Precision (+)
≈ 11,8%
Interpretasi:Specificity 98,5% → dari 995 yang benar-benar negatif, 980 dikenali benar; 15 FP (positif palsu). Recall hanya 40% → banyak kasus positif terlewat; tes ini bukan skrining sensitif tinggi. Precision 11,8% rendah karena positif langka — banyak alarm palsu meski specificity tinggi. Pilih metrik sesuai peran tes: rule-out (specificity) vs skrining massal (recall).
5.10 Kasus 10 — Membaca ROC-AUC (dua model scoring kredit)
Konteks: Dua model memberi skor risiko (0–1); evaluasi dengan AUC pada set uji yang sama (lihat bab ROC curve & AUC di atas untuk definisi TPR/FPR dan kurva).
Model
AUC
Threshold operasional
Recall @ threshold
FPR @ threshold
A — Gradient boosting
0,91
0,35
0,88
0,08
B — Regresi logistik
0,73
0,35
0,62
0,22
Interpretasi:AUC mengukur pemisahan kelas di semua ambang, bukan satu keputusan biner. AUC 0,91 (A) >> 0,73 (B) → skor A lebih konsisten menempatkan gagal bayar di atas lancar. Pada threshold sama (0,35), A lebih tinggi recall dengan FPR lebih rendah — selaras dengan AUC lebih besar. AUC ≈ 0,5 setara tebak acak; 0,73 usable tetapi lemah dibanding A. Tetap validasi precision/recall pada threshold bisnis yang dipilih, karena AUC tidak menggantikan biaya FP vs FN.
Ringkas latihan: regresi → utamakan MAE (laporan satuan), RMSE (outlier), \(R^2\) (proporsi variasi, satu dataset); klasifikasi → baca confusion matrix dulu, lalu metrik yang selaras biaya (precision, recall, \(F_1\), specificity); pemisahan skor → AUC + metrik pada threshold operasional.
6 Cross-validation (9.3)
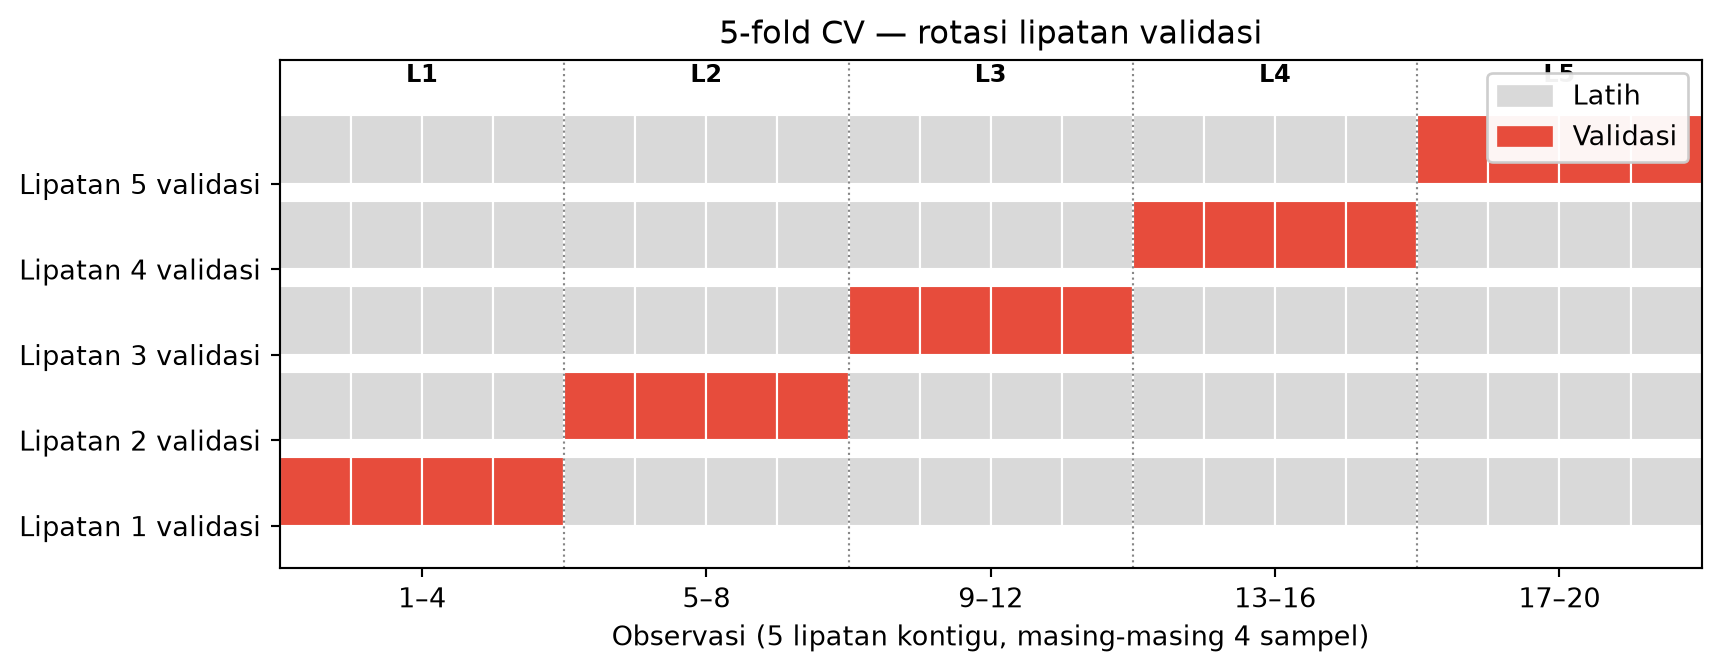
Satu pembagian latih/uji acak bisa keberuntungan. Cross-validation (CV) memecah set latih menjadi lipatan: setiap iterasi satu lipatan = validasi, sisanya = latih; diulang sampai setiap lipatan pernah jadi validasi. Rata-rata skor antar lipatan memberi estimasi lebih stabil; set uji tetap disimpan untuk laporan akhir sekali.
Manfaat: (1) estimasi performa lebih andal, (2) tuning hiperparameter tanpa menyentuh set uji, (3) mendeteksi varians tinggi antar lipatan.
6.1 Skema k-fold
import matplotlib.pyplot as pltimport matplotlib.patches as mpatchesimport numpy as npk =5n =20fold_size = n // ktrain_color = (0.85, 0.85, 0.85, 1)val_color ="#e74c3c"fig, ax = plt.subplots(figsize=(9, 3.6))for f inrange(k):for i inrange(n): is_val = (i // fold_size) == f ax.add_patch( plt.Rectangle( (i, f),1,0.8, color=val_color if is_val else train_color, ec="white", linewidth=0.8, ) )for b inrange(1, k): ax.axvline(b * fold_size, color="#555555", linewidth=0.8, linestyle=":", alpha=0.7)for b inrange(k): ax.text( b * fold_size + fold_size /2, k +0.12,f"L{b +1}", ha="center", va="bottom", fontsize=9, fontweight="bold", )ax.set_xlim(0, n)ax.set_ylim(-0.5, k +0.45)ax.set_yticks(range(k))ax.set_yticklabels([f"Lipatan {i +1} validasi"for i inrange(k)])ax.set_xlabel("Observasi (5 lipatan kontigu, masing-masing 4 sampel)")ax.set_xticks([i * fold_size + fold_size /2for i inrange(k)])ax.set_xticklabels([f"{i * fold_size +1}–{(i +1) * fold_size}"for i inrange(k)])ax.set_title("5-fold CV — rotasi lipatan validasi")ax.legend( handles=[ mpatches.Patch(color=train_color, label="Latih"), mpatches.Patch(color=val_color, label="Validasi"), ], loc="upper right", framealpha=0.95,)plt.tight_layout()
Gambar 8: 5-fold CV: 20 observasi dibagi 5 lipatan kontigu (L1–L5). Setiap baris = satu iterasi; merah = validasi, abu-abu = latih (4/5 data).
6.2 Memilih \(k\) dan varian CV
Skema
Kapan dipakai
Catatan praktik
10-fold
dataset besar
lazim di literatur; cv=10
5-fold
kompromi biaya/stabilitas
default umum di kuliah & GridSearchCV
Leave-One-Out (LOO)
dataset sangat kecil (\(k = n\))
mahal jika \(n\) besar; setiap iterasi \(n-1\) latih, 1 uji
Di scikit-learn: cross_val_score(..., cv=5) atau StratifiedKFold(5).
StratifiedKFold — proporsi kelas di tiap lipatan mendekati proporsi global (penting untuk klasifikasi tidak seimbang). RepeatedKFold — ulangi pembagian \(r\) kali untuk estimasi mean ± std yang lebih andal.
Best k: {'m__n_neighbors': 15}
Best CV F1-macro: 0.979
Best estimator (refit on full X): Pipeline(steps=[('sc', StandardScaler()),
                ('m', KNeighborsClassifier(n_neighbors=15))])
best_score_ = rata-rata skor CV di data latih penuh — bukan skor test.
6.4 Nested CV & train / validation / test
Nested CV (penelitian): lipatan luar = estimasi performa, lipatan dalam = tuning — menghindari estimasi optimis bila skor CV yang sama dipakai untuk tuning sekaligus pelaporan.
Subset
Peran
Train
latih parameter model
Validation
pilih hiperparameter (CV memutar peran ini di dalam train)
Test
laporan akhir sekali
7 Alur evaluasi end-to-end
Data → validasi & split → Pipeline(latih) → CV tuning
     → evaluasi final (test) → dokumentasi metrik & versi
Setiap langkah harus terdokumentasi (versi data, seed, metrik, tanggal evaluasi).
8 Ringkasan
Prinsip: evaluasi pada Testing Data; waspadai overfitting dan data leakage.
9.1 Regresi:MAE, RMSE (turunan sum of squared errors), \(R^2\) — ukur Observed vs Predicted di uji.