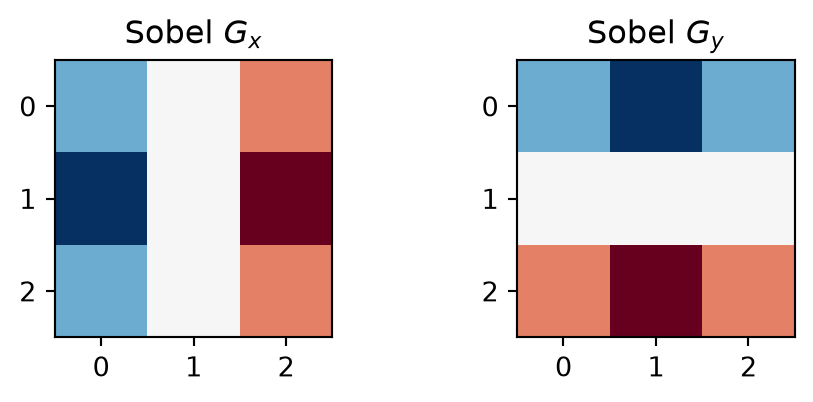Modul teori — Deteksi tepi (gradien Roberts–Prewitt–Sobel & LoG)
Pengolahan Citra Digital (PCD), pertemuan ke-10
Deteksi tepi memunculkan lokasi transisi intensitas yang sering berkaitan dengan batas objek, teks, atau struktur bentuk. Dibanding memproses setiap piksel intensitas mentah, peta tepi (atau magnitud gradien) merangkum informasi geometri lebih ringkas dan sering dipakai sebagai jembatan menuju analisis bentuk atau keputusan sistem.
Contoh penggunaan (gambaran domain; rumus operator dan contoh numerik ada di bab berikut):
Segmentasi dan analisis bentuk: memperjelas atau menyempurnakan batas objek setelah threshold atau metode region; dasar penautan kontur dan deskriptor bentuk.
Visi industri dan pengukuran: garis tepi komponen, celah las, atau pola teknik sebagai dasar inspeksi kualitas dan estimasi geometri.
OCR dan dokumen: tepi karakter, garis halaman, atau struktur tabel sebagai petunjuk geometri sebelum pengenalan teks.
Visi robot atau kendaraan: landmark visual sederhana dari kontur (biasanya digabung filter lain dan sensor tambahan).
Pra-langkah fitur klasik: masukan ke Canny (NMS + hysteresis pada magnitud gradien), transformasi Hough garis/lingkaran, atau filter orientasi lain.
Modul ini menekankan inti matematis gradien (Roberts–Prewitt–Sobel) dan LoG; pada bagian Alur dalam sistem visi di akhir dokumen, langkah-langkah tersebut diposisikan dalam pipeline tipikal tanpa mengulang daftar aplikasi di atas.
0.1 Tujuan pembelajaran
Menjelaskan tepi sebagai lokasi perubahan intensitas dan hubungannya dengan turunan pertama serta turunan kedua fungsi intensitas.
Menurunkan dan memakai mask Roberts, Prewitt, dan Sobel sebagai aproksimasi gradien diskret\(G_x\), \(G_y\).
Menghitung magnitud\(\|\nabla f\|\), arah gradien, serta menginterpretasikan respons operator.
Menjelaskan Laplacian, Laplacian of Gaussian (LoG), peran parameter \(\sigma\), dan gagasan zero-crossing untuk deteksi tepi.
Mengimplementasikan operator dengan NumPy/SciPy (ndimage.convolve, ndimage.sobel, ndimage.gaussian_laplace).
1 Model kontinu dan citra diskret
Pada domain kontinu, citra monokrom dimodelkan sebagai fungsi terbatas \(f:\Omega \subset \mathbb{R}^2 \to \mathbb{R}\) yang mulai sebagian (atau dalam praktik: mulus sebagian pada wilayah yang relevan). Tepi ideal sering dimodelkan sebagai lokasi di mana \(f\) berubah cepat; pada fungsi mulus, lokasi tersebut berkaitan dengan gradien atau turunan kedua yang besar.
Cara membaca \(f:\Omega \subset \mathbb{R}^2 \to \mathbb{R}\). Baca: “\(f\) memetakan setiap titik di bidang (dalam daerah \(\Omega\)) ke satu bilangan real (intensitas).”
\(f\) — nama fungsi intensitas (abu-abu) pada model kontinu.
\(\Omega\) — subset bidang tempat citra dianalisis (bidang gambar; bisa persegi panjang).
\(\subset\) — “terkandung di”; \(\Omega\) bagian dari \(\mathbb{R}^2\).
\(\mathbb{R}\) — nilai intensitas satu kanal (skalar).
“Terbatas / mulus sebagian” — syarat agar turunan dalam rumus gradien/Laplacian bermakna; di citra nyata kita hampiri dengan diskret.
Pada komputer, \(f\) disampling menjadi matriks \(f[i,j]\) pada grid terbatas. Turunan parsial\(\partial f/\partial x\) dan \(\partial f/\partial y\) dihampiri dengan selisih terhingga pada tetangga piksel. Operasi linear spasial yang shift-invariant pada grid dapat ditulis sebagai konvolusi diskret (atau korelasi, tergantung konvensi buku); kernel kecil \(3\times 3\) atau \(2\times 2\) memadai untuk aproksimasi orde rendah.
Cara membaca \(f[i,j]\).\(i\) biasanya indeks baris (vertikal), \(j\) indeks kolom (horizontal); \(f[i,j]\) satu bilangan intensitas di sel tersebut.
Cara membaca rumus konvolusi. Kiri: nilai citra hasil konvolusi di piksel baris \(i\), kolom \(j\). Kanan: jumlah semua kontribusi produk \(f\) dengan \(h\) ketika kernel digeser sehingga pusat kernel di \((i,j)\).
\((f*h)[i,j]\) — nilai hasil konvolusi di indeks piksel \((i,j)\).
\(\sum_{m,n}\) — jumlahkan untuk semua indeks \((m,n)\) yang dilalui kernel (biasanya \(|m|,|n|\) kecil).
\(f[i-m,j-n]\) — intensitas citra asli di lokasi yang “dijangkau” oleh elemen kernel \(h[m,n]\).
\(h[m,n]\) — bobot kernel pada posisi relatif \((m,n)\) terhadap acuan konvolusi.
Pada implementasi, indeks keluar dari domain citra memerlukan kebijakan batas: constant, reflect, nearest, dll. Mode reflect umum dipakai pada deteksi tepi agar artefak di tepi frame tidak terlalu besar dibanding constant (padding nol memunculkan tepi palsu).
Korelasi vs konvolusi: beberapa buku mendefinisikan “mask Sobel” sebagai korelasi; jika kernel simetris terhadap transformasi yang dipakai, hasil dapat disamakan dengan penyesuaian tanda pada kernel tidak-simetris. Yang penting: dokumentasikan apakah pustaka memakai convolve atau correlate (SciPy ndimage.convolve memakai definisi konvolusi di atas).
Cara membaca gradien.\(\nabla f\) dibaca “nabla \(f\)” atau “gradien \(f\)” — vektor dua komponen: laju perubahan \(f\) searah \(x\), dan laju perubahan \(f\) searah \(y\).
\(\nabla\) — operator nabla (kumpulan turunan parsial spasial).
\(f_x = \partial f/\partial x\) — turunan parsial terhadap \(x\) (perubahan intensitas sejajar sumbu \(x\)).
\(f_y = \partial f/\partial y\) — turunan parsial terhadap \(y\).
Tanda \(\top\) — transpose: vektor kolom ditulis sebagai baris demi ringkasnya di teks.
\((x,y)\) — koordinat kontinu pada bidang.
Magnitud gradien:
\[
\|\nabla f\| = \sqrt{f_x^2 + f_y^2}.
\]
Cara membaca magnitud.\(\|\nabla f\|\) dibaca “norma (panjang) vektor gradien”: akar dari jumlah kuadrat kedua komponen turunan.
\(\sqrt{\cdot}\) — akar kuadrat; hasilnya \(\geq 0\), makin besar jika perubahan intensitas makin curam.
Lokasi dengan \(\|\nabla f\|\) besar berkaitan dengan perubahan intensitas dominan pada arah tegak lurus iso-intensitas. Arah gradien\(\theta = \operatorname{atan2}(f_y, f_x)\) dipakai pada non-maximum suppression (mis. Canny) untuk menipiskan tepi sepanjang arah maksimum magnitud.
Cara membaca \(\theta = \operatorname{atan2}(f_y, f_x)\).\(\operatorname{atan2}\) membaca “arkus tangen dua argumen”: sudut vektor gradien dalam radian (atau derajat setelah konversi), dengan kuadran yang benar — tidak ambigu seperti \(\arctan(f_y/f_x)\) saat \(f_x=0\).
\(\theta\) — arah gradien (sudut terhadap sumbu \(x\)).
\(f_x,\, f_y\) — komponen gradien (turunan parsial) seperti di atas.
Norma \(L_1\) cepat: \(|f_x| + |f_y|\) sebagai pendekatan konveks.
Konvensi modul ini: indeks \(j\) menyumbu horizontal (kolom) dan \(i\)vertikal (baris). \(G_x\) dihitung dengan kernel yang membedakan sepanjang kolom; \(G_y\) sepanjang baris. Pastikan konsisten dengan ndimage.sobel(..., axis=1) untuk turunan sepanjang sumbu kedua (kolom).
4 Operator Roberts (\(2\times 2\))
Roberts memakai diferensi diagonal pada sel \(2\times 2\):
Cara membaca matriks kernel Roberts. Tabel angka adalah kernel\(2\times 2\): baris dan kolom = offset relatif; angka = bobot yang dikalikan dengan piksel \(f\) di sekitar posisi pusat saat konvolusi.
\(G_x^{(R)},\, G_y^{(R)}\) — dua mask untuk mendekati komponen gradien (diagonal).
Isi \(\begin{bmatrix} \cdot & \cdot \\ \cdot & \cdot \end{bmatrix}\) — baris pertama/ke-0 sering berkaitan dengan offset baris \(-1/0\), kolom dengan offset kolom (sesuai implementasi); yang penting pola diferensi diagonal\(+1\) dan \(-1\) pada posisi berbeda.
Superskrip \((R)\) — “versi Roberts” untuk membedakan dari Prewitt/Sobel.
Interpretasi: sangat lokal sehingga rentan noise (varians tinggi pada turunan numerik tanpa regularisasi). Keunggulan: biaya komputasi minimal; cocok untuk perangkat sangat terbatas atau pipeline kasar.
5 Operator Prewitt (\(3\times 3\))
Aproksimasi turunan dengan pemberat rata pada arah tegak lurus diferensi (setara dengan sedikit integrasi sebelum diferensi, sehingga sedikit meredam frekuensi tinggi):
Cara membaca kernel Prewitt. Matriks \(3\times 3\): baris = tiga baris piksel tetangga vertikal; kolom = tiga kolom horizontal; angka \(-1,0,+1\) adalah bobot diferensi/penjumlahan.
\(G_x^{(P)}\) — pola tiga kolom membedakan intensitas kiri vs kanan (turunan arah \(x\)).
\(G_y^{(P)}\) — pola tiga baris membedakan atas vs bawah (turunan arah \(y\)).
Superskrip \((P)\) — Prewitt.
Faktor skala konstan (mis. \(1/3\), \(1/6\)) sering diabaikan jika hanya ambang relatif yang dipakai pada magnitud.
6 Operator Sobel (\(3\times 3\))
Kernel Sobel memakai bobot \(1,2,1\) pada arah ortogonal diferensi — setara dengan konvolusi separable dengan kernel smoothing \([1,2,1]\) dan kernel diferensi \([-1,0,1]\) (hingga skala):
Cara membaca kernel Sobel. Sama seperti Prewitt berukuran \(3\times 3\), tetapi baris/kolom pusat diberi bobot 2 agar titik pusat lebih diutamakan (setara halus ringan sebelum diferensi).
Angka negatif dan positif — kontribusi piksel gelap vs terang ke arah diferensi.
Superskrip \((S)\) — Sobel.
Dampak: sedikit penghalusan sebelum diferensi → respons noise berkurang dibanding Roberts; tepi cenderung sedikit lebih tebal dibanding Prewitt pada pengaturan yang sama.
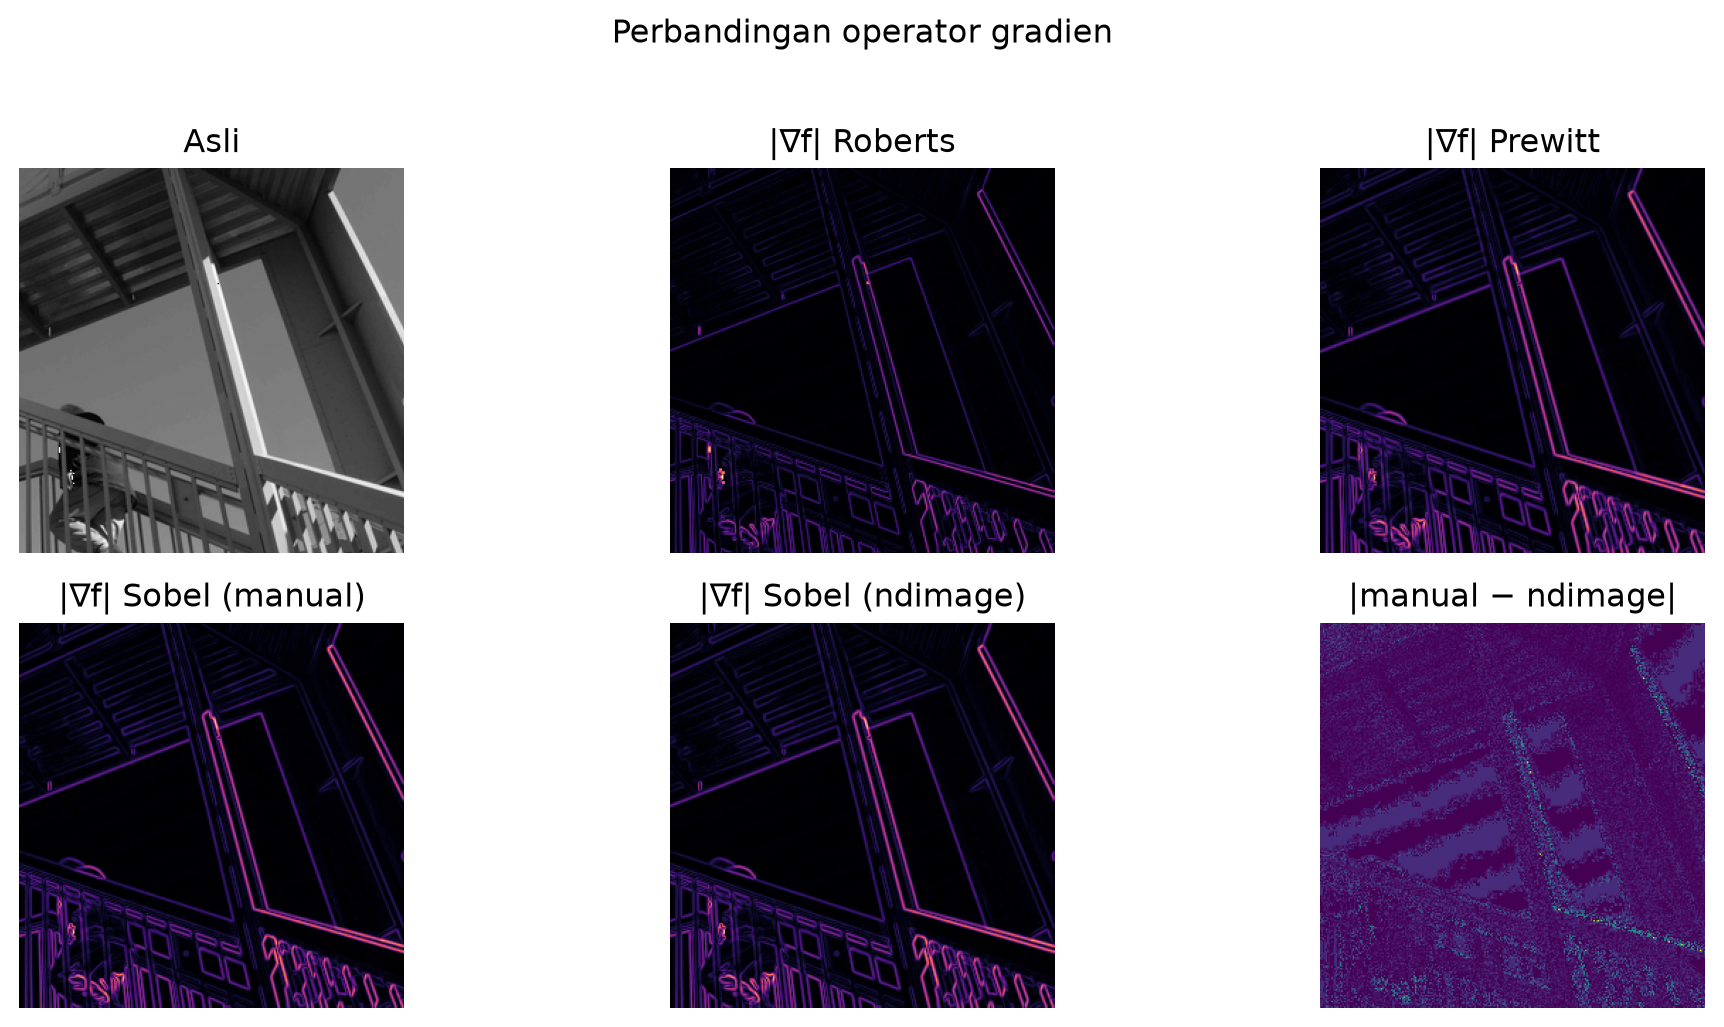
Verifikasi:scipy.ndimage.sobel mengimplementasikan operator terkait dengan konvensi sumbu array; bandingkan dengan konvolusi manual pada contoh di bawah.
Cara membaca Laplacian.\(\nabla^2\) dibaca “operator Laplacian” atau “nabla kuadrat”: jumlah turunan kedua searah \(x\) dan searah \(y\).
\(\partial^2 f/\partial x^2\) — “seberapa melengkung” grafik intensitas sepanjang \(x\) (turunan kedua).
\(\partial^2 f/\partial y^2\) — sama sepanjang \(y\).
\(\nabla^2 f\) — skalar di setiap titik; nilai besar mutlak ⟺ variasi intensitas sangat tidak-linear secara lokal.
Pada citra mulus, maksimum\(|f_x|\) di sepanjang tepi sering berkaitan dengan titik di mana turunan kedua melewati pola tertentu; Laplacian peka terhadap titik isolasi dan noise karena turunan kedua memperkuat frekuensi tinggi.
Cara membaca aproksimasi diskret.\(f[i,j]\) = intensitas di baris \(i\), kolom \(j\); empat tetangga langsung (atas/bawah/kiri/kanan) dijumlahkan; pusat dikurangi empat kali nilai pusat — pola “bintang” klasik Laplacian 4-tetangga.
Cara membaca dua rumus LoG di atas. Baris pertama: “ambil citra \(f\), haluskan dengan Gaussian \(G_\sigma\), lalu terapkan Laplacian.” Baris kedua (sifat matematis): “Laplacian dari (Gaussian konvolusi \(f\)) sama dengan (Laplacian dari Gaussian itu sendiri) dikonvolusikan dengan \(f\)” — sehingga bisa dihitung satu kali konvolusi dengan kernel tetap \(\nabla^2 G_\sigma\).
\(\text{LoG}_\sigma(f)\) — respons operator LoG pada \(f\) dengan parameter lebar blur \(\sigma\) (standar deviasi Gaussian).
\(\nabla^2(\cdot)\) — Laplacian (turunan kedua spasial) dari fungsi di dalam tanda kurung.
\(*\) — konvolusi (sama konvensi seperti di bagian konvolusi diskret).
\(\nabla^2 G_\sigma\) — “topi Meksiko”: kernel tunggal yang menyatukan blur + Laplacian dalam satu mask.
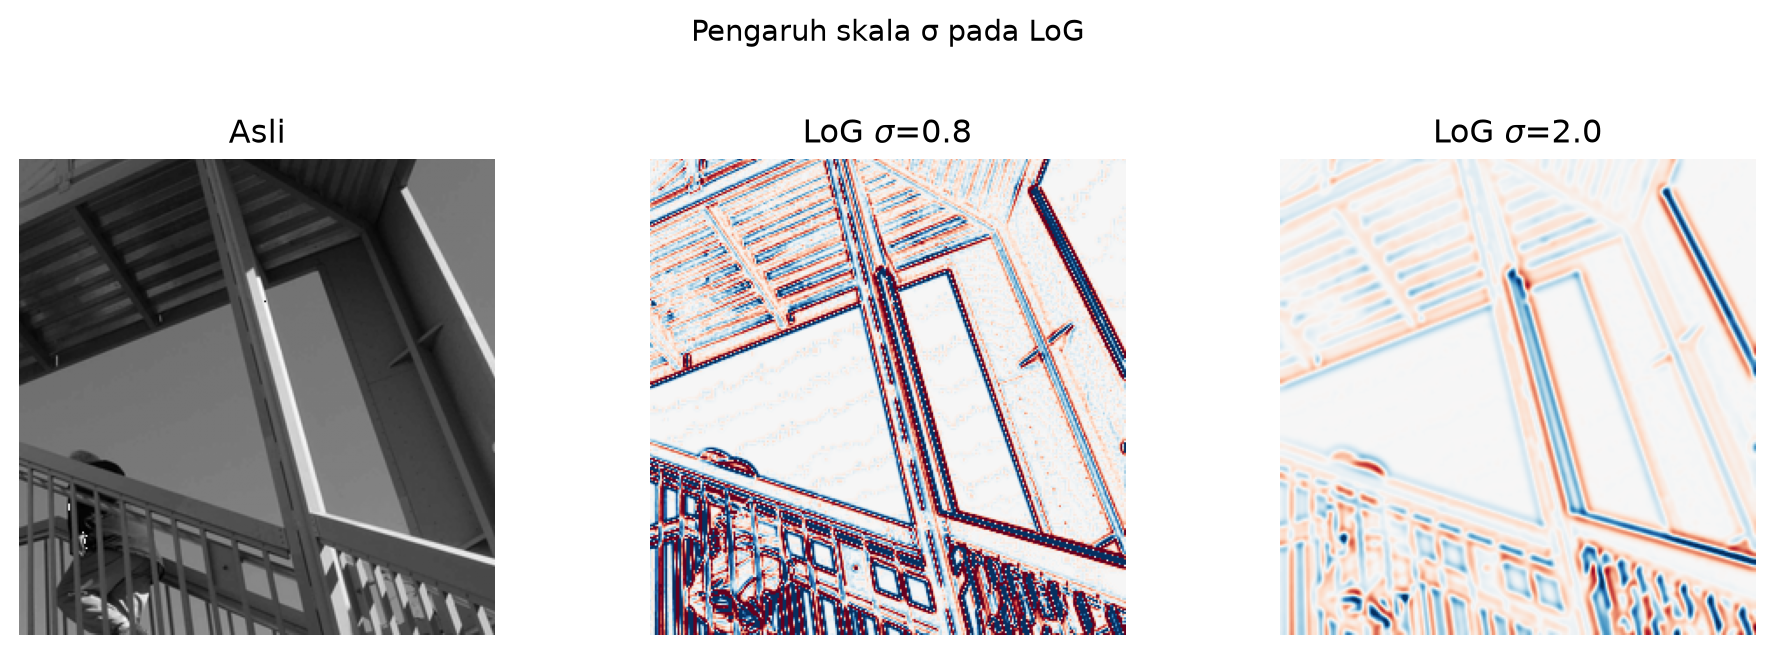
sehingga LoG setara dengan satu konvolusi dengan kernel \(\nabla^2 G_\sigma\) (2D “topi Meksiko”). Parameter \(\sigma\) mengontrol lebar pita frekuensi yang dihilangkan: \(\sigma\) besar → lebih halus → tepi lebih “kasar” secara spasial; \(\sigma\) kecil → lebih sensitif pada detail halus dan noise.
Deteksi tepi Marr–Hildreth (gambaran): cari lokasi zero-crossing dari \(\text{LoG}_\sigma(f)\), yaitu piksel di mana tanda Laplacian berubah di antara tetangga yang relevan, sering disertai syarat kemiringan cukup agar tidak memunculkan garis nol palsu dari noise. Implementasi penuh melibatkan interpolasi subpiksel, ambang kemiringan, dan penautan kurva — di luar cakupan satu modul; di bawah kita visualisasi respons LoG dan petunjuk zero-crossing sederhana.
10 Perbandingan gradien (turunan pertama) vs LoG
Aspek
Gradien (Roberts, Prewitt, Sobel)
LoG
Orde turunan
pertama
kedua (setelah blur-Gaussian)
Keluaran utama
magnitud (dan arah)
respons berosilasi di sekitar tepi
Lokasi tepi
puncak/ambang magnitud
zero-crossing
Sensitivitas noise
tinggi untuk kernel kecil
dapat dikendalikan lewat \(\sigma\)
Biaya
rendah–sedang
sedang (lebar kernel efektif ~\(6\sigma\))
11 Contoh 1: citra uji ascent
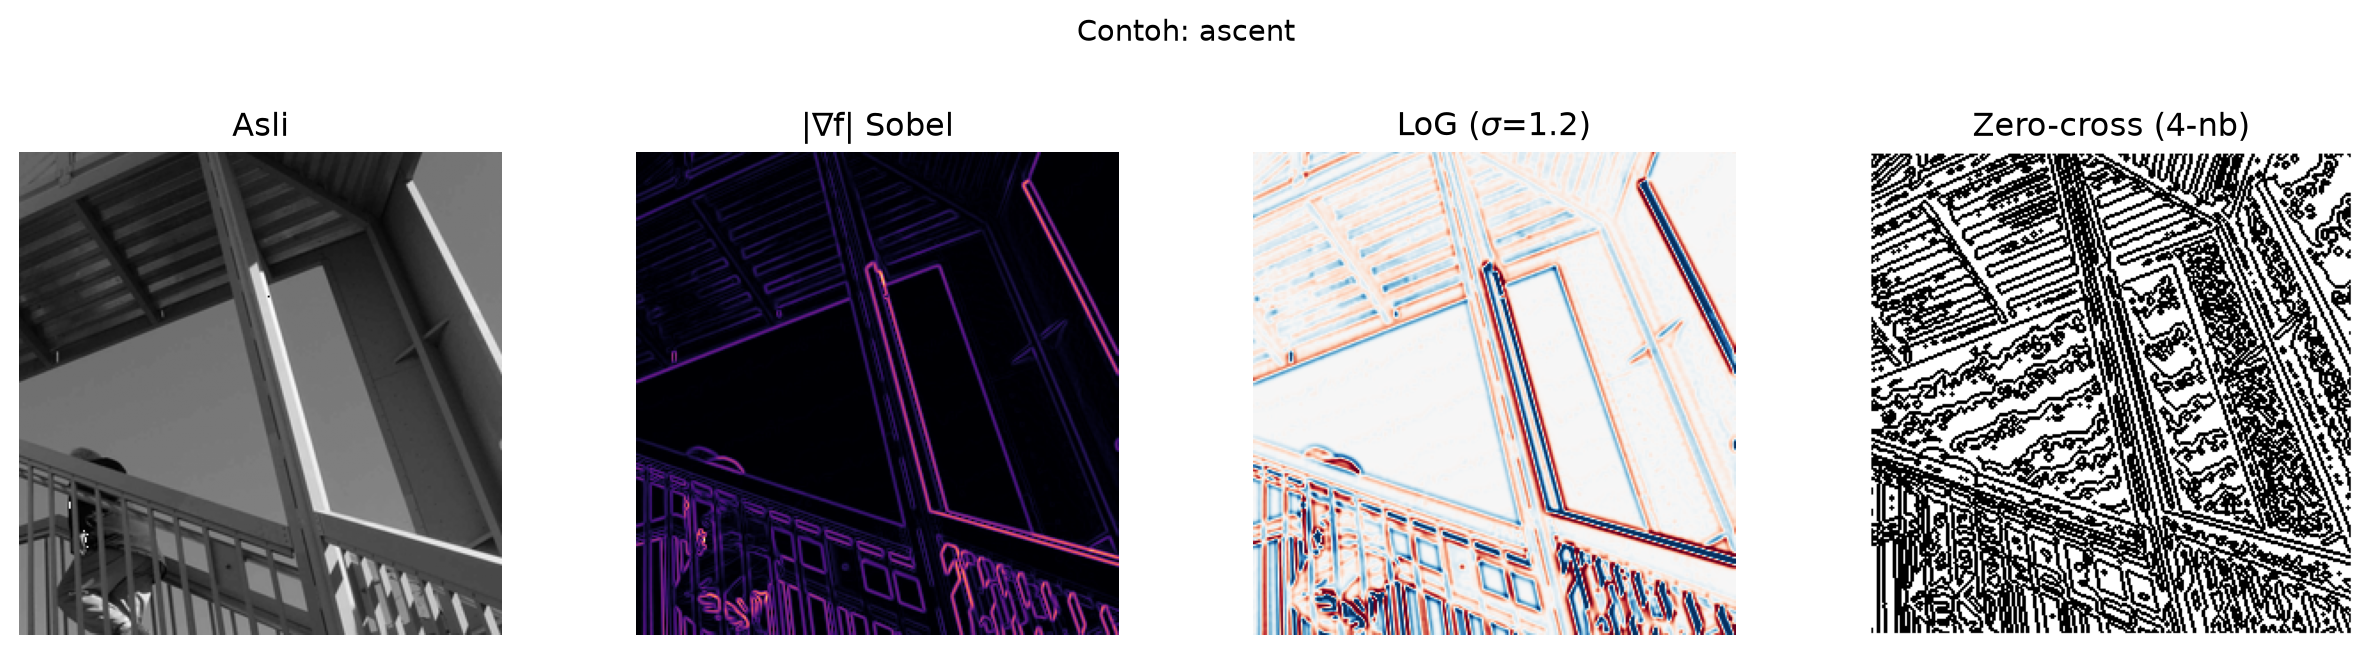
Potongan citra ascent (SciPy) dinormalisasi ke \([0,1]\); respons gradien dan LoG dihitung dengan reflect.
Gambar 1: ascent (crop): asli, magnitud Sobel, respons LoG (\(\sigma=1.2\)), dan petunjuk zero-crossing (perubahan tanda pada tetangga 4).
12 Contoh 2: citra face (luminansi)
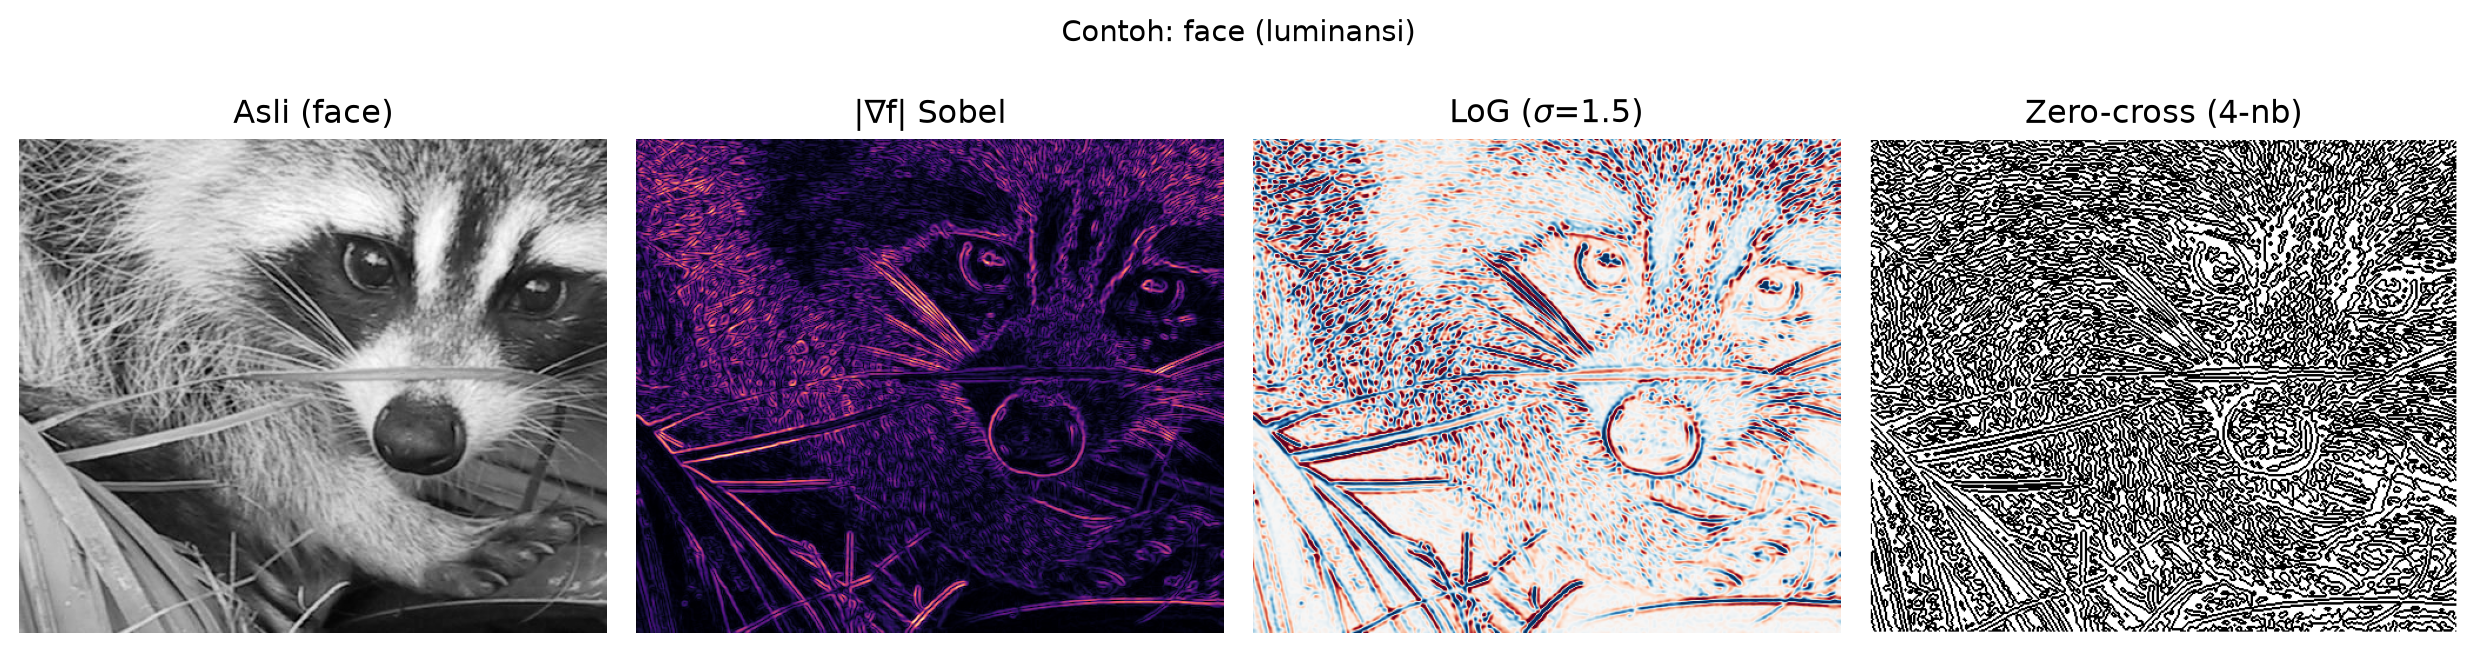
Citra wajah (scipy.datasets.face) dikonversi ke grayscale dengan koefisien ITU-R BT.601 (\(0.299R + 0.587G + 0.114B\)), lalu dipotong untuk fokus pada detail wajah. Perbandingan yang sama menunjukkan bahwa tekstur halus (rambut, pola kulit) menghasilkan respons gradien yang lebih “padat”, sedangkan LoG dengan \(\sigma\) sedang menonjolkan struktur skala menengah.
import matplotlibmatplotlib.use("Agg")import matplotlib.pyplot as pltimport numpy as npfrom scipy import ndimagedef _synthetic_luma_face(h=640, w=800):"""Pengganti deterministik bila `scipy.datasets.face` tidak tersedia (mis. tanpa pooch).""" rng = np.random.default_rng(42) yy, xx = np.mgrid[0:h, 0:w].astype(np.float64) cy, cx =0.42* h, 0.48* w yn, xn = (yy - cy) / (0.32* h), (xx - cx) / (0.28* w) g = np.exp(-((yn**2+ xn**2) **1.35)) g = g +0.18* np.sin(0.07* (xx + yy)) +0.05* rng.standard_normal((h, w)) g = g +0.12* np.sin(0.12* yy) * np.exp(-((xx - cx) **2) / ((0.11* w) **2+1e-9)) g = np.clip(g, 0, None)return (g - g.min()) / (g.max() - g.min() +1e-9)g =Nonetry:from scipy.datasets import face rgb = face() g =0.299* rgb[:, :, 0] +0.587* rgb[:, :, 1] +0.114* rgb[:, :, 2]exceptImportError:try:from scipy.datasets import ascent a = ascent().astype(np.float64)if a.shape[0] >=620and a.shape[1] >=780: g = aelse: g =NoneexceptImportError: g =Noneif g isNone: g = (_synthetic_luma_face() *255.0).astype(np.float64)g = g[200:620, 280:780]g = (g - g.min()) / (g.max() - g.min() +1e-9)sx = np.array([[-1, 0, 1], [-2, 0, 2], [-1, 0, 1]], dtype=np.float64)sy = np.array([[-1, -2, -1], [0, 0, 0], [1, 2, 1]], dtype=np.float64)mag = np.hypot( ndimage.convolve(g, sx, mode="reflect"), ndimage.convolve(g, sy, mode="reflect"),)sig =1.5log = ndimage.gaussian_laplace(g, sigma=sig)def zero_cross_4nb(L): z = np.zeros_like(L, dtype=bool) z[1:-1, 1:-1] = ( (np.sign(L[1:-1, 1:-1]) != np.sign(L[:-2, 1:-1]))| (np.sign(L[1:-1, 1:-1]) != np.sign(L[2:, 1:-1]))| (np.sign(L[1:-1, 1:-1]) != np.sign(L[1:-1, :-2]))| (np.sign(L[1:-1, 1:-1]) != np.sign(L[1:-1, 2:])) )return z.astype(np.float64)zp = zero_cross_4nb(log)def n01(a): a = np.asarray(a, dtype=np.float64) a = a - a.min()return a / (a.max() +1e-9)fig, axes = plt.subplots(1, 4, figsize=(13, 3.2))axes[0].imshow(g, cmap="gray")axes[0].set_title("Asli (face)")axes[1].imshow(n01(mag), cmap="magma")axes[1].set_title("|∇f| Sobel")axes[2].imshow(log, cmap="RdBu_r", vmin=-0.05, vmax=0.05)axes[2].set_title(rf"LoG ($\sigma$={sig})")axes[3].imshow(zp.astype(float), cmap="gray_r")axes[3].set_title("Zero-cross (4-nb)")for ax in axes: ax.axis("off")plt.suptitle("Contoh: face (luminansi)", fontsize=11, y=1.05)plt.tight_layout()fig
Gambar 2: face (crop, luminansi): asli, Sobel, LoG (\(\sigma=1.5\)), zero-cross 4-tetangga.