import numpy as np
import pandas as pd
from sklearn.datasets import fetch_california_housing
from sklearn.linear_model import LinearRegression, Ridge
from sklearn.metrics import mean_absolute_error, mean_squared_error, r2_score
from sklearn.model_selection import train_test_split
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler

housing = fetch_california_housing(as_frame=True)
X = housing.data
y = housing.target
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.25, random_state=42
)

def report_reg(name, y_true, y_pred):
    rmse = float(np.sqrt(mean_squared_error(y_true, y_pred)))
    mae = float(mean_absolute_error(y_true, y_pred))
    r2 = float(r2_score(y_true, y_pred))
    print(f"{name:22s} | RMSE={rmse:.4f} | MAE={mae:.4f} | R²={r2:.4f}")

y_mean = np.full_like(y_test, y_train.mean())
report_reg("Baseline (mean train)", y_test, y_mean)

ols = LinearRegression().fit(X_train, y_train)
report_reg("OLS (test)", y_test, ols.predict(X_test))

ridge = Pipeline(
    [("sc", StandardScaler()), ("m", Ridge(alpha=1.0))]
).fit(X_train, y_train)
report_reg("Ridge+scale (test)", y_test, ridge.predict(X_test))Metrik evaluasi & cross-validation model prediktif
Data Science — pertemuan ke-11
Anggit Wirasto, S.Si., M.Eng.
Tujuan pembelajaran
Setelah materi ini, mahasiswa diharapkan mampu:
- Menghitung dan menginterpretasikan metrik regresi: MAE, RMSE, dan \(R^2\) pada data uji, serta memilih metrik yang selaras dengan konteks bisnis.
- Membaca confusion matrix dan menghitung accuracy, precision, recall, dan F1-score (kasus biner dan multi-kelas).
- Merancang protokol cross-validation untuk estimasi performa yang stabil dan memilih hiperparameter tanpa “mengutak-atik” set uji.
- Membaca kurva ROC dan AUC untuk model probabilistik, serta memilih threshold operasional.
Prasyarat: regresi (DS-09) dan klasifikasi (DS-10). Materi ini memperdalam evaluasi model, bukan mengulang algoritme pembelajaran dari awal.
Peta materi (bab 9)
| Subbab | Fokus |
|---|---|
| 9.1 | Metrik regresi: MAE, RMSE, \(R^2\) |
| 9.2 | Metrik klasifikasi: confusion matrix, precision, recall, F1, ROC & AUC |
| 9.3 | Cross-validation — kestabilan skor & mitigasi overfitting |
Prinsip merentang semua subbab: ukur performa pada data yang belum dipakai untuk menyesuaikan model; dokumentasikan metrik utama sebelum eksperimen.
Mengapa evaluasi terpisah dari “memilih algoritme”?
Algoritme menjawab: bagaimana kita mempelajari \(f(x)\) dari data latih.
Evaluasi menjawab: seberapa baik \(f\) generalisasi pada observasi baru — dan metrik mana yang mencerminkan biaya kesalahan di dunia nyata.
Tanpa evaluasi yang disiplin, skor tinggi di latih sering berarti overfitting (menghafal noise), bukan model yang siap dipakai stakeholder atau pengguna akhir.
Protokol evaluasi yang disiplin
- Tetapkan metrik utama (dan metrik pendukung) sebelum melihat hasil uji.
- Pisahkan set latih / uji (atau validasi) — uji suci untuk laporan akhir.
- Semua transformasi (skala, imputasi, encoding) →
fitdi latih,transformdi uji (Pipeline). - Tuning hiperparameter → cross-validation di latih, bukan mengulang skor test.
- Deployment → simpan artefak (model + preprocessor) yang identik dengan yang dilatih.
9.1 — Metrik evaluasi regresi
Untuk target kontinu \(y_i\) dan prediksi \(\hat{y}_i\), \(i = 1,\ldots,n\) (biasanya \(n\) = ukuran set uji):
Mean Absolute Error (MAE):
\[ \mathrm{MAE} = \frac{1}{n}\sum_{i=1}^n |y_i - \hat{y}_i| \]
Root Mean Squared Error (RMSE):
\[ \mathrm{RMSE} = \sqrt{\frac{1}{n}\sum_{i=1}^n (y_i - \hat{y}_i)^2} \]
Koefisien determinasi (\(R^2\)):
\[ R^2 = 1 - \frac{\sum_i (y_i - \hat{y}_i)^2}{\sum_i (y_i - \bar{y})^2} \]
dengan \(\bar{y}\) = rata-rata \(y\) pada set yang sama (umumnya test).
MAE vs RMSE — kapan memakai yang mana?
| Metrik | Satuan | Sensitivitas | Kapan diprioritaskan |
|---|---|---|---|
| MAE | sama dengan \(y\) | residual besar dihitung linear | outlier moderat; laporan “rata-rata salah X rupiah/kWh” |
| RMSE | sama dengan \(y\) | residual besar dihukum kuadrat | selaras dengan optimasi MSE; penalti ekstrem lebih berat |
| \(R^2\) | tanpa satuan (skala 0–1, bisa negatif) | proporsi varians terjelaskan | perbandingan model pada dataset yang sama |
RMSE \(\geq\) MAE (kesenaksamaan Cauchy–Schwarz); jika RMSE jauh lebih besar dari MAE, sering ada beberapa prediksi yang sangat meleset.
\(R^2\) — bahasa awam & jebakan
Bahasa awam: \(R^2 \approx 0{,}85\) artinya model menjelaskan sekitar 85% variasi target dibandingkan model “tebak rata-rata saja” — pada data yang diukur.
Jebakan:
- \(R^2\) tinggi di latih, rendah di uji → kemungkinan overfitting.
- \(R^2\) negatif di uji → model lebih buruk dari prediksi konstan \(\bar{y}\).
- \(R^2\) tidak comparable antar dataset berbeda — bandingkan model pada split yang sama.
Demo regresi: MAE, RMSE, \(R^2\) (California housing)
Interpretasi: baseline memberi lantai performa; model ML harus secara jelas mengalahkannya pada metrik yang dipilih stakeholder.
Demo regresi: MAE, RMSE, \(R^2\) (California housing)
Baseline (mean train)  | RMSE=1.1503 | MAE=0.9100 | R²=-0.0000
OLS (test)             | RMSE=0.7356 | MAE=0.5297 | R²=0.5911
Ridge+scale (test)     | RMSE=0.7356 | MAE=0.5297 | R²=0.5911
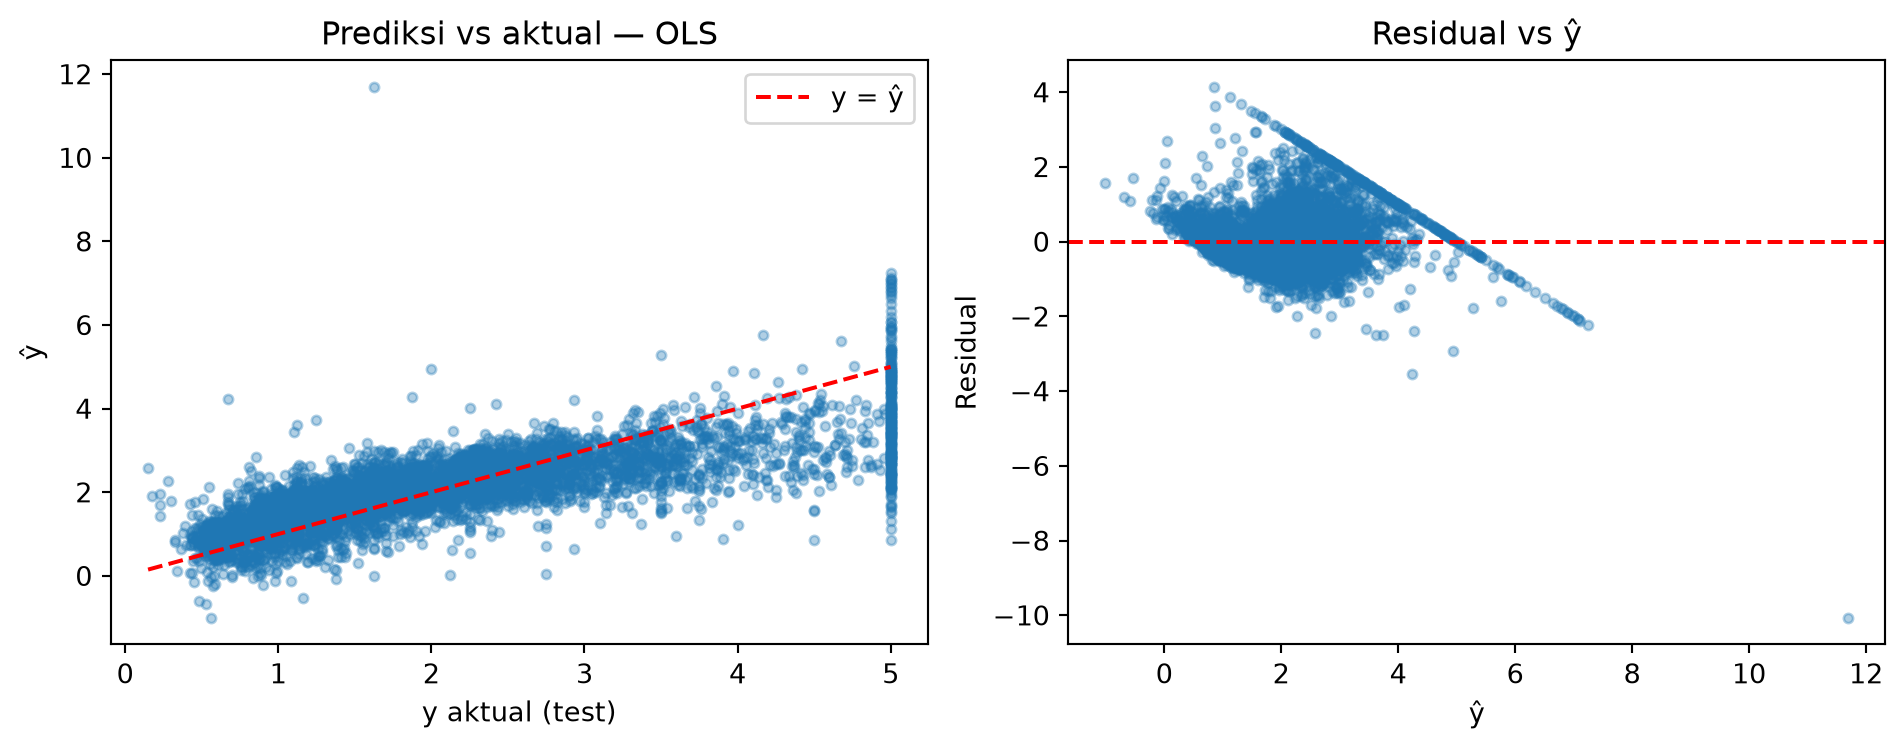
Visual regresi: prediksi vs aktual & residual
import matplotlib.pyplot as plt

pred = ols.predict(X_test)
fig, axes = plt.subplots(1, 2, figsize=(10, 4))
axes[0].scatter(y_test, pred, alpha=0.35, s=12)
lo, hi = y_test.min(), y_test.max()
axes[0].plot([lo, hi], [lo, hi], "r--", linewidth=1.5, label="y = ŷ")
axes[0].set_xlabel("y aktual (test)")
axes[0].set_ylabel("ŷ")
axes[0].set_title("Prediksi vs aktual — OLS")
axes[0].legend()

res = y_test - pred
axes[1].scatter(pred, res, alpha=0.35, s=12)
axes[1].axhline(0, color="red", linestyle="--")
axes[1].set_xlabel("ŷ")
axes[1].set_ylabel("Residual")
axes[1].set_title("Residual vs ŷ")
plt.tight_layout()
Awan titik mengikuti garis identitas → kalibrasi baik; residual berpola (mis. melengkung) → pertimbangkan transformasi atau model lebih fleksibel.
Visual regresi: prediksi vs aktual & residual
9.2 — Confusion matrix (klasifikasi biner)
Untuk kelas positif (indeks 1) dan negatif (0):
| Pred + | Pred − | |
|---|---|---|
| Aktual + | TP | FN |
| Aktual − | FP | TN |
TP = benar prediksi positif; FN = positif terlewat; FP = alarm palsu; TN = benar prediksi negatif.
Pada multi-kelas, matriks \(C \times C\): baris = label aktual, kolom = label prediksi; diagonal = benar per kelas.
Confusion matrix — bahasa awam
Bayangkan skrining penyakit: baris = kondisi pasien sebenarnya, kolom = keputusan model. Diagonal = tepat sasaran; sel lain = jenis salah yang tidak setara biayanya — mengira sehat padahal sakit (FN) sering lebih berbahaya daripada sebaliknya (FP), tergantung konteks.
Akurasi saja bisa menyesatkan jika 99% populasi sehat: model yang selalu bilang “sehat” tetap 99% akurat tetapi gagal total menemukan yang sakit.
Accuracy, precision, recall, F1 (biner)
\[ \mathrm{Accuracy} = \frac{TP + TN}{TP + TN + FP + FN} \]
\[ \mathrm{Precision} = \frac{TP}{TP + FP} \quad (\text{di antara yang diprediksi } +, \text{ berapa yang benar?}) \]
\[ \mathrm{Recall} = \frac{TP}{TP + FN} \quad (\text{di antara yang benar-benar } +, \text{ berapa yang tertangkap?}) \]
\[ F_1 = 2 \cdot \frac{\mathrm{Precision} \cdot \mathrm{Recall}}{\mathrm{Precision} + \mathrm{Recall}} \]
Precision penting jika FP mahal (spam filter salah blok email penting). Recall penting jika FN mahal (penyakit terlewat, fraud terlewat).
Demo klasifikasi: metrik pada data tidak seimbang
from sklearn.datasets import make_classification
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import (
    accuracy_score,
    classification_report,
    confusion_matrix,
    f1_score,
    precision_score,
    recall_score,
)
from sklearn.model_selection import train_test_split
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler

X, y = make_classification(
    n_samples=4000,
    n_features=12,
    weights=[0.92, 0.08],
    random_state=42,
)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.25, stratify=y, random_state=42
)
clf = Pipeline(
    [("sc", StandardScaler()), ("m", LogisticRegression(max_iter=500))]
).fit(X_train, y_train)
pred = clf.predict(X_test)

print("Confusion matrix (baris=aktual, kol=pred):\n", confusion_matrix(y_test, pred))
print("Accuracy:", round(accuracy_score(y_test, pred), 4))
print("Precision (+):", round(precision_score(y_test, pred), 4))
print("Recall (+):", round(recall_score(y_test, pred), 4))
print("F1 (+):", round(f1_score(y_test, pred), 4))
print("\n", classification_report(y_test, pred, digits=3))
Perhatikan recall kelas minoritas — sering metrik yang paling relevan untuk bisnis, bukan akurasi mentah.
Demo klasifikasi: metrik pada data tidak seimbang
Confusion matrix (baris=aktual, kol=pred):
 [[911   4]
 [ 25  60]]
Accuracy: 0.971
Precision (+): 0.9375
Recall (+): 0.7059
F1 (+): 0.8054

               precision    recall  f1-score   support

           0      0.973     0.996     0.984       915
           1      0.938     0.706     0.805        85

    accuracy                          0.971      1000
   macro avg      0.955     0.851     0.895      1000
weighted avg      0.970     0.971     0.969      1000
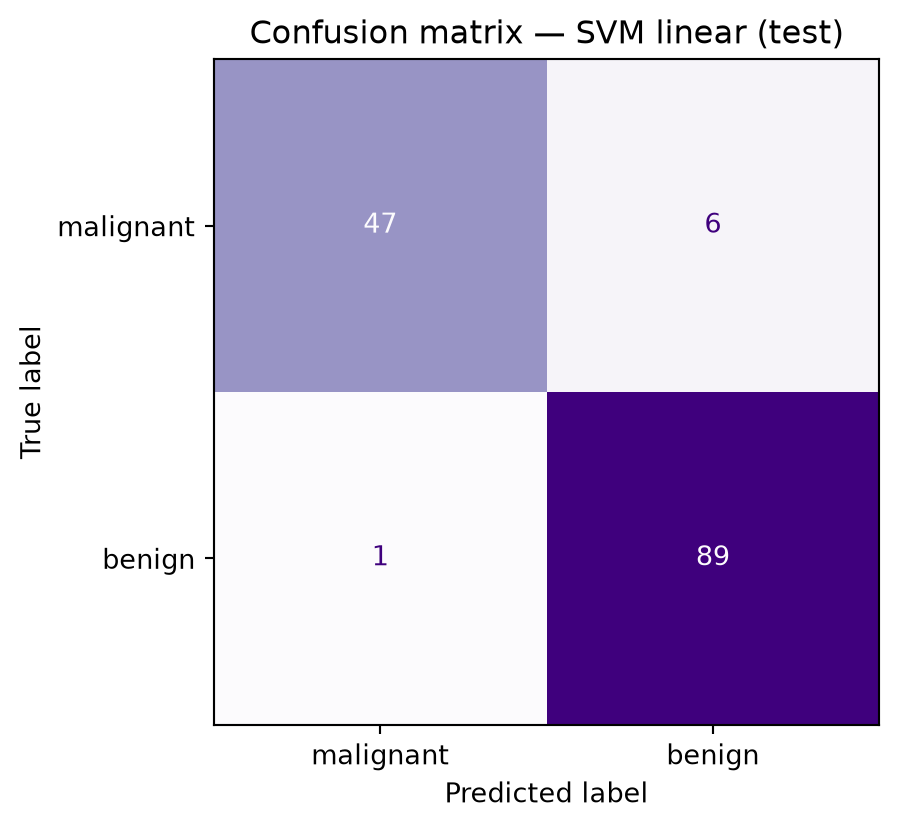
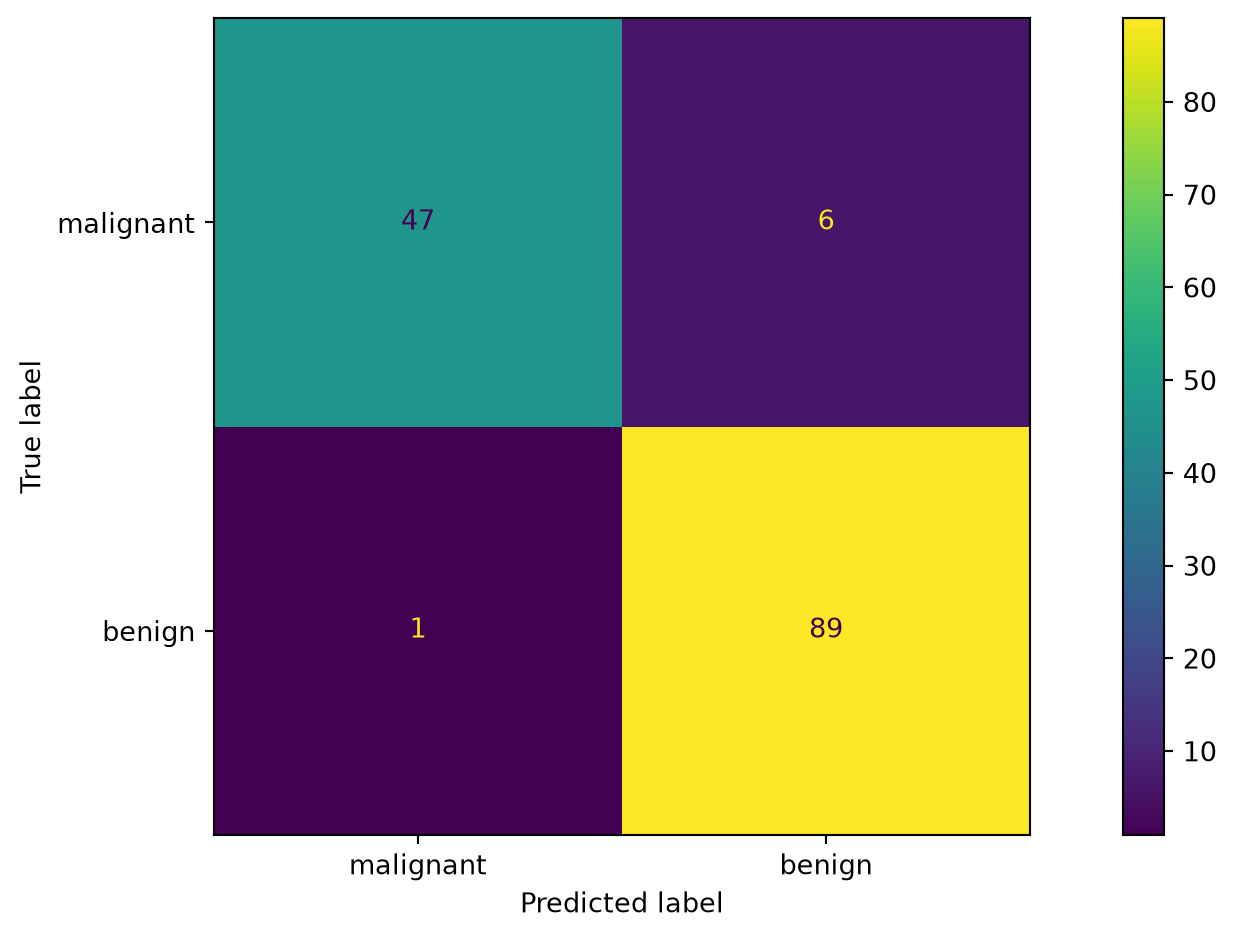
Confusion matrix — visual (Breast cancer)
import matplotlib.pyplot as plt
from sklearn.datasets import load_breast_cancer
from sklearn.metrics import ConfusionMatrixDisplay
from sklearn.model_selection import train_test_split
from sklearn.svm import SVC

data = load_breast_cancer()
X_train, X_test, y_train, y_test = train_test_split(
    data.data, data.target, test_size=0.25, stratify=data.target, random_state=42
)
clf = SVC(kernel="linear", C=1.0).fit(X_train, y_train)
pred = clf.predict(X_test)
fig, ax = plt.subplots(figsize=(5.5, 4.5))
ConfusionMatrixDisplay.from_predictions(
    y_test, pred, display_labels=data.target_names
).plot(ax=ax, cmap="Purples", colorbar=False)
ax.set_title("Confusion matrix — SVM linear (test)")
plt.tight_layout()
Confusion matrix — visual (Breast cancer)
Multi-kelas: macro vs weighted F1
- F1-macro: rata-rata F1 per kelas (bobot sama) — adil jika setiap kelas sama penting.
- F1-weighted: rata-rata berbobot ukuran kelas — mendekati akurasi jika kelas besar dominan.
sklearn.metrics.f1_score(..., average="macro"|"weighted"|"micro")
Micro-F1 pada multi-kelas sering setara dengan akurasi jika setiap observasi satu label.
Memilih metrik — contoh domain
| Konteks | Metrik yang sering diprioritaskan |
|---|---|
| Harga / permintaan (regresi) | RMSE + MAE; \(R^2\) sebagai pelengkap |
| Deteksi fraud / penyakit | Recall kelas positif, F1, PR-AUC (lanjutan) |
| Filter spam / rekomendasi iklan | Precision (kurangi gangguan FP) |
| Klasifikasi multi-kelas seimbang | F1-macro, confusion matrix per kelas |
| Model probabilistik / ranking skor | ROC & AUC; threshold operasional |
9.3 — Cross-validation: tujuan
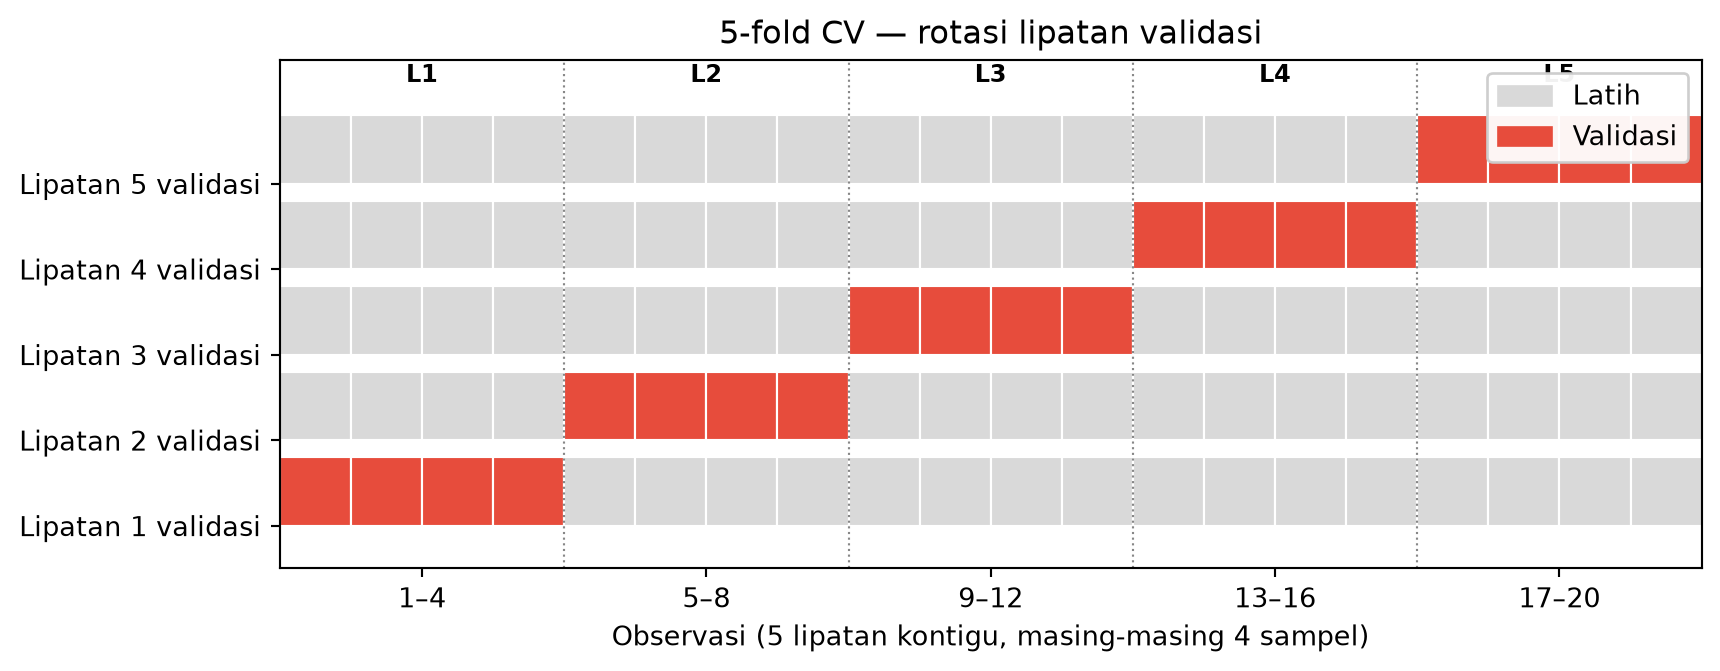
Cross-validation (CV) memecah set latih menjadi beberapa lipatan (fold):
- Model dilatih di \(k-1\) lipatan, dievaluasi di lipatan tersisa.
- Diulang \(k\) kali → distribusi skor validasi.
Manfaat:
- Estimasi performa lebih stabil daripada satu split kebetulan.
- Pemilihan hiperparameter tanpa menyentuh set uji.
- Mendeteksi variansi tinggi antar lipatan → model tidak stabil atau data kecil.
k-Fold CV — skema
import matplotlib.pyplot as plt
import matplotlib.patches as mpatches
import numpy as np

k = 5
n = 20
fold_size = n // k
train_color = (0.85, 0.85, 0.85, 1)
val_color = "#e74c3c"

fig, ax = plt.subplots(figsize=(9, 3.6))
for f in range(k):
    for i in range(n):
        is_val = (i // fold_size) == f
        ax.add_patch(
            plt.Rectangle(
                (i, f),
                1,
                0.8,
                color=val_color if is_val else train_color,
                ec="white",
                linewidth=0.8,
            )
        )

for b in range(1, k):
    ax.axvline(b * fold_size, color="#555555", linewidth=0.8, linestyle=":", alpha=0.7)

for b in range(k):
    ax.text(
        b * fold_size + fold_size / 2,
        k + 0.12,
        f"L{b + 1}",
        ha="center",
        va="bottom",
        fontsize=9,
        fontweight="bold",
    )

ax.set_xlim(0, n)
ax.set_ylim(-0.5, k + 0.45)
ax.set_yticks(range(k))
ax.set_yticklabels([f"Lipatan {i + 1} validasi" for i in range(k)])
ax.set_xlabel("Observasi (5 lipatan kontigu, masing-masing 4 sampel)")
ax.set_xticks([i * fold_size + fold_size / 2 for i in range(k)])
ax.set_xticklabels([f"{i * fold_size + 1}–{(i + 1) * fold_size}" for i in range(k)])
ax.set_title("5-fold CV — rotasi lipatan validasi")
ax.legend(
    handles=[
        mpatches.Patch(color=train_color, label="Latih"),
        mpatches.Patch(color=val_color, label="Validasi"),
    ],
    loc="upper right",
    framealpha=0.95,
)
plt.tight_layout()
k-Fold CV — skema
CV — bahasa awam
Alih-alih satu ujian mini, Anda mengadakan lima ujian bergilir pada data latih: setiap kali satu bagian disembunyikan sebagai “ujian sementara”, empat bagian lain untuk belajar. Rata-rata skor lima ujian memberi gambaran lebih adil daripada keberuntungan satu pembagian acak.
Set uji besar tetap disimpan untuk laporan akhir sekali — seperti ujian nasional yang tidak boleh dipakai saat latihan harian.
Stratified K-Fold & Repeated CV
StratifiedKFold: proporsi kelas di tiap lipatan mendekati proporsi global — penting untuk klasifikasi tidak seimbang.
RepeatedKFold / RepeatedStratifiedKFold: ulangi pembagian acak \(r\) kali → \(k \times r\) skor → estimasi mean ± std lebih andal (biaya komputasi naik).
Leave-One-Out (LOO): \(k = n\) — tidak bias tetapi sangat mahal untuk \(n\) besar.
Demo: cross_val_score & stabilitas
from sklearn.datasets import load_wine
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import StratifiedKFold, cross_val_score
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.svm import SVC

wine = load_wine()
X, y = wine.data, wine.target
pipe = Pipeline(
    [
        ("sc", StandardScaler()),
        ("m", SVC(kernel="rbf", C=2.0, gamma="scale")),
    ]
)
cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=42)
scores = cross_val_score(pipe, X, y, cv=cv, scoring="f1_macro")
print("F1-macro per lipatan:", np.round(scores, 3))
print("Mean ± std:", round(scores.mean(), 3), "±", round(scores.std(), 3))

rf = RandomForestClassifier(n_estimators=200, random_state=42)
scores_rf = cross_val_score(rf, X, y, cv=cv, scoring="f1_macro")
print("RF F1-macro mean ± std:", round(scores_rf.mean(), 3), "±", round(scores_rf.std(), 3))
Std kecil → performa relatif konsisten antar lipatan; std besar → waspadai data kecil, split tidak representatif, atau model tidak stabil.
Demo: cross_val_score & stabilitas
F1-macro per lipatan: [0.972 1.    0.971 1.    1.   ]
Mean ± std: 0.989 ± 0.014
RF F1-macro mean ± std: 0.978 ± 0.02
GridSearchCV — tuning tanpa bocor ke test
from sklearn.model_selection import GridSearchCV
from sklearn.neighbors import KNeighborsClassifier

param_grid = {"m__n_neighbors": [3, 5, 7, 11, 15]}
knn = Pipeline([("sc", StandardScaler()), ("m", KNeighborsClassifier())])
search = GridSearchCV(
    knn,
    param_grid,
    cv=StratifiedKFold(5, shuffle=True, random_state=42),
    scoring="f1_macro",
    n_jobs=-1,
)
search.fit(X, y)
print("Best k:", search.best_params_)
print("Best CV F1-macro:", round(search.best_score_, 3))
print("Best estimator (refit on full X):", search.best_estimator_)
best_score_ = rata-rata skor CV di data latih penuh — bukan skor test. Setelah memilih \(k\), baru evaluasi sekali pada X_test, y_test jika split tersedia.
GridSearchCV — tuning tanpa bocor ke test
Best k: {'m__n_neighbors': 15}
Best CV F1-macro: 0.979
Best estimator (refit on full X): Pipeline(steps=[('sc', StandardScaler()),
                ('m', KNeighborsClassifier(n_neighbors=15))])
Nested CV (gambaran)
Masalah: jika Anda memakai CV untuk tuning, lalu melaporkan skor CV yang sama sebagai estimasi performa final, estimasi bisa optimis.
Nested CV:
- Lipatan luar: estimasi performa generalisasi.
- Lipatan dalam: tuning hiperparameter.
Digunakan pada penelitian / dataset kecil; di industri sering cukup train / valid / test eksplisit.
Overfitting & peran CV
| Gejala | Skor latih | Skor CV / uji | Tindakan |
|---|---|---|---|
| Underfitting | rendah | rendah | model lebih kaya, fitur lebih baik |
| Pas (good fit) | baik | mendekati latih | dokumentasikan & deploy |
| Overfitting | sangat baik | jauh lebih rendah | regularisasi, kurangi kompleksitas, lebih banyak data, CV untuk tuning |
Kurva validasi (skor vs kompleksitas model) membantu memilih titik sweet spot — materi lanjutan sering memplot learning curve.
Train / validation / test (alternatif CV)
| Subset | Peran |
|---|---|
| Train | latih parameter model |
| Validation | pilih hiperparameter, early stopping |
| Test | laporan akhir sekali |
CV pada praktiknya membuat validation berputar di dalam train tanpa membuang data.
ROC & AUC (ringkas)
- Model probabilistik mengeluarkan skor \(P(Y{=}1 \mid x)\); threshold \(\tau\) menentukan label biner.
- TPR (= recall) vs FPR (\(= 1 -\) specificity) → kurva ROC; AUC merangkum pemisahan skor.
- AUC tinggi tidak menggantikan precision/recall pada threshold bisnis yang dipilih.
Alur end-to-end (satu halaman)
Data → validasi & split → Pipeline(latih) → CV tuning
     → evaluasi final (test) → dokumentasi metrik & versi
Setiap langkah harus terdokumentasi (versi data, seed, metrik, tanggal evaluasi).
Ringkasan
- 9.1 Regresi: MAE (robust, satuan \(y\)), RMSE (penalti ekstrem), \(R^2\) (proporsi varians; waspada overfitting & perbandingan lintas dataset).
- 9.2 Klasifikasi: confusion matrix; precision / recall / F1 / specificity; ROC & AUC untuk skor probabilistik.
- 9.3 CV: StratifiedKFold,
cross_val_score, GridSearchCV; set uji tetap suci; std skor CV → kestabilan.
Referensi
- James et al., An Introduction to Statistical Learning — validasi resampling, metrik klasifikasi.
- Dokumentasi scikit-learn:
metrics(roc_auc_score,RocCurveDisplay),model_selection,Pipeline.
MK Data Science 11 - Anggit Wirasto