import pandas as pd
from sklearn.datasets import load_wine
from sklearn.model_selection import train_test_split

wine = load_wine(as_frame=True)
X = wine.data
y = wine.target
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.25, stratify=y, random_state=42
)
print("Fitur:", list(X.columns[:5]), "...")
print("Bentuk X_train / X_test:", X_train.shape, X_test.shape)
print("Distribusi kelas (train):\n", y_train.value_counts().sort_index())
print("Distribusi kelas (test):\n", y_test.value_counts().sort_index())
print("\nContoh baris X_train:\n", X_train.head(3).to_string())Klasifikasi — persiapan data, kNN, pohon, hutan, SVM & Naive Bayes
Data Science — pertemuan ke-10
Anggit Wirasto, S.Si., M.Eng.
Tujuan pembelajaran
Setelah materi ini, mahasiswa diharapkan mampu:
- Merancang skenario pemodelan (target, fitur, metrik) dan memecah data menjadi set latih dan set uji secara reproduksibel dan representatif.
- Menjelaskan prinsip k-NN, memilih \(k\), serta memahami peran penskalaan fitur.
- Membedakan pohon keputusan, Random Forest, serta trade-off interpretabilitas vs performa.
- Mengoperasikan SVM (kernel linear / RBF) dan Gaussian Naive Bayes, lalu membandingkan performa klasifikasi dengan metrik yang sesuai.
- Menyampaikan ide utama tiap algoritme dalam bahasa awam (analogi) selain formulasi teknis.
Klasifikasi dalam supervised learning
Input: vektor fitur \(x \in \mathbb{R}^p\). Output: label kelas \(y \in \{1,\ldots,C\}\) (diskret).
Tujuan: mempelajari \(f_\theta(x)\) yang meminimumkan fungsi kerugian pada data latih (mis. log-loss untuk probabilitas kelas, atau proxy seperti error rate / 1 - akurasi) dan generalisasi baik pada data baru.
Catatan: akurasi saja bisa menyesatkan pada kelas tidak seimbang — gunakan juga precision/recall, F1, atau AUC-ROC (kasus biner).
Klasifikasi — bahasa awam
Klasifikasi artinya komputer membantu menjawab: “objek ini masuk kelompok mana?” — misalnya email spam atau bukan, transaksi curang atau normal, tanaman varietas A, B, atau C. Inputnya berupa angka-angka ciri (fitur); outputnya label diskret (nama kelas).
Bedanya dengan regresi (materi sebelumnya): jawaban yang diinginkan berupa kategori, bukan bilangan kontinu seperti harga atau suhu.
Persiapan pemodelan: tentukan skenario dulu
Sebelum memilih algoritme, jernihkan:
| Elemen | Pertanyaan panduan |
|---|---|
| Tujuan bisnis | Prediksi dini gagal mesin? penipuan? prioritas false positive vs false negative? |
| Target \(y\) | Label apa yang tersedia? apakah perlu agregasi waktu / entitas? |
| Fitur \(X\) | Apa yang diizinkan saat inferensi (tanpa kebocoran)? format missing? |
| Metrik | Akurasi cukup? atau F1-macro, balanced accuracy, cost-sensitive? |
| Baseline | Prediksi mayoritas kelas / aturan sederhana — untuk menilai apakah model ML layak. |
Deliverable awal: satu dokumen ringkas (setengah halaman) yang mengunci definisi \(y\) dan metrik utama.
Pembagian data: latih vs uji
Set latih (training): dipakai untuk mempelajari parameter model (dan sering hiperparameter via validasi silang).
Set uji (testing): hanya untuk estimasi performa final — tidak dipakai untuk menyesuaikan hiperparameter (kecuali dalam protokol nested CV).
Praktik umum: train_test_split(..., test_size=0.2–0.3, random_state=...) agar hasil reproduksibel.
Untuk klasifikasi dengan kelas tidak seimbang, gunakan stratify=y agar proporsi kelas di train/test mirip.
Latih vs uji — analogi awam
Set latih ibarat buku latihan soal: di sinilah model “berlatih” mencari pola. Set uji ibarat ujian resmi dengan soal yang sengaja tidak dipakai saat latihan — supaya kita tahu apakah pola yang dipelajari benar-benar berguna di situasi baru.
Kalau kita sengaja melihat jawaban ujian saat latihan (misalnya menghitung rata-rata fitur dari train + test sekaligus lalu memakainya untuk normalisasi), nilai ujian bisa terlihat bagus padahal menipu — itulah inti kebocoran data yang harus dihindari.
Demo: Wine — bentuk data & pembagian
Dataset Wine: 13 fitur kimia, 3 kelas kultivar — cocok untuk membandingkan beberapa klasifikator pada ruang fitur berdimensi sedang.
Demo: Wine — bentuk data & pembagian
Fitur: ['alcohol', 'malic_acid', 'ash', 'alcalinity_of_ash', 'magnesium'] ...
Bentuk X_train / X_test: (133, 13) (45, 13)
Distribusi kelas (train):
 target
0    44
1    53
2    36
Name: count, dtype: int64
Distribusi kelas (test):
 target
0    15
1    18
2    12
Name: count, dtype: int64

Contoh baris X_train:
      alcohol  malic_acid   ash  alcalinity_of_ash  magnesium  total_phenols  flavanoids  nonflavanoid_phenols  proanthocyanins  color_intensity   hue  od280/od315_of_diluted_wines  proline
8      14.83        1.64  2.17               14.0       97.0            2.8        2.98                  0.29             1.98             5.20  1.08                          2.85   1045.0
104    12.51        1.73  1.98               20.5       85.0            2.2        1.92                  0.32             1.48             2.94  1.04                          3.57    672.0
36     13.28        1.64  2.84               15.5      110.0            2.6        2.68                  0.34             1.36             4.60  1.09                          2.78    880.0
Kebocoran informasi (data leakage)
Kebocoran = informasi dari set uji (atau masa depan) “masuk” ke proses latih, sehingga skor test terlalu optimis.
| Contoh | Mengapa berbahaya |
|---|---|
| Standarisasi fit pada train+test sekaligus | Statistik test memengaruhi transformasi |
| Fitur yang hanya tersedia setelah kejadian target | Model “tahu jawaban” |
| Duplikat baris antara train dan test | Uji tidak independen |
Aturan emas: semua yang membutuhkan estimasi dari data (rata-rata, kategori langka, imputasi) → fit pada train, transform pada test — idealnya dalam Pipeline.
Validasi silang (k-fold) singkat
Untuk memilih \(k\) pada k-NN atau depth pohon, jangan memakai skor test berulang kali.
K-fold CV: data latih dibagi \(k\) lipatan; model dilatih di \(k-1\) lipatan, divalidasi di lipatan tersisa; diulang \(k\) kali → rata-rata metrik validasi.
Nested CV: lipatan luar untuk estimasi performa, lipatan dalam untuk tuning — dipakai jika anggaran komputasi memungkinkan.
Validasi silang — bahasa awam
Bayangkan Anda punya 5 set latihan bergantian: setiap kali Anda menyembunyikan satu set sebagai “ujian mini”, berlatih dengan 4 set lain, lalu cek skor di set yang disembunyikan. Diulang 5 kali lalu dirata-rata — itulah gambaran k-fold: estimasi seberapa bagus model di data yang belum dilihat dalam latihan, tanpa memakai set uji besar yang harusnya suci.
k-NN — bahasa awam
k-NN seperti bertanya ke tetangga terdekat di kompleks perumahan: “blok ini termasuk zona hijau atau biru?” Anda melihat k rumah paling dekat; jika kebanyakan tetangga zona hijau, Anda menjawab hijau. Tidak ada “rumus panjang” yang disimpan — yang disimpan hanya daftar rumah lama beserta labelnya; saat ada rumah baru, kita mengukur jarak ke semua (atau banyak) rumah lalu m voting.
Karena itu algoritme ini terasa sederhana, tetapi bisa lambat jika data sangat besar, dan sensitif terhadap satuan (misalnya harga dalam juta vs luas dalam m²) — seperti membandingkan jarak “rumah A” ke “rumah B” kalau satu sumbu pakai skala yang tidak adil.
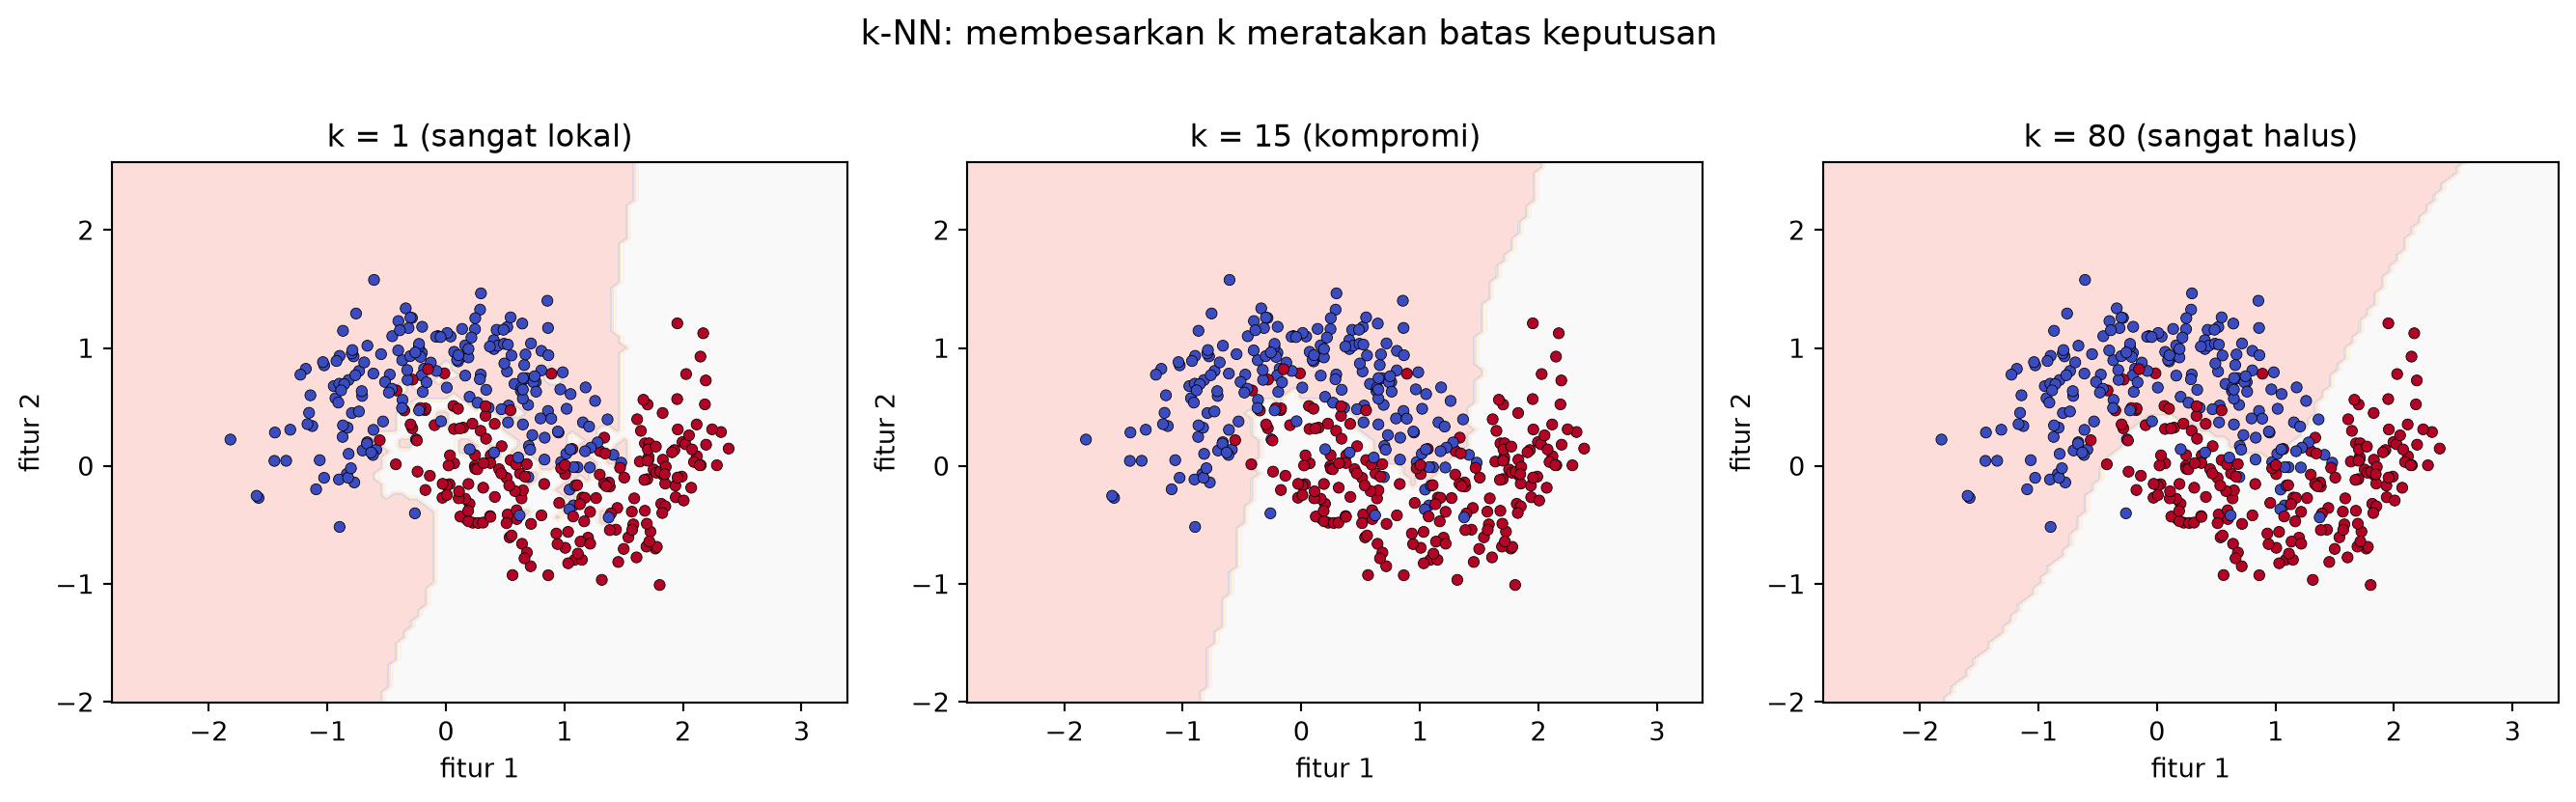
Grafik: pengaruh \(k\) pada batas keputusan (data sintetis)
Data dua bulan sabit (make_moons): \(k\) kecil → batas berlekuk mengikuti titik; \(k\) besar → batas lebih halus (suara mayoritas atas wilayah lebih luas).
import matplotlib.pyplot as plt
import numpy as np
from sklearn.datasets import make_moons
from sklearn.inspection import DecisionBoundaryDisplay
from sklearn.neighbors import KNeighborsClassifier

X_m, y_m = make_moons(n_samples=400, noise=0.28, random_state=5)
fig, axes = plt.subplots(1, 3, figsize=(14, 4.2))
for ax, k, title in zip(
    axes,
    [1, 15, 80],
    ["k = 1 (sangat lokal)", "k = 15 (kompromi)", "k = 80 (sangat halus)"],
):
    knn = KNeighborsClassifier(n_neighbors=k, weights="uniform")
    knn.fit(X_m, y_m)
    DecisionBoundaryDisplay.from_estimator(
        knn, X_m, response_method="predict", ax=ax, alpha=0.45, cmap="Pastel1"
    )
    ax.scatter(X_m[:, 0], X_m[:, 1], c=y_m, cmap="coolwarm", edgecolors="k", s=18, linewidths=0.3)
    ax.set_title(title)
    ax.set_xlabel("fitur 1")
    ax.set_ylabel("fitur 2")
plt.suptitle("k-NN: membesarkan k meratakan batas keputusan", y=1.02, fontsize=13)
plt.tight_layout()
Grafik: pengaruh \(k\) pada batas keputusan (data sintetis)
K-Nearest Neighbors (k-NN) — definisi
k-NN (k-Nearest Neighbors) adalah klasifikator berbasis contoh (instance-based): ia tidak memperkirakan parameter global seperti bobot regresi; ia menyimpan data latih \(\{(x_i, y_i)\}_{i=1}^n\) dan, saat ada titik uji \(x\), mencari \(k\) titik latih yang paling dekat menurut suatu jarak di \(\mathbb{R}^p\).
Aturan prediksi (klasifikasi): misalkan indeks tetangga terdekat adalah \(\mathcal{N}_k(x)\). Prediksi sering berupa suara mayoritas:
\[ \hat{y}(x) = \arg\max_{c \in \{1,\ldots,C\}} \sum_{i \in \mathcal{N}_k(x)} \mathbb{1}[y_i = c] \]
Dengan pembobotan jarak (weights='distance' di sklearn), suara titik \(i\) diperbesar sebanding \(1/d(x,x_i)\) sehingga tetangga sangat dekat lebih berpengaruh.
k-NN: “latih” vs inferensi
Fase latih (training): secara konseptual hanya menyimpan matriks fitur dan label — kompleksitas penyimpanan \(O(np)\).
Fase prediksi: untuk satu \(x\), perlu menghitung jarak ke (setidaknya) seluruh titik latih → \(O(np)\) per prediksi naif; struktur data seperti k-d tree atau ball tree dapat mempercepat di dimensi tidak terlalu tinggi.
Karena itu k-NN cocok untuk dataset tidak terlalu besar; untuk skala besar sering dipakai approximate nearest neighbors (kuliah lanjutan) atau model parametrik lain.
Metrik jarak yang umum
Untuk dua titik \(a, b \in \mathbb{R}^p\):
- Euclidean (default di sklearn): \(d(a,b) = \bigl(\sum_{j=1}^p (a_j-b_j)^2\bigr)^{1/2}\)
- Manhattan (\(L_1\)): \(d(a,b) = \sum_{j=1}^p |a_j-b_j|\)
- Minkowski (\(L_q\)): generalisasi; \(q=2\) → Euclidean, \(q=1\) → Manhattan
Parameter p di KNeighborsClassifier(metric='minkowski', p=...) mengatur eksponen tersebut.
Fitur kategorik tidak langsung masuk jarak Euclidean — perlu encoding (one-hot, ordinal hati-hati) atau metrik campuran.
Peran \(k\) dalam bias–variansi (intuisi)
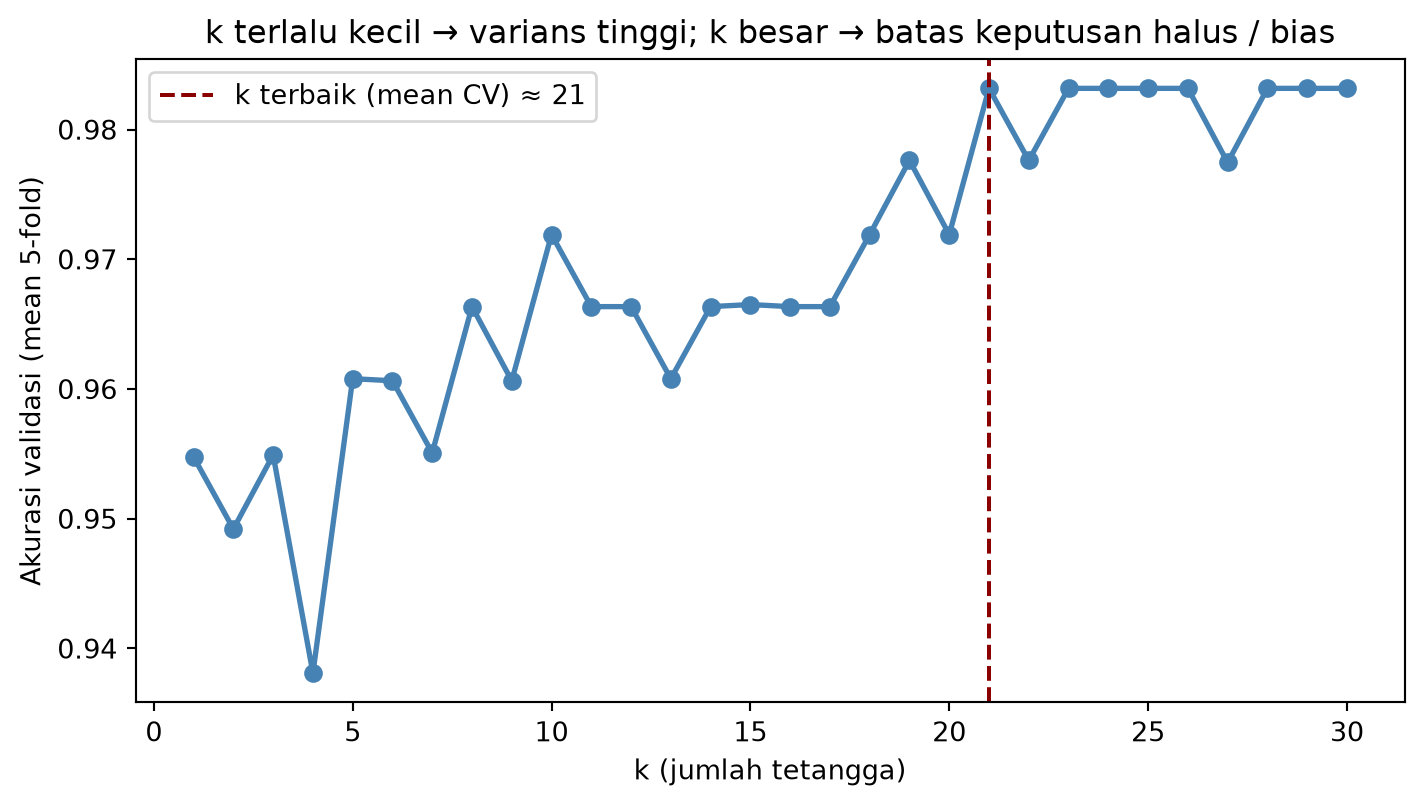
- \(k\) kecil (mis. 1): setiap prediksi mengikuti satu tetangga terdekat → batas keputusan sangat berlekuk; akurasi latih sering sangat tinggi (bahan hingga sempurna) tetapi prediksi tidak stabil terhadap noise dan variasi sampel (varians tinggi).
- \(k\) besar: prediksi dirata-ratakan atas banyak tetangga → permukaan keputusan lebih halus → bias naik, varians turun — mirip efek regularisasi; jika \(k \to n\), prediksi mendekati kelas mayoritas global.
Pemilihan \(k\) sebaiknya memakai validasi silang pada set latih, bukan mengutak-atik skor set uji.
Mengapa k-NN sensitif terhadap skala?
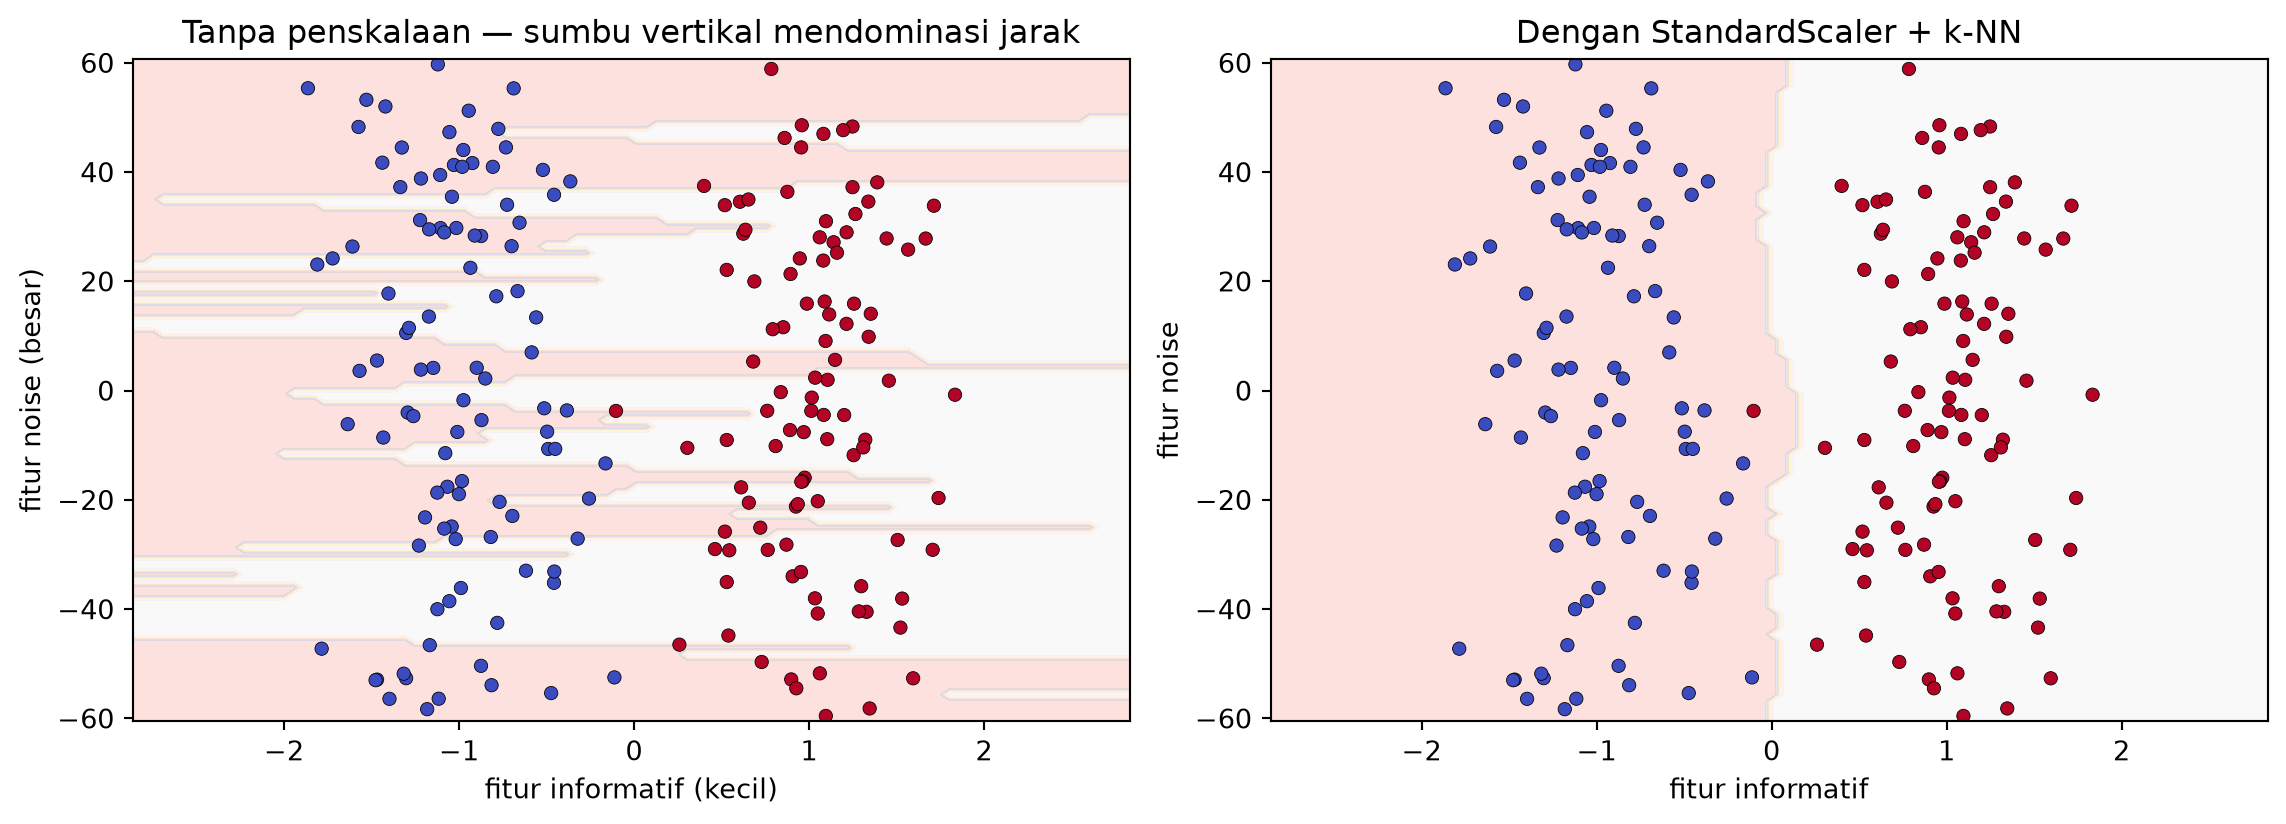
Fitur dengan rentang besar (mis. massa gram) mendominasi jarak dibanding fitur kecil (mis. rasio 0–1).
Solusi: StandardScaler atau MinMaxScaler di dalam Pipeline sebelum KNeighborsClassifier.
Grafik: mengapa penskalaan penting untuk k-NN?
Dua kelas dipisahkan sejajar sumbu horizontal (fitur kiri informatif, skala kecil). Sumbu vertikal hanya noise dengan rentang besar. Tanpa penskalaan, jarak Euclidean didominasi sumbu vertikal → batas salah; dengan StandardScaler, kedua sumbu setara → batas mengikuti pemisah sebenarnya.
import matplotlib.pyplot as plt
import numpy as np
from sklearn.inspection import DecisionBoundaryDisplay
from sklearn.neighbors import KNeighborsClassifier
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler

rng = np.random.default_rng(8)
n = 200
# Kelas dipisahkan di x0; x1 noise skala besar
x0 = np.concatenate([rng.normal(-1.0, 0.35, n // 2), rng.normal(1.0, 0.35, n // 2)])
x1 = rng.uniform(-60, 60, size=n)
Xb = np.column_stack([x0, x1])
yb = np.array([0] * (n // 2) + [1] * (n // 2))

fig, axes = plt.subplots(1, 2, figsize=(12, 4.4))
raw = KNeighborsClassifier(n_neighbors=11, weights="uniform")
raw.fit(Xb, yb)
DecisionBoundaryDisplay.from_estimator(
    raw, Xb, response_method="predict", ax=axes[0], alpha=0.4, cmap="Pastel1"
)
axes[0].scatter(Xb[:, 0], Xb[:, 1], c=yb, cmap="coolwarm", edgecolors="k", s=25, linewidths=0.3)
axes[0].set_title("Tanpa penskalaan — sumbu vertikal mendominasi jarak")
axes[0].set_xlabel("fitur informatif (kecil)")
axes[0].set_ylabel("fitur noise (besar)")

scaled = Pipeline(
    [
        ("sc", StandardScaler()),
        ("knn", KNeighborsClassifier(n_neighbors=11, weights="uniform")),
    ]
)
scaled.fit(Xb, yb)
DecisionBoundaryDisplay.from_estimator(
    scaled, Xb, response_method="predict", ax=axes[1], alpha=0.4, cmap="Pastel1"
)
axes[1].scatter(Xb[:, 0], Xb[:, 1], c=yb, cmap="coolwarm", edgecolors="k", s=25, linewidths=0.3)
axes[1].set_title("Dengan StandardScaler + k-NN")
axes[1].set_xlabel("fitur informatif")
axes[1].set_ylabel("fitur noise")
plt.tight_layout()
Grafik: mengapa penskalaan penting untuk k-NN?
Kurva akurasi validasi vs \(k\) (data Wine)
import matplotlib.pyplot as plt
import numpy as np
from sklearn.datasets import load_wine
from sklearn.model_selection import StratifiedKFold, cross_val_score
from sklearn.neighbors import KNeighborsClassifier
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler

X, y = load_wine(return_X_y=True)
cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=0)
ks = np.arange(1, 31)
means = []
for k in ks:
    pipe = Pipeline(
        [
            ("sc", StandardScaler()),
            ("knn", KNeighborsClassifier(n_neighbors=int(k))),
        ]
    )
    scores = cross_val_score(pipe, X, y, cv=cv, scoring="accuracy")
    means.append(scores.mean())

best_k = int(ks[int(np.argmax(means))])
fig, ax = plt.subplots(figsize=(7.5, 4.3))
ax.plot(ks, means, "o-", color="steelblue", linewidth=2)
ax.axvline(best_k, color="darkred", linestyle="--", label=f"k terbaik (mean CV) ≈ {best_k}")
ax.set_xlabel("k (jumlah tetangga)")
ax.set_ylabel("Akurasi validasi (mean 5-fold)")
ax.set_title("k terlalu kecil → varians tinggi; k besar → batas keputusan halus / bias")
ax.legend()
plt.tight_layout()
Kurva akurasi validasi vs \(k\) (data Wine)
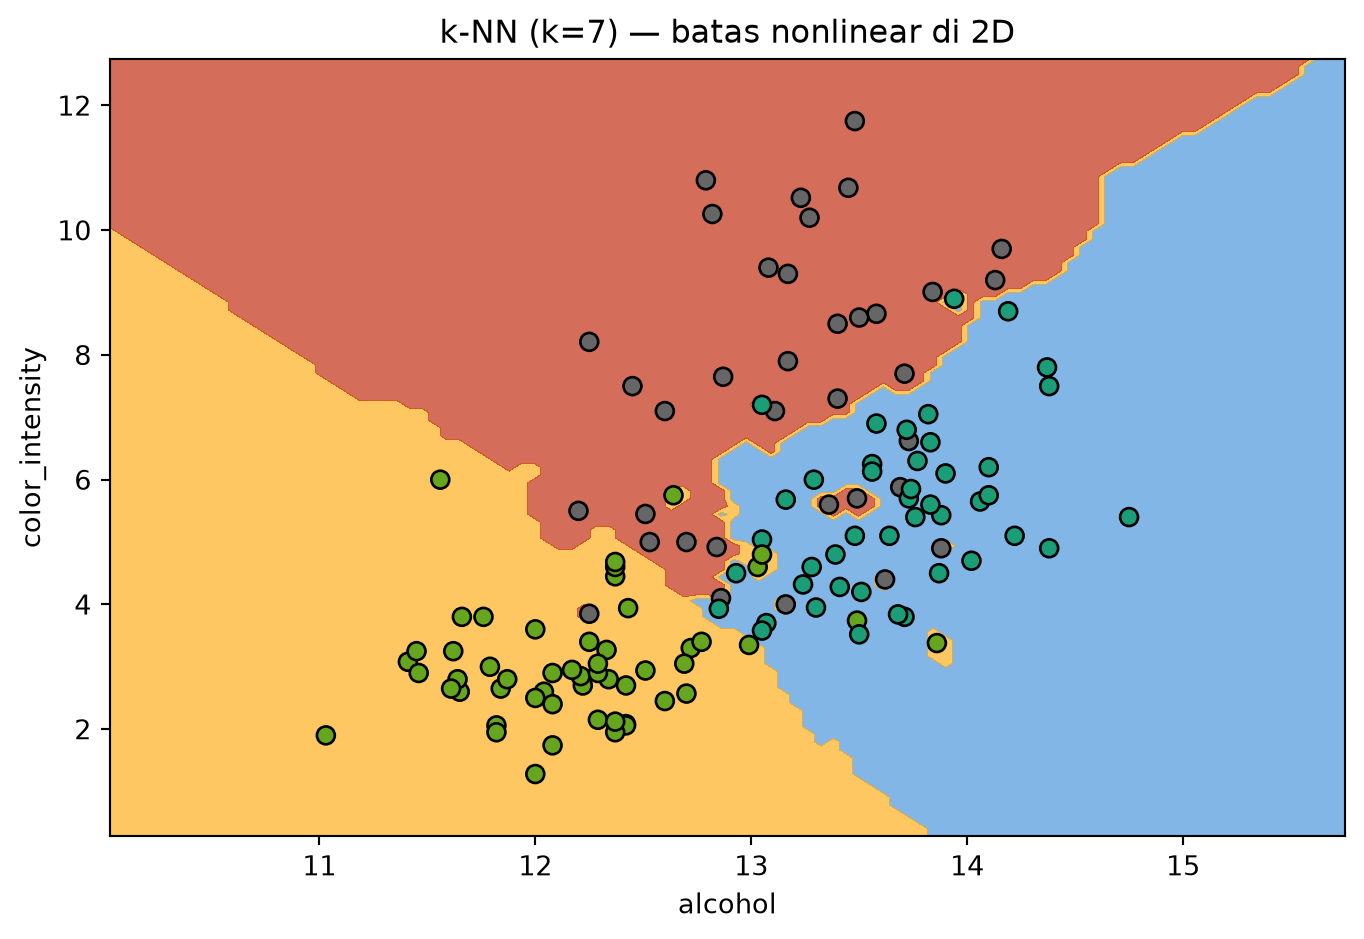
Batas keputusan k-NN (proyeksi 2 fitur)
import matplotlib.pyplot as plt
import numpy as np
from sklearn.datasets import load_wine
from sklearn.inspection import DecisionBoundaryDisplay
from sklearn.model_selection import train_test_split
from sklearn.neighbors import KNeighborsClassifier
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler

wine = load_wine()
X = wine.data[:, [0, 9]]  # alcohol, color_intensity
y = wine.target
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.25, stratify=y, random_state=1
)
clf = Pipeline(
    [
        ("sc", StandardScaler()),
        ("knn", KNeighborsClassifier(n_neighbors=7, weights="distance")),
    ]
)
clf.fit(X_train, y_train)
fig, ax = plt.subplots(figsize=(7.2, 5))
DecisionBoundaryDisplay.from_estimator(
    clf,
    X_train,
    response_method="predict",
    cmap="Pastel2",
    ax=ax,
    alpha=0.65,
)
scatter = ax.scatter(X_train[:, 0], X_train[:, 1], c=y_train, cmap="Dark2", edgecolor="k", s=45)
ax.set_xlabel(wine.feature_names[0])
ax.set_ylabel(wine.feature_names[9])
ax.set_title("k-NN (k=7) — batas nonlinear di 2D")
plt.tight_layout()
Batas keputusan k-NN (proyeksi 2 fitur)
Pohon keputusan — bahasa awam
Pohon keputusan seperti alur kerja di meja layanan: “Apakah usia di atas 60? Jika ya, cek tekanan darah; jika tidak, cek gejala lain…” Setiap pertanyaan memecah antrian menjadi dua (atau lebih) kelompok sampai tiba di kesimpulan (daun): “prioritas tinggi / rendah”. Keuntungannya: aturan mudah dibaca manusia dan diaudit (“mengapa kasus ini masuk cabang kiri?”).
Kelemahan: jika pertanyaan terlalu banyak dan terlalu detail mengikuti noise data latih, aturan itu bagus di latihan tetapi kaku di ujian — seperti menghafal contoh soal tanpa prinsip.
Decision Tree — apa yang dimodelkan?
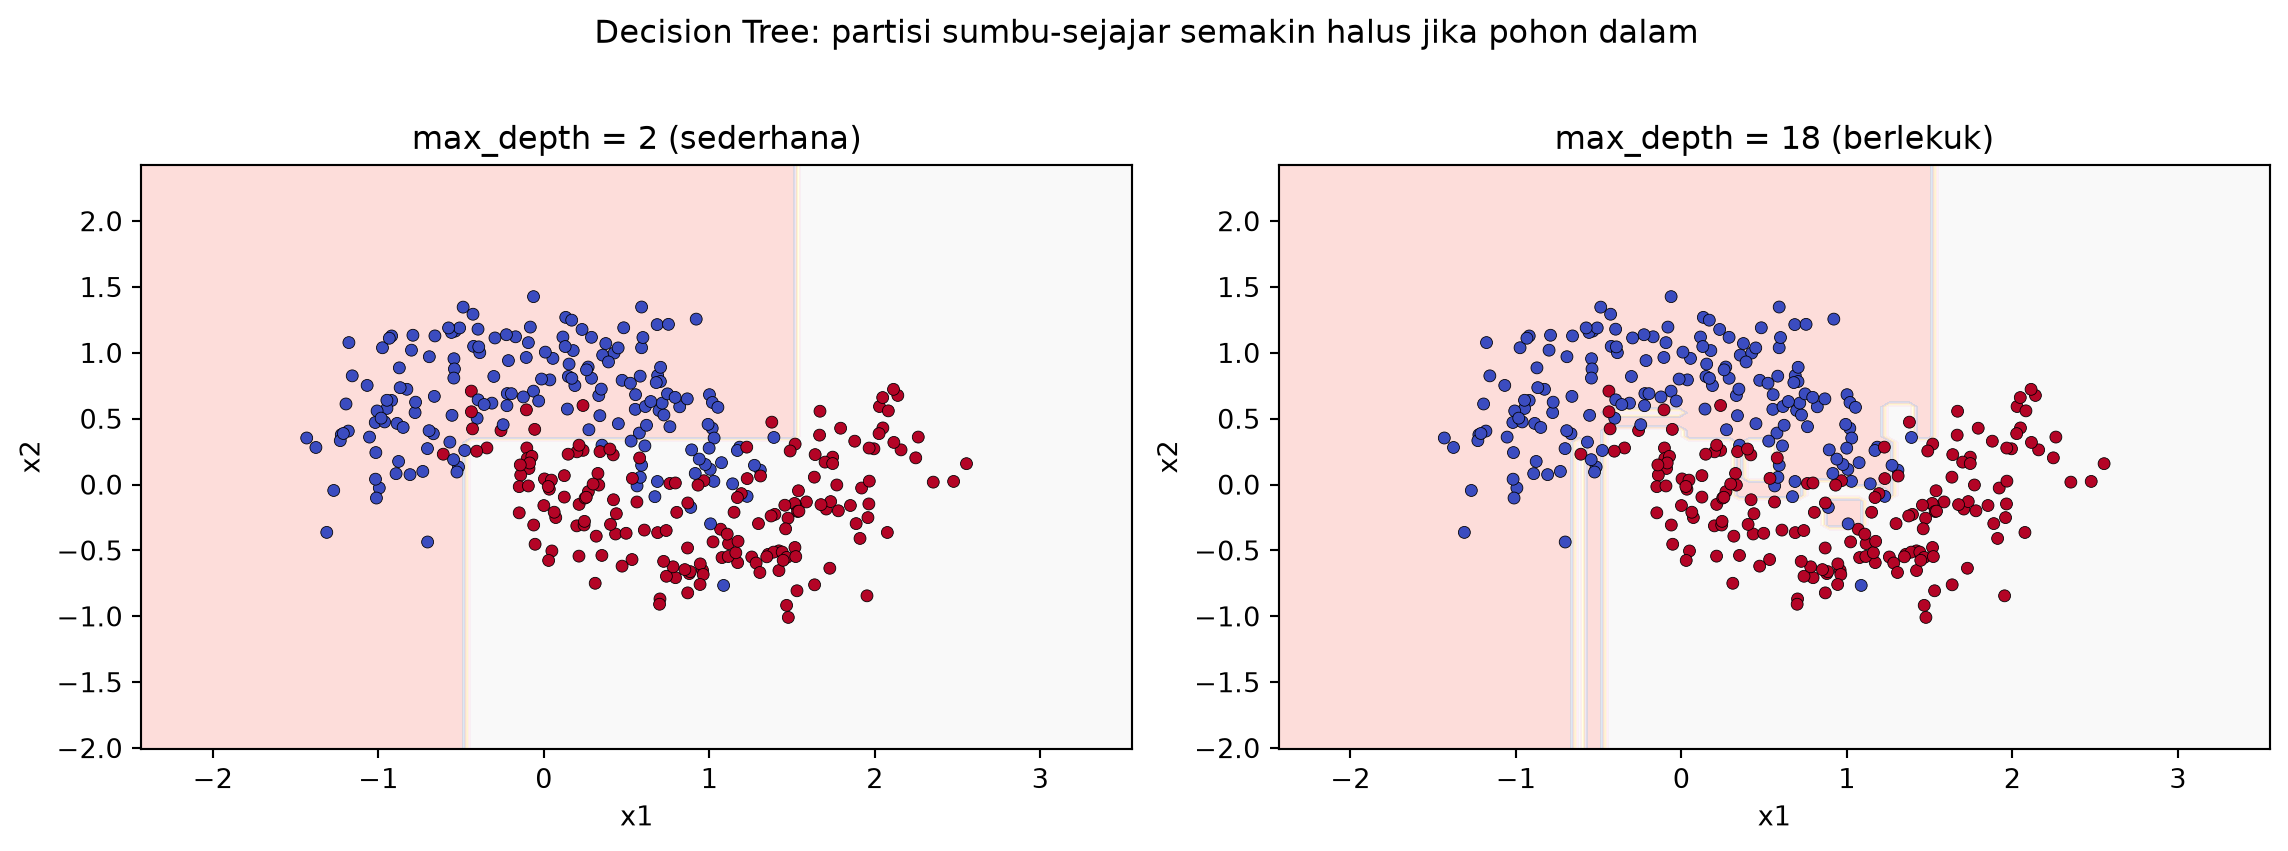
Pohon keputusan mempartisi ruang fitur \(\mathbb{R}^p\) menjadi kumpulan region (biasanya kotak sumbu-sejajar / axis-aligned): di setiap region, prediksi adalah konstan (klasifikasi: kelas mayoritas di daun; regresi: rata-rata target).
Secara formal, model adalah fungsi piecewise constant:
\[ f(x) = \sum_{m=1}^{M} c_m \, \mathbb{1}[x \in R_m] \]
dengan \(\{R_m\}\) disjoint region yang dibangun oleh rangkaian split jika \(x_j \leq t\) vs lainnya.
Kelebihan: aturan if–else mudah diaudit; menangkap nonlinearitas dan interaksi antar fitur tanpa mendefinisikan basis manual.
Kelemahan: pohon dalam saja varians tinggi (sensitif terhadap variasi sampel dan noise); sedikit perubahan data bisa mengubah struktur pohon.
Bagaimana split dipilih? (greedy, binary)
Algoritme CART (Classification and Regression Trees) membangun pohon rekursif: pada setiap simpul, cari pasangan (fitur \(j\), ambang \(t\)) yang meminimumkan impurity gabungan anak kiri/kanan.
Impurity umum untuk klasifikasi:
- Gini: \(G = \sum_{c=1}^{C} \hat{p}_c(1-\hat{p}_c)\) — probabilitas \(\hat{p}_c\) dihitung dari proporsi kelas di simpul.
- Entropi / devians informasi: \(H = -\sum_c \hat{p}_c \log \hat{p}_c\).
Sklearn memakai Gini secara default (criterion='gini'); criterion='entropy' memakai entropi Shannon.
Greedy: split lokal optimal tidak menjamin pohon global optimal — tetapi cepat dan skalabel.
Mengendalikan kompleksitas pohon
Hiperparameter penting: max_depth, min_samples_leaf, max_leaf_nodes, ccp_alpha (pemangkasan biaya-kompleksitas).
import matplotlib.pyplot as plt
from sklearn.datasets import load_wine
from sklearn.metrics import accuracy_score
from sklearn.model_selection import train_test_split
from sklearn.tree import DecisionTreeClassifier, plot_tree

X, y = load_wine(return_X_y=True)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.25, stratify=y, random_state=42
)
dt = DecisionTreeClassifier(max_depth=3, random_state=42)
dt.fit(X_train, y_train)
print("Akurasi train:", round(accuracy_score(y_train, dt.predict(X_train)), 3))
print("Akurasi test :", round(accuracy_score(y_test, dt.predict(X_test)), 3))

fig, ax = plt.subplots(figsize=(11, 3.8))
plot_tree(dt, feature_names=list(load_wine().feature_names), class_names=list(load_wine().target_names), filled=True, ax=ax, fontsize=7)
plt.title("Pohon dangkal (max_depth=3) — Wine")
plt.tight_layout()
Mengendalikan kompleksitas pohon
Akurasi train: 0.992
Akurasi test : 0.956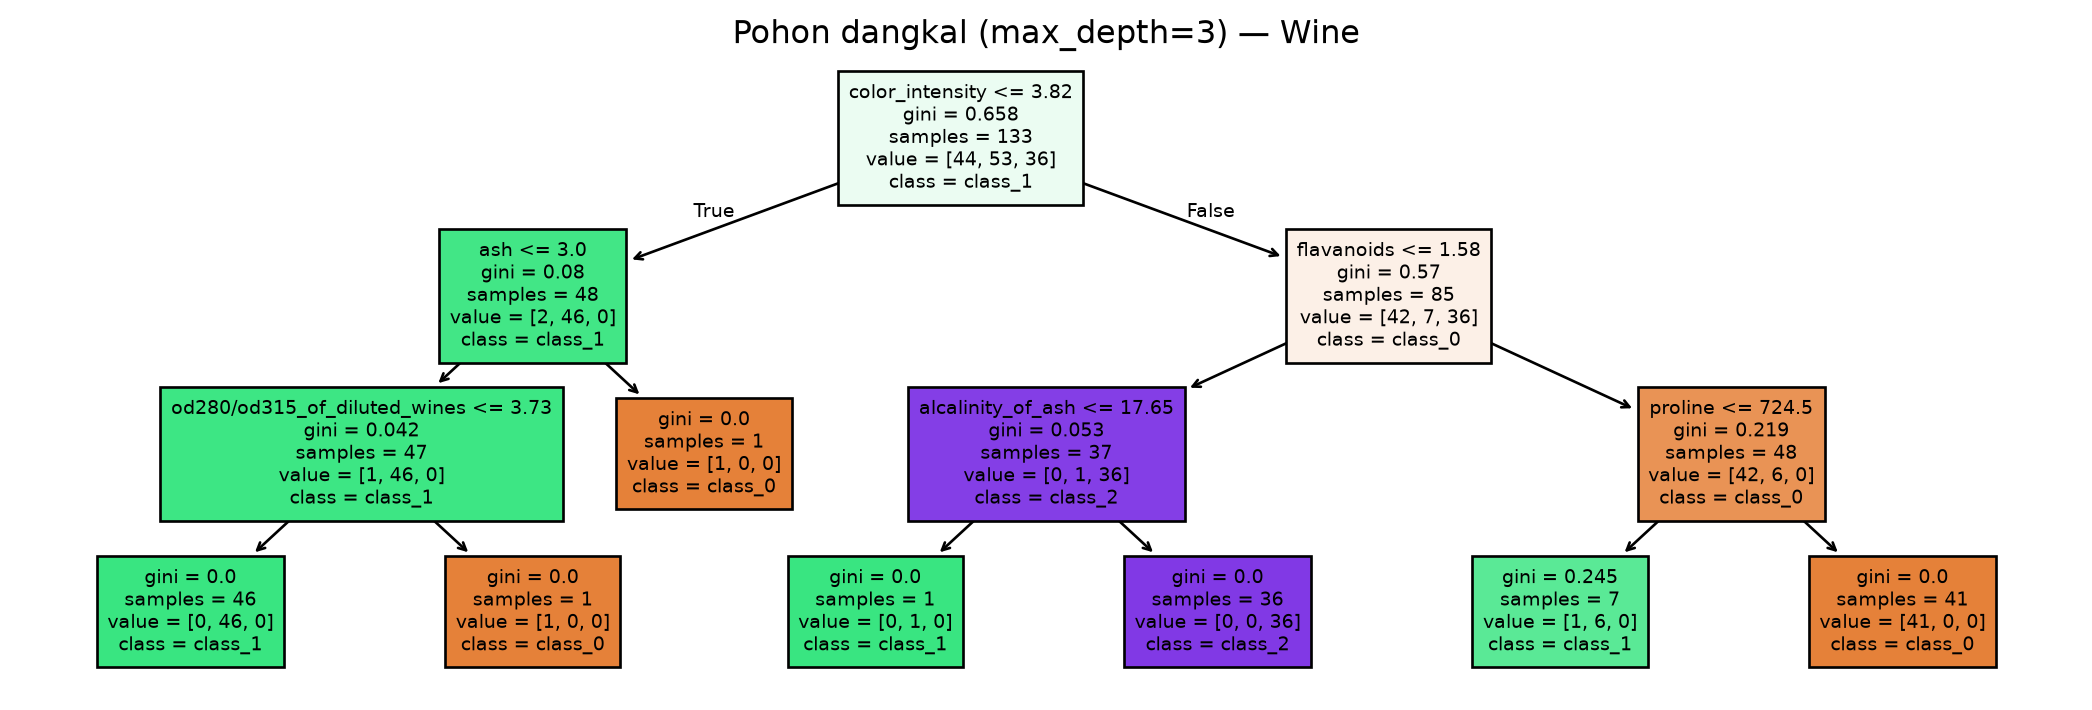
Grafik: pohon — kedalaman vs bentuk batas (2D)
Pada data sabitan 2D: pohon dangkal memberi partisi kotak-kotak kasar; pohon dalam mengejar detail (risiko overfit pada noise).
import matplotlib.pyplot as plt
from sklearn.datasets import make_moons
from sklearn.inspection import DecisionBoundaryDisplay
from sklearn.tree import DecisionTreeClassifier

Xm, ym = make_moons(n_samples=350, noise=0.25, random_state=2)
fig, axes = plt.subplots(1, 2, figsize=(12, 4.3))
for ax, depth, title in zip(
    axes,
    [2, 18],
    ["max_depth = 2 (sederhana)", "max_depth = 18 (berlekuk)"],
):
    dt = DecisionTreeClassifier(max_depth=depth, random_state=0)
    dt.fit(Xm, ym)
    DecisionBoundaryDisplay.from_estimator(
        dt, Xm, response_method="predict", ax=ax, alpha=0.45, cmap="Pastel1"
    )
    ax.scatter(Xm[:, 0], Xm[:, 1], c=ym, cmap="coolwarm", edgecolors="k", s=20, linewidths=0.3)
    ax.set_title(title)
    ax.set_xlabel("x1")
    ax.set_ylabel("x2")
plt.suptitle("Decision Tree: partisi sumbu-sejajar semakin halus jika pohon dalam", y=1.02)
plt.tight_layout()
Grafik: pohon — kedalaman vs bentuk batas (2D)
Random Forest — bahasa awam
Random Forest seperti rapat komite dengan banyak anggota, masing-masing hanya melihat sebagian data dan sebagian pertanyaan (subsample baris + subset fitur acak), lalu masing-masing membuat pohon keputusan kecil. Saat ada kasus baru, setiap pohon memberi suara; suara terbanyak menang.
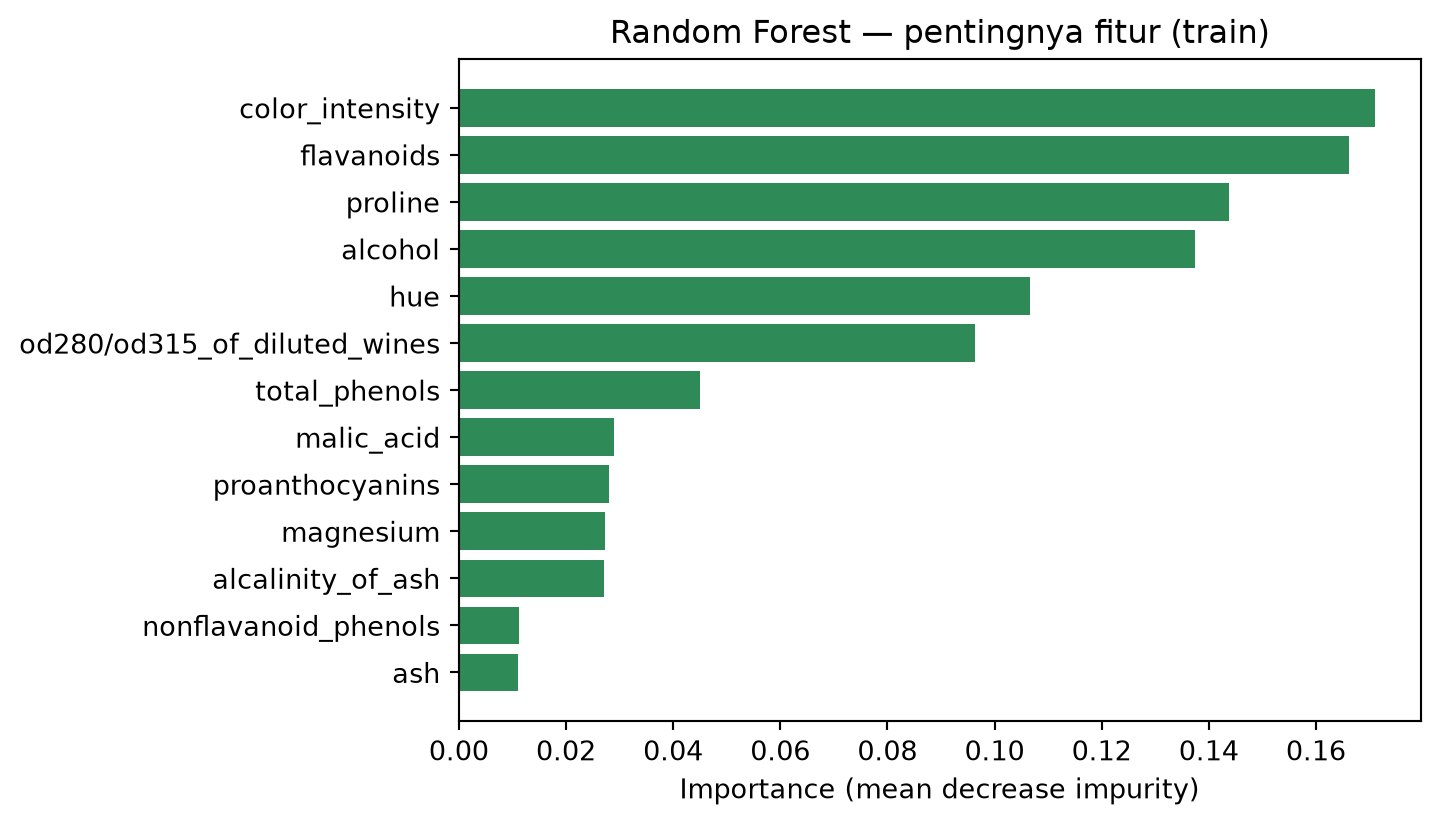
Dengan banyak “pendapat” yang sedikit berbeda, kesalahan satu pohon yang terlalu menyesuaikan noise akan tertimbun oleh pohon lain — jadi sering lebih stabil dan akurat daripada satu pohon raksasa. Harganya: sulit menjelaskan ke pemangku kepentingan satu alur if–else tunggal; kita lebih sering memakai pentingnya fitur atau alat interpretasi lain.
Random Forest
Ide: latih banyak pohon pada bootstrap sample baris latih; pada setiap split, pertimbangkan subset acak fitur (random subspace).
Prediksi: suara mayoritas (klasifikasi) atau rata-rata (regresi) antar pohon.
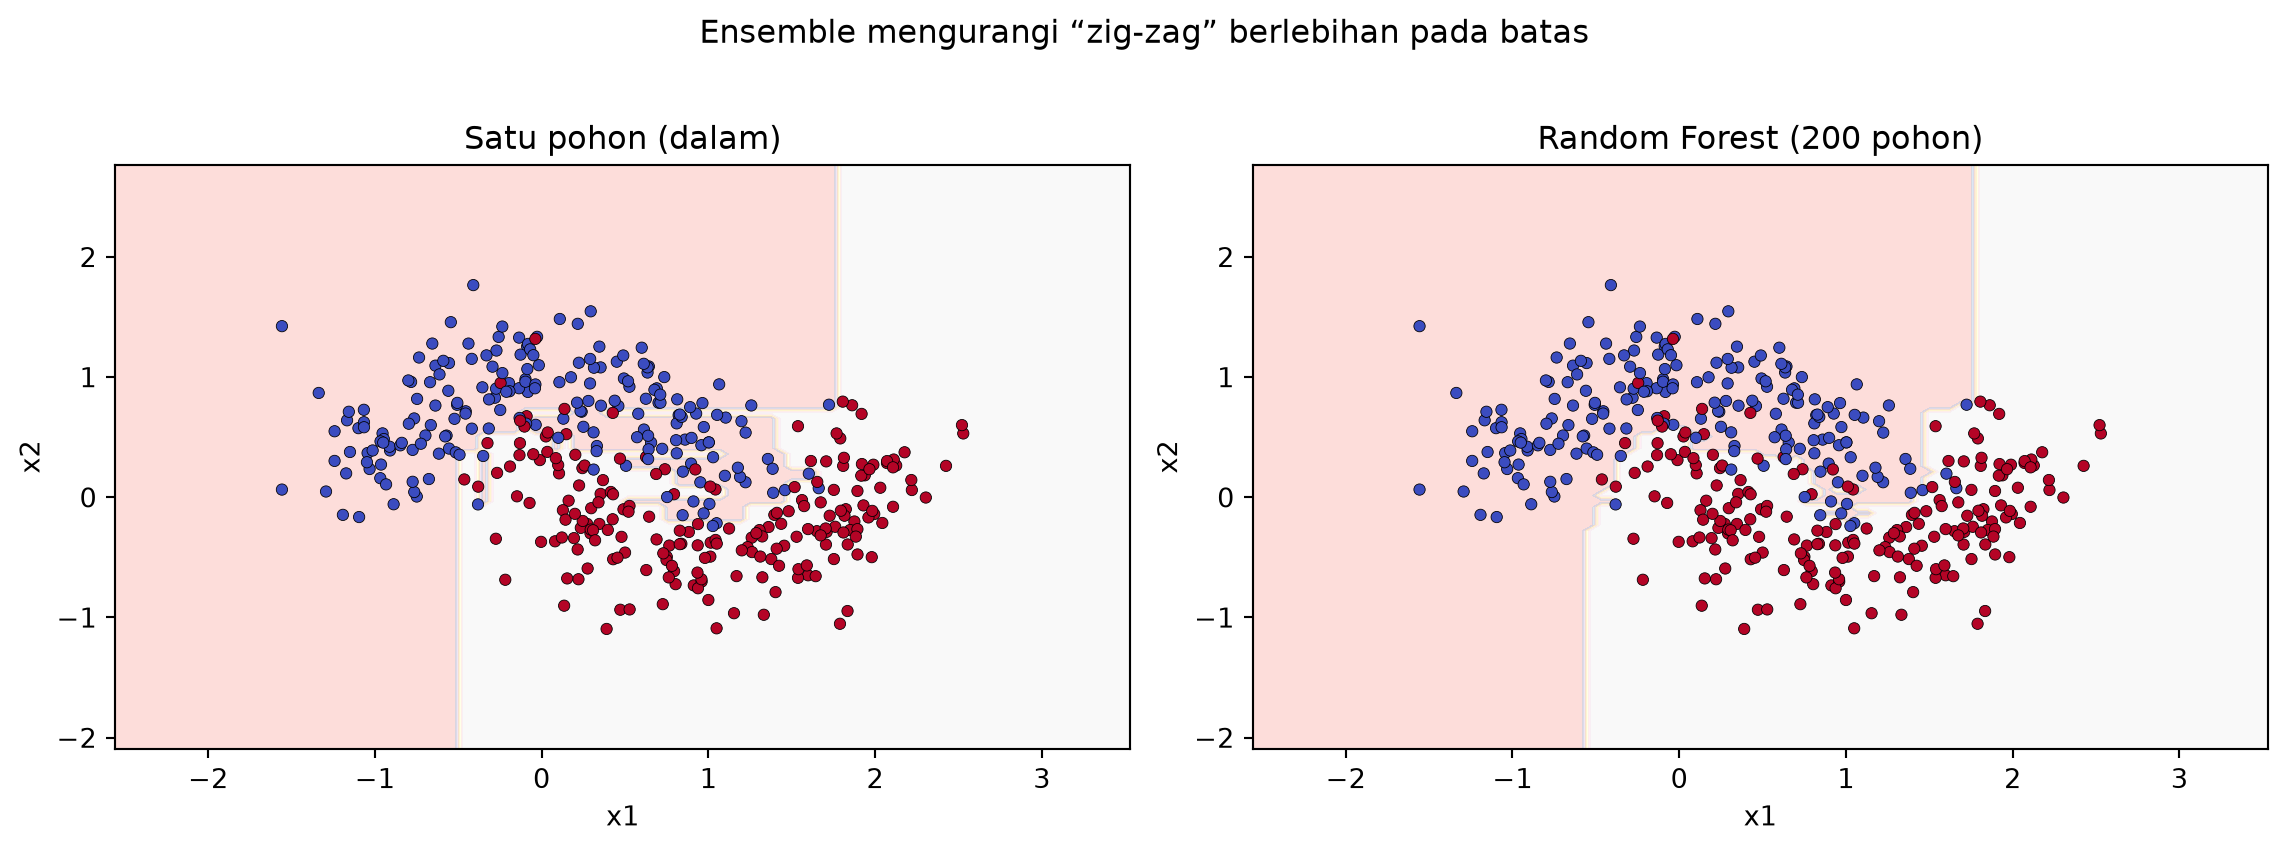
Manfaat: mengurangi varians dibanding satu pohon dalam; sering akurat tanpa banyak tuning.
Trade-off: kurang transparan daripada satu pohon (interpretasi via importance fitur, SHAP di kuliah lanjutan).
Grafik: satu pohon vs Random Forest (batas keputusan)
Satu pohon bisa tidak stabil pada batas; hutan meratakan variasi lewat suara banyak pohon — batas cenderung lebih mulus pada contoh ini.
import matplotlib.pyplot as plt
from sklearn.datasets import make_moons
from sklearn.ensemble import RandomForestClassifier
from sklearn.inspection import DecisionBoundaryDisplay
from sklearn.tree import DecisionTreeClassifier

Xm, ym = make_moons(n_samples=400, noise=0.28, random_state=3)
fig, axes = plt.subplots(1, 2, figsize=(12, 4.3))
dt = DecisionTreeClassifier(max_depth=12, min_samples_leaf=1, random_state=0)
dt.fit(Xm, ym)
DecisionBoundaryDisplay.from_estimator(
    dt, Xm, response_method="predict", ax=axes[0], alpha=0.45, cmap="Pastel1"
)
axes[0].scatter(Xm[:, 0], Xm[:, 1], c=ym, cmap="coolwarm", edgecolors="k", s=18, linewidths=0.3)
axes[0].set_title("Satu pohon (dalam)")
axes[0].set_xlabel("x1")
axes[0].set_ylabel("x2")

rf = RandomForestClassifier(
    n_estimators=200, max_depth=12, min_samples_leaf=2, random_state=0
)
rf.fit(Xm, ym)
DecisionBoundaryDisplay.from_estimator(
    rf, Xm, response_method="predict", ax=axes[1], alpha=0.45, cmap="Pastel1"
)
axes[1].scatter(Xm[:, 0], Xm[:, 1], c=ym, cmap="coolwarm", edgecolors="k", s=18, linewidths=0.3)
axes[1].set_title("Random Forest (200 pohon)")
axes[1].set_xlabel("x1")
axes[1].set_ylabel("x2")
plt.suptitle("Ensemble mengurangi “zig-zag” berlebihan pada batas", y=1.02)
plt.tight_layout()
Grafik: satu pohon vs Random Forest (batas keputusan)
Pentingnya fitur (Random Forest)
import matplotlib.pyplot as plt
import numpy as np
from sklearn.datasets import load_wine
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import train_test_split

X, y = load_wine(return_X_y=True)
names = load_wine().feature_names
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.25, stratify=y, random_state=42
)
rf = RandomForestClassifier(
    n_estimators=300, max_depth=None, min_samples_leaf=2, random_state=42
)
rf.fit(X_train, y_train)
imp = rf.feature_importances_
order = np.argsort(imp)
fig, ax = plt.subplots(figsize=(7.5, 4.4))
ax.barh(np.array(names)[order], imp[order], color="seagreen")
ax.set_xlabel("Importance (mean decrease impurity)")
ax.set_title("Random Forest — pentingnya fitur (train)")
plt.tight_layout()
Pentingnya fitur (Random Forest)
SVM — bahasa awam
SVM (versi intuitif) mencari garis atau permukaan pemisah antara dua kelompok titik yang sejauh mungkin dari titik latih terdekat di kedua sisi — seperti memasang pembatas jalan di tengah yang memberi ruang aman (margin) supaya sedikit gangguan pada posisi titik tidak langsung mengubah sisi klasifikasi. Titik-titik yang “menempel” di pembatas inilah yang disebut support vectors.
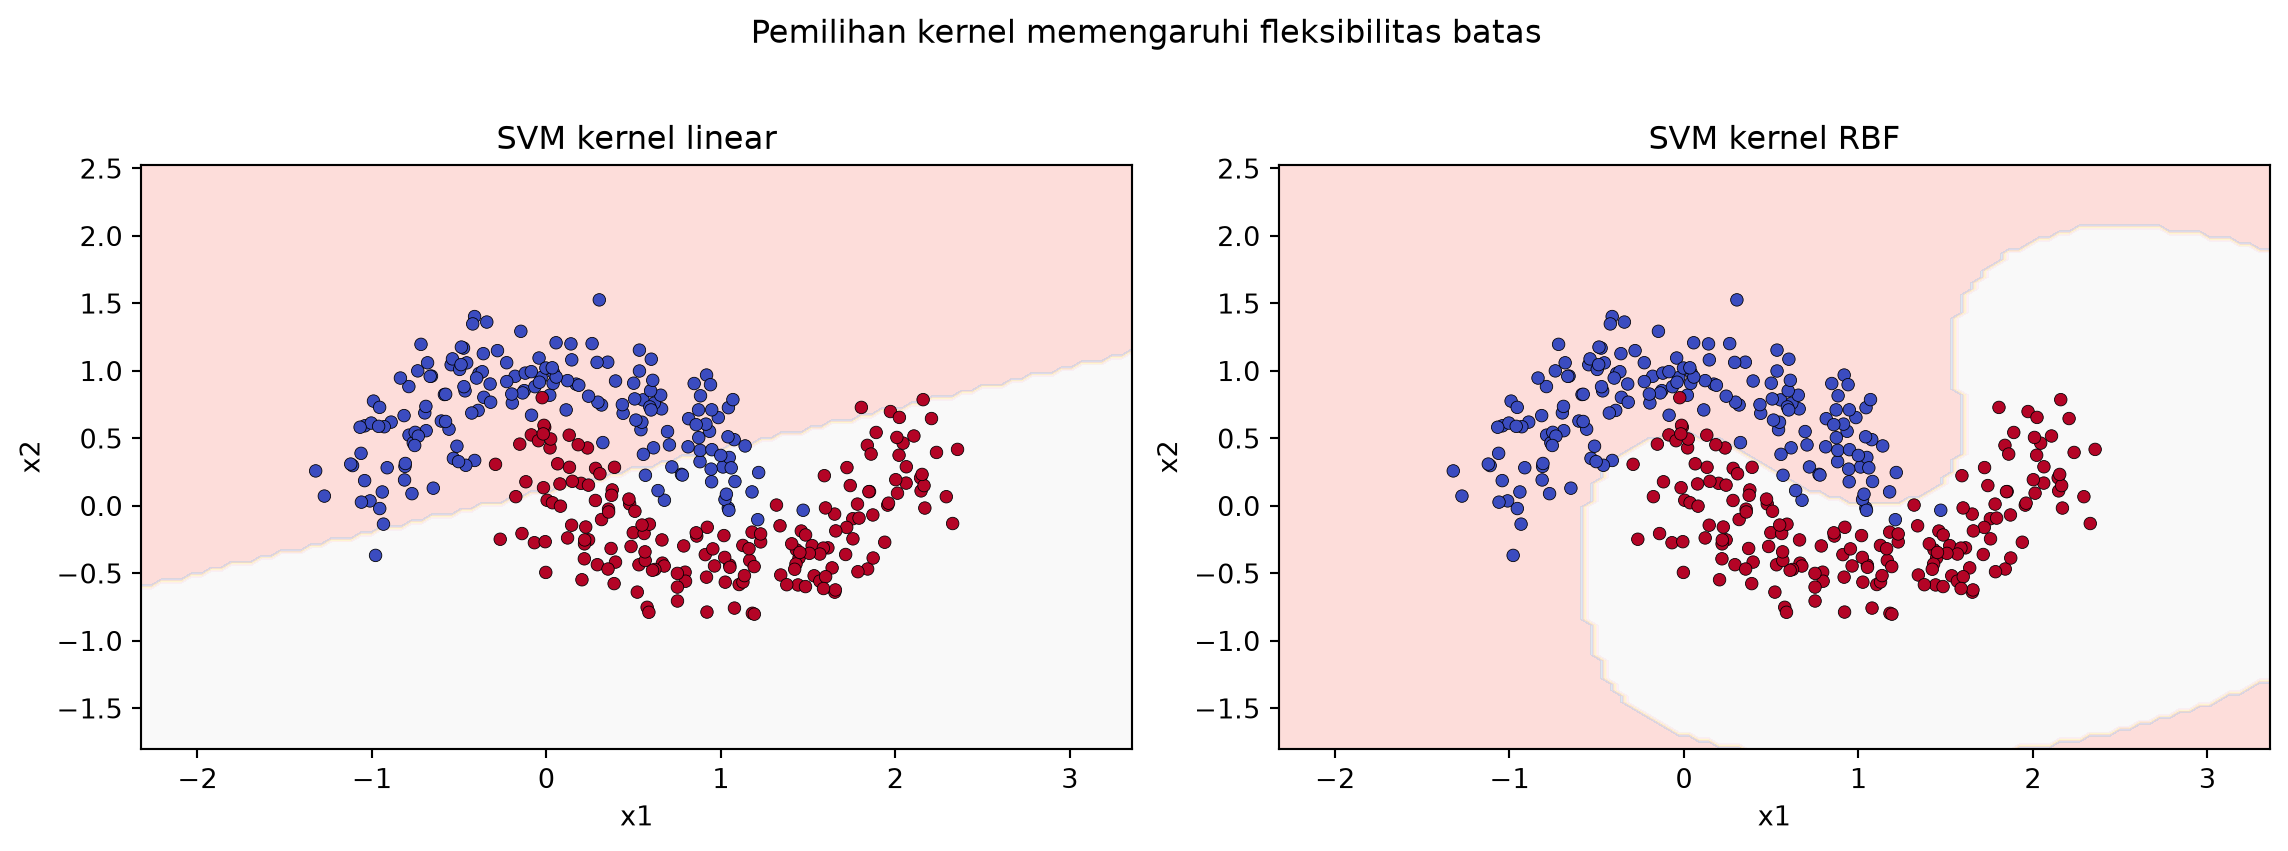
Kalau dua kelompok tidak bisa dipisah garis lurus, kita bisa memakai kernel (mis. RBF): bayangan intuitifnya, data dianggap diletakkan di ruang lebih tinggi sehingga kelompok yang tumpang tindih bisa terpisah permukaan yang lebih fleksibel — mirip menggulung kertas 2D sehingga titik yang tadinya campur jadi terpisah di 3D.
Grafik: SVM linear vs kernel RBF (data tidak linear)
Kernel linear mencoba garis lurus; RBF memungkinkan batas melengkung mengelilingi kelompok — cocok untuk pola bulan sabit.
import matplotlib.pyplot as plt
from sklearn.datasets import make_moons
from sklearn.inspection import DecisionBoundaryDisplay
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.svm import SVC

Xm, ym = make_moons(n_samples=350, noise=0.2, random_state=4)
fig, axes = plt.subplots(1, 2, figsize=(12, 4.3))

lin = Pipeline(
    [
        ("sc", StandardScaler()),
        ("svc", SVC(kernel="linear", C=1.0)),
    ]
)
lin.fit(Xm, ym)
DecisionBoundaryDisplay.from_estimator(
    lin, Xm, response_method="predict", ax=axes[0], alpha=0.45, cmap="Pastel1"
)
axes[0].scatter(Xm[:, 0], Xm[:, 1], c=ym, cmap="coolwarm", edgecolors="k", s=22, linewidths=0.3)
axes[0].set_title("SVM kernel linear")
axes[0].set_xlabel("x1")
axes[0].set_ylabel("x2")

rbf = Pipeline(
    [
        ("sc", StandardScaler()),
        ("svc", SVC(kernel="rbf", C=1.0, gamma="scale")),
    ]
)
rbf.fit(Xm, ym)
DecisionBoundaryDisplay.from_estimator(
    rbf, Xm, response_method="predict", ax=axes[1], alpha=0.45, cmap="Pastel1"
)
axes[1].scatter(Xm[:, 0], Xm[:, 1], c=ym, cmap="coolwarm", edgecolors="k", s=22, linewidths=0.3)
axes[1].set_title("SVM kernel RBF")
axes[1].set_xlabel("x1")
axes[1].set_ylabel("x2")
plt.suptitle("Pemilihan kernel memengaruhi fleksibilitas batas", y=1.02)
plt.tight_layout()
Grafik: SVM linear vs kernel RBF (data tidak linear)
Support Vector Machine (SVM) — ide geometris
Untuk data terpisah linear (dua kelas), SVM mencari hyperplane \(\{x : w^\top x + b = 0\}\) yang:
- memisahkan kelas (sisi berlawanan untuk titik positif/negatif), dan
- memaksimalkan margin — jarak terpendek dari hyperplane ke titik latih terdekat.
Margin geometris sebanding dengan \(1/\|w\|\); memaksimalkan margin setara (dengan normalisasi tertentu) dengan meminimumkan \(\frac{1}{2}\|w\|^2\) di bawah kendala pemisahan — solusi bergantung hanya pada subset titik di batas → support vectors.
Soft margin & peran hiperparameter \(C\)
Data nyata sering tidak sepenuhnya terpisah linear. Soft-margin SVM memperkenalkan variabel slack \(\xi_i \geq 0\) agar beberapa titik boleh melanggar margin kecil:
\[ \min_{w,b,\xi} \frac{1}{2}\|w\|^2 + C\sum_i \xi_i \quad \text{s.t. } y_i(w^\top x_i + b) \geq 1 - \xi_i,\; \xi_i \geq 0 \]
\(C\) besar: penalti kuat pada pelanggaran → margin sempit, model mengikuti data latih lebih ketat (risiko overfit relatif naik).
\(C\) kecil: toleransi pelanggaran lebih besar → margin lebar, decision boundary lebih halus / lebih “regularized”.
Dualitas & kernel trick (mengapa SVM “nonlinear”)
Formulasi dual menyatakan solusi \(w\) sebagai kombinasi linear titik latih \(w = \sum_i \alpha_i y_i x_i\) dengan \(\alpha_i \geq 0\) (hanya titik dengan \(\alpha_i>0\) yang menjadi support vectors).
Prediksi memakai bentuk yang hanya membutuhkan inner product \(x_i^\top x_j\) — mengganti inner product dengan fungsi kernel positif-definit \(K(x_i,x_j)\) setara dengan bekerja di ruang fitur berdimensi tinggi tanpa menghitung pemetaan eksplisit \(\phi(x)\).
Kernel linear \(K(x,x') = x^\top x'\) memulihkan pemisah hyperplane asli; kernel polinomial dan RBF memperkaya bentuk batas keputusan.
Kernel RBF (Gaussian):
\[ K(x, x') = \exp\bigl(-\gamma \|x-x'\|^2\bigr) \]
\(\gamma\) besar: kernel “tajam” — setiap titik punya pengaruh lokal kuat (batas keputusan berlekuk); \(\gamma\) kecil: pengaruh lebih global / halus.
Di sklearn, gamma='scale' memakai \(1/(p \cdot \text{Var}(X))\) sebagai default heuristik.
SVM multi-kelas & praktik sklearn
Multi-kelas: SVC memakai strategi one-vs-one (setiap pasang kelas satu SVM); untuk banyak kelas jumlah sub-masalah \(O(C^2)\) — masih efisien untuk \(C\) kecil–sedang.
LinearSVC (bukan SVC(kernel='linear')) memakai optimisasi berbeda dan sering lebih cepat pada data besar berdimensi tinggi (mis. teks TF–IDF).
Skala fitur: SVM membandingkan kontribusi fitur lewat produk dalam / jarak — standarisasi (StandardScaler dalam Pipeline) hampir selalu wajib agar \(C\) dan \(\gamma\) bermakna.
Naive Bayes — bahasa awam
Naive Bayes seperti dokter yang mendengar beberapa gejala lalu bertanya dalam hati: “dari pengalaman statistik, masing-masing gejala ini seberapa sering muncul pada penyakit A vs B?” lalu menggabungkan jawaban dengan asumsi sederhana: gejala-gejala itu hampir tidak saling memengaruhi setelah penyakit diketahui (asumsi naif).
Di dunia nyata gejala sering saling berkaitan, tetapi trik ini membuat perhitungan sangat cepat dan sering cukup akurat (terutama teks spam/ham dengan representasi kata). Cocok sebagai baseline sebelum model yang lebih berat.
Naive Bayes (Gaussian)
Asumsi “naif”: antar fitur kondisional independen diberi kelas — jarang benar secara ketat, tetapi model sering cepat dan cukup kuat sebagai baseline.
GaussianNB: memodelkan setiap fitur per kelas dengan Gaussian univariat — cocok untuk fitur kontinu mendekati normal per kelas.
Kelebihan: latih sangat cepat; sedikit hiperparameter.
Kelemahan: asumsi independensi bisa melemahkan jika fitur sangat berkorelasi.
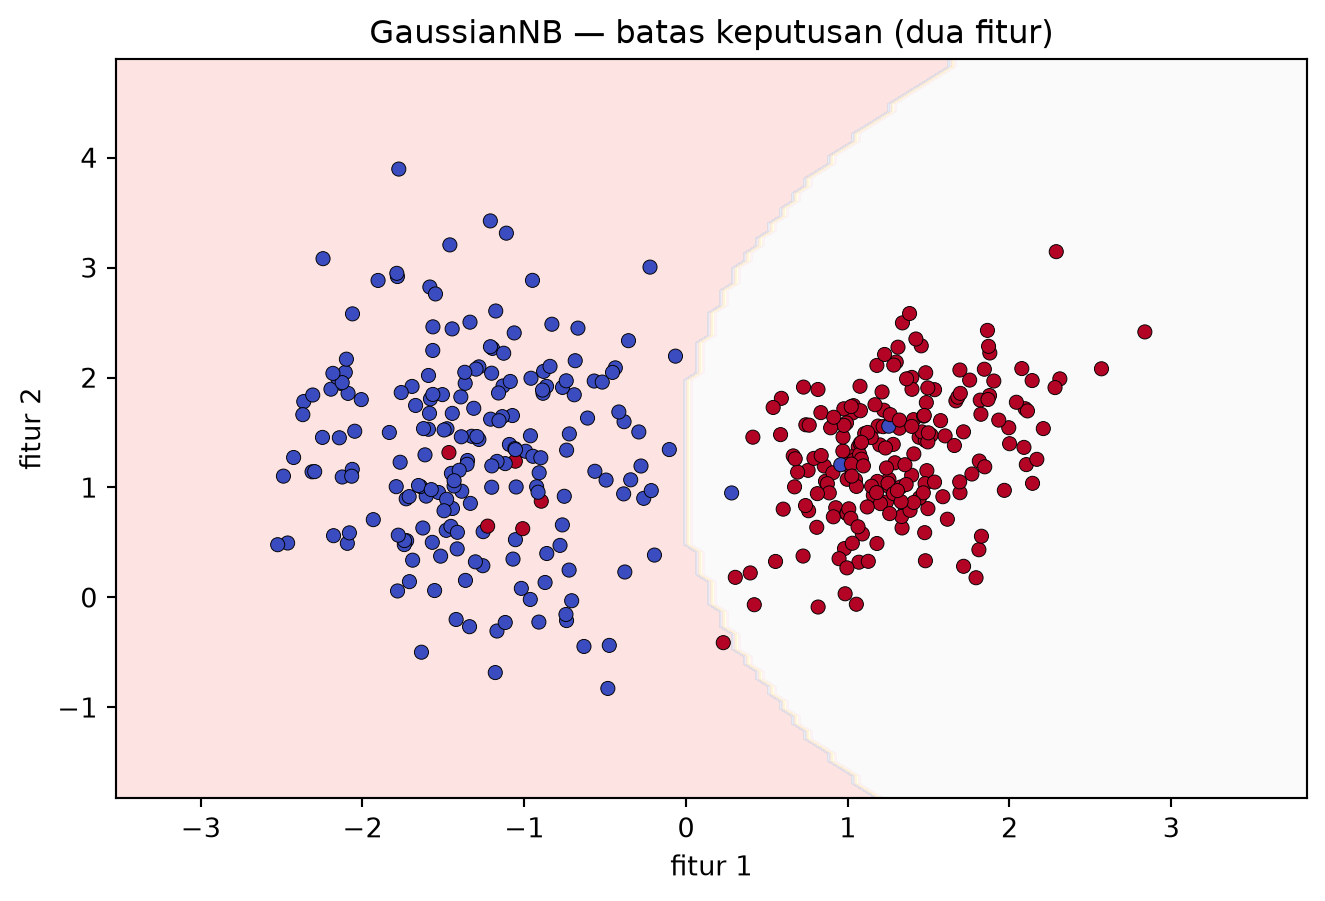
Grafik: Gaussian Naive Bayes — batas keputusan 2D
Model memisahkan ruang dengan permukaan yang mengasumsikan setiap fitur berkontribusi lewat kurva normal per kelas; visual membantu melihat kapan batas hampir linear vs lengkung.
import matplotlib.pyplot as plt
from sklearn.datasets import make_classification
from sklearn.inspection import DecisionBoundaryDisplay
from sklearn.naive_bayes import GaussianNB

Xc, yc = make_classification(
    n_samples=400,
    n_features=2,
    n_redundant=0,
    n_informative=2,
    n_clusters_per_class=1,
    flip_y=0.06,
    class_sep=1.3,
    random_state=11,
)
gnb = GaussianNB()
gnb.fit(Xc, yc)
fig, ax = plt.subplots(figsize=(7, 4.8))
DecisionBoundaryDisplay.from_estimator(
    gnb, Xc, response_method="predict", ax=ax, alpha=0.35, cmap="Pastel1"
)
ax.scatter(Xc[:, 0], Xc[:, 1], c=yc, cmap="coolwarm", edgecolors="k", s=28, linewidths=0.35)
ax.set_title("GaussianNB — batas keputusan (dua fitur)")
ax.set_xlabel("fitur 1")
ax.set_ylabel("fitur 2")
plt.tight_layout()
Grafik: Gaussian Naive Bayes — batas keputusan 2D
Membandingkan algoritme — bahasa awam
Saat membandingkan k-NN, pohon, hutan, SVM, dan Naive Bayes, bayangkan satu ujian dengan soal yang sama (data uji identik) dan aturan main yang sama (cara hitung skor akurasi/F1). Yang berbeda hanya “strategi belajar” tiap algoritme: ada yang mengandalkan tetangga terdekat, ada yang membuat aturan cabang, ada yang mencari pembatas lebar, ada yang menghitung peluang gejala.
Tanpa aturan adil ini, mudah menyalahkan algoritme padahal yang bermasalah adalah skala fitur, outlier, atau kebocoran dari set uji ke proses latih.
Komparasi cepat: beberapa algoritme pada split yang sama
import matplotlib.pyplot as plt
import numpy as np
import pandas as pd
from sklearn.datasets import load_wine
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import accuracy_score, f1_score
from sklearn.model_selection import train_test_split
from sklearn.naive_bayes import GaussianNB
from sklearn.neighbors import KNeighborsClassifier
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.svm import SVC
from sklearn.tree import DecisionTreeClassifier

X, y = load_wine(return_X_y=True)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.25, stratify=y, random_state=42
)

models = {
    "kNN (k=7)": Pipeline(
        [
            ("sc", StandardScaler()),
            ("m", KNeighborsClassifier(n_neighbors=7)),
        ]
    ),
    "DecisionTree (d=5)": DecisionTreeClassifier(max_depth=5, random_state=42),
    "RandomForest": RandomForestClassifier(
        n_estimators=300, min_samples_leaf=2, random_state=42
    ),
    "SVM RBF": Pipeline(
        [
            ("sc", StandardScaler()),
            ("m", SVC(kernel="rbf", C=2.0, gamma="scale")),
        ]
    ),
    "GaussianNB": Pipeline(
        [("sc", StandardScaler()), ("m", GaussianNB())]
    ),
}

rows = []
for name, clf in models.items():
    clf.fit(X_train, y_train)
    pred = clf.predict(X_test)
    rows.append(
        {
            "model": name,
            "accuracy": accuracy_score(y_test, pred),
            "f1_macro": f1_score(y_test, pred, average="macro"),
        }
    )
df = pd.DataFrame(rows).set_index("model")
print(df.round(3))

xpos = np.arange(len(df))
w = 0.35
fig, ax = plt.subplots(figsize=(10, 4.5))
ax.bar(xpos - w / 2, df["accuracy"], width=w, label="Akurasi (test)", color="steelblue")
ax.bar(xpos + w / 2, df["f1_macro"], width=w, label="F1-macro (test)", color="coral")
ax.set_xticks(xpos)
ax.set_xticklabels(df.index, rotation=20, ha="right")
ax.set_ylim(0, 1.05)
ax.set_ylabel("Skor")
ax.legend()
ax.set_title("Komparasi pada Wine (split tetap; hiperparameter disetel manual)")
plt.tight_layout()
F1-macro = rata-rata F1 per kelas — lebih adil jika kelas seimbang; untuk tidak seimbang pertimbangkan F1-weighted atau balanced accuracy.
Komparasi cepat: beberapa algoritme pada split yang sama
                    accuracy  f1_macro
model
kNN (k=7)              0.978     0.977
DecisionTree (d=5)     0.956     0.956
RandomForest           1.000     1.000
SVM RBF                0.978     0.976
GaussianNB             0.978     0.980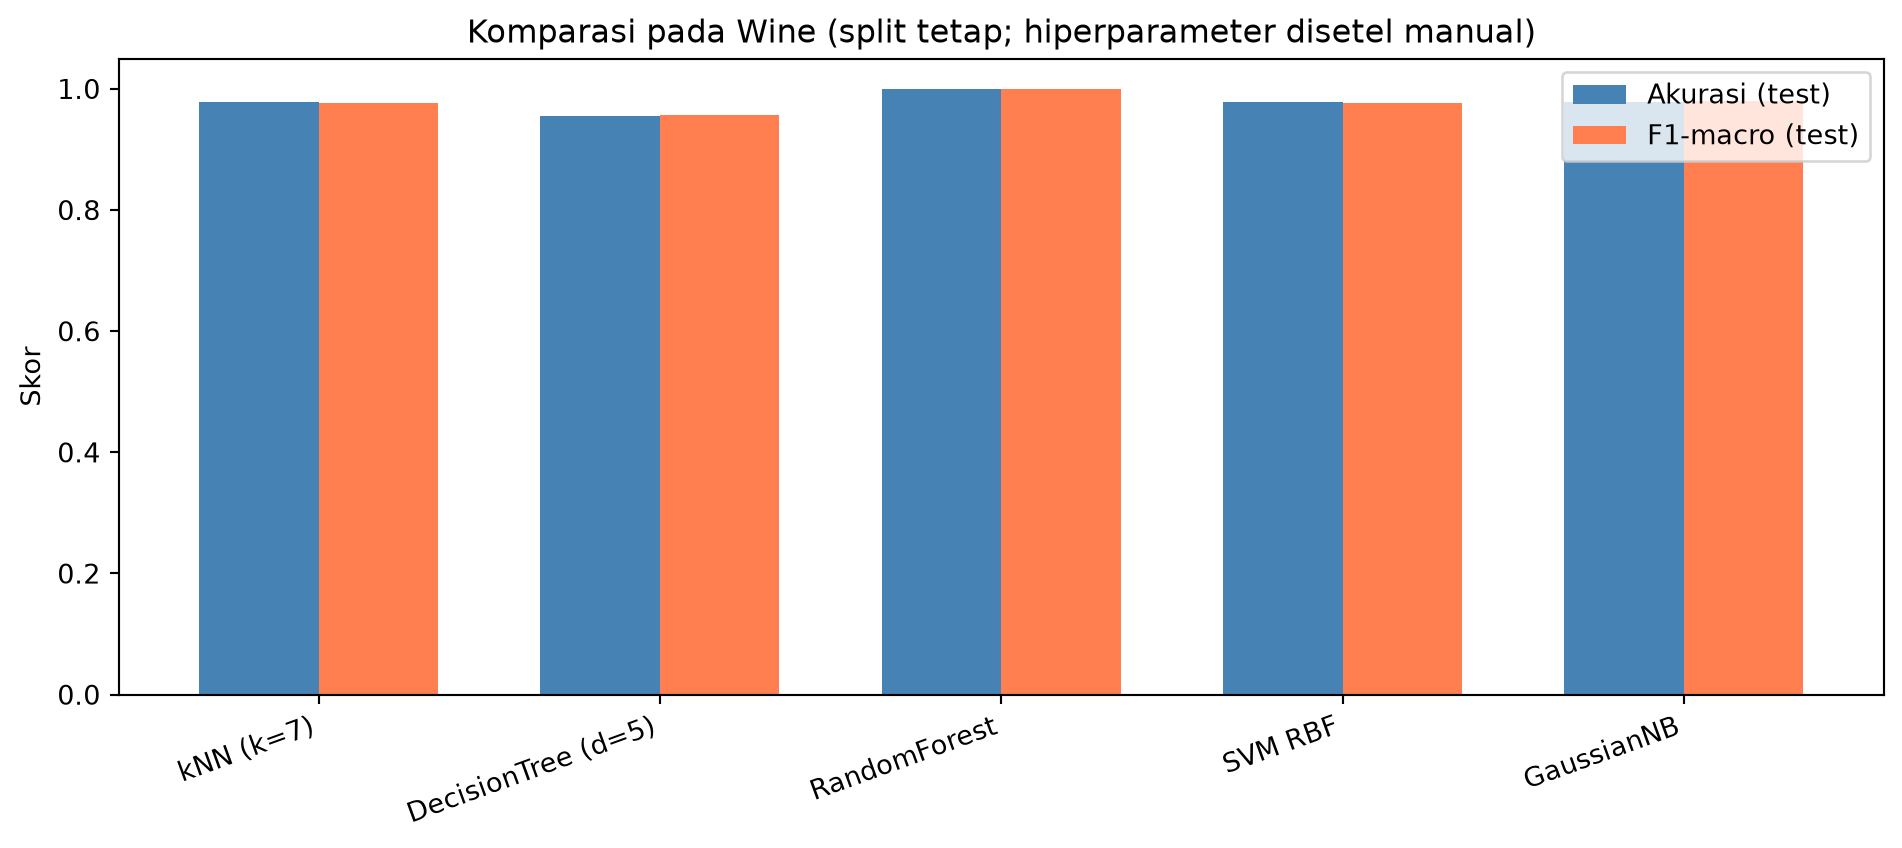
Matriks kebingungan — bahasa awam
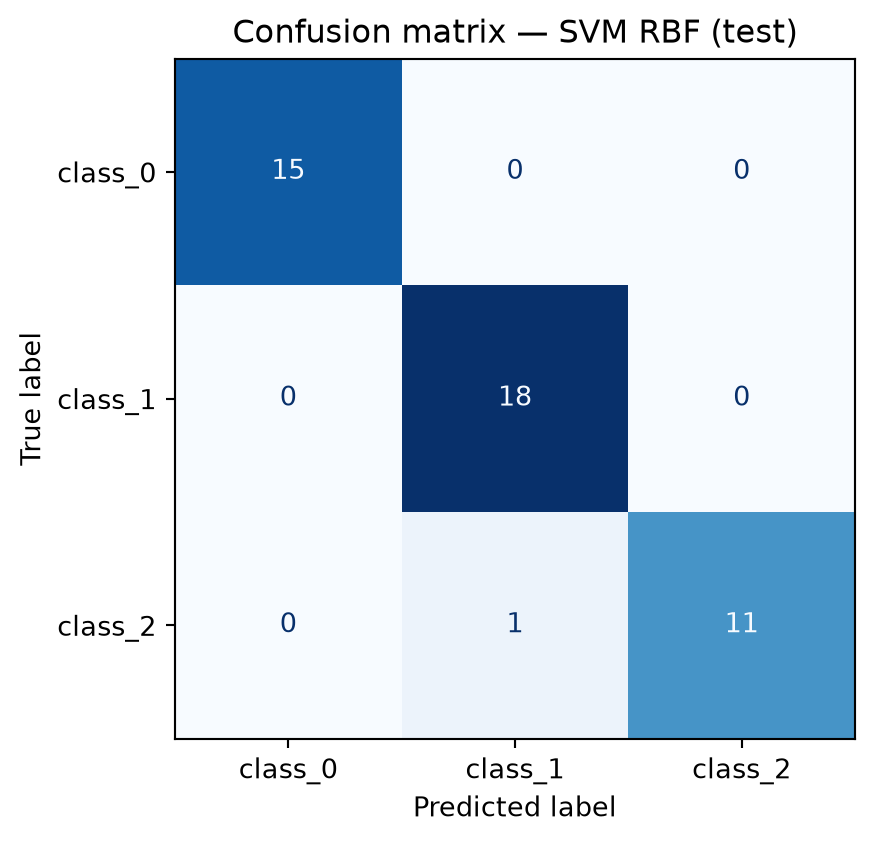
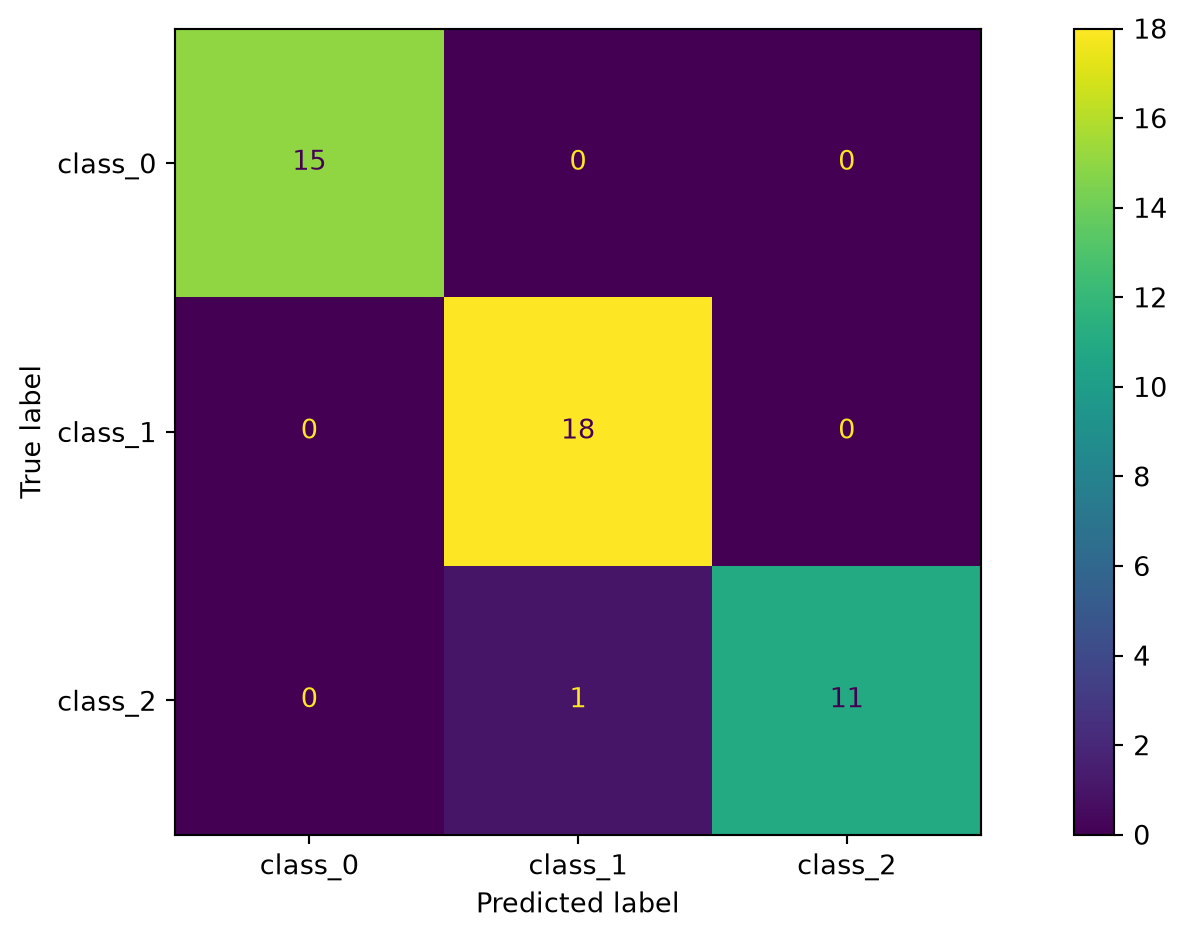
Confusion matrix seperti tabel absensi ujian: baris = jawaban sebenarnya, kolom = yang diprediksi model. Angka di diagonal utama = benar; di luar diagonal = jenis salah (misalnya sehat diprediksi sakit vs sebaliknya). Berguna ketika salah jenis A vs jenis B punya konsekuensi berbeda di dunia nyata (biaya, risiko).
Matriks kebingungan (confusion matrix) — contoh SVM
import matplotlib.pyplot as plt
import numpy as np
from sklearn.datasets import load_wine
from sklearn.metrics import ConfusionMatrixDisplay
from sklearn.model_selection import train_test_split
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.svm import SVC

X, y = load_wine(return_X_y=True)
wine = load_wine()
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.25, stratify=y, random_state=42
)
clf = Pipeline(
    [
        ("sc", StandardScaler()),
        ("m", SVC(kernel="rbf", C=2.0, gamma="scale")),
    ]
)
clf.fit(X_train, y_train)
pred = clf.predict(X_test)
fig, ax = plt.subplots(figsize=(5.8, 4.6))
ConfusionMatrixDisplay.from_predictions(
    y_test, pred, display_labels=wine.target_names
).plot(ax=ax, cmap="Blues", colorbar=False)
ax.set_title("Confusion matrix — SVM RBF (test)")
plt.tight_layout()
Matriks kebingungan (confusion matrix) — contoh SVM
Studi kasus ringkas (domain)
| Domain | Target | Algoritme yang sering dicoba | Catatan |
|---|---|---|---|
| Kredit / risiko | gagal bayar | LogReg, RF, XGBoost | metrik recall kelas risiko; fairness |
| Diagnosis bantu | penyakit vs sehat | SVM, NB (baseline), RF | validasi silang ketat; regulasi |
| Deteksi spam | spam / ham | NB (teks + Laplace), linear SVM | representasi teks (TF-IDF) |
| Prediksi churn | churn | RF, gradient boosting | kelas tidak seimbang → stratify + metrik F1 |
Ringkasan
- Skenario & metrik harus ditetapkan sebelum mengutak-atik model; train/test dengan
stratifyuntuk klasifikasi. - Bahasa awam: latih = latihan, uji = ujian suci; k-NN = voting tetangga; pohon = if–else; hutan = komite pohon; SVM = pembatas dengan “jalur aman”; Naive Bayes = menggabungkan peluang gejala dengan asumsi sederhana.
- k-NN: klasifikator berbasis contoh; suara mayoritas (atau bobot jarak) di antara \(k\) tetangga terdekat; kompleksitas prediksi tinggi; jarak & penskalaan fitur menentukan geometri ruang.
- Pohon & RF: pohon = partisi sumbu-sejajar + impurity (Gini/entropi) + split greedy; RF = ensemble pohon untuk turunkan varians.
- SVM: margin maksimum; soft margin + \(C\); solusi lewat dual + kernel (RBF + \(\gamma\)); multi-kelas OvO di
SVC. - GaussianNB: baseline cepat dengan asumsi independensi kondisional antar fitur.
- Komparasi adil memakai split identik dan protokol preprocessing yang konsisten (
Pipeline). - Grafik konsep: slide tambahan memakai
make_moons/make_classificationuntuk batas keputusan k-NN, pohon, RF, SVM, dan Naive Bayes.
Referensi
- James et al., ISL — klasifikasi, pohon, ensemble, SVM.
- Dokumentasi scikit-learn:
train_test_split,KNeighborsClassifier,DecisionTreeClassifier,RandomForestClassifier,SVC,GaussianNB,Pipeline,cross_val_score.
MK Data Science 10 - Anggit Wirasto