import matplotlib.pyplot as plt
import numpy as np
from sklearn.linear_model import LinearRegression

rng = np.random.default_rng(9)
n = 80
x = rng.uniform(2, 18, size=n)
y_true = 5.0 + 1.35 * x
y = y_true + rng.normal(0, 2.2, size=n)
X = x.reshape(-1, 1)
model = LinearRegression().fit(X, y)
xp = np.linspace(x.min(), x.max(), 200).reshape(-1, 1)
yp = model.predict(xp)
y_hat = model.predict(X)
res = y - y_hat

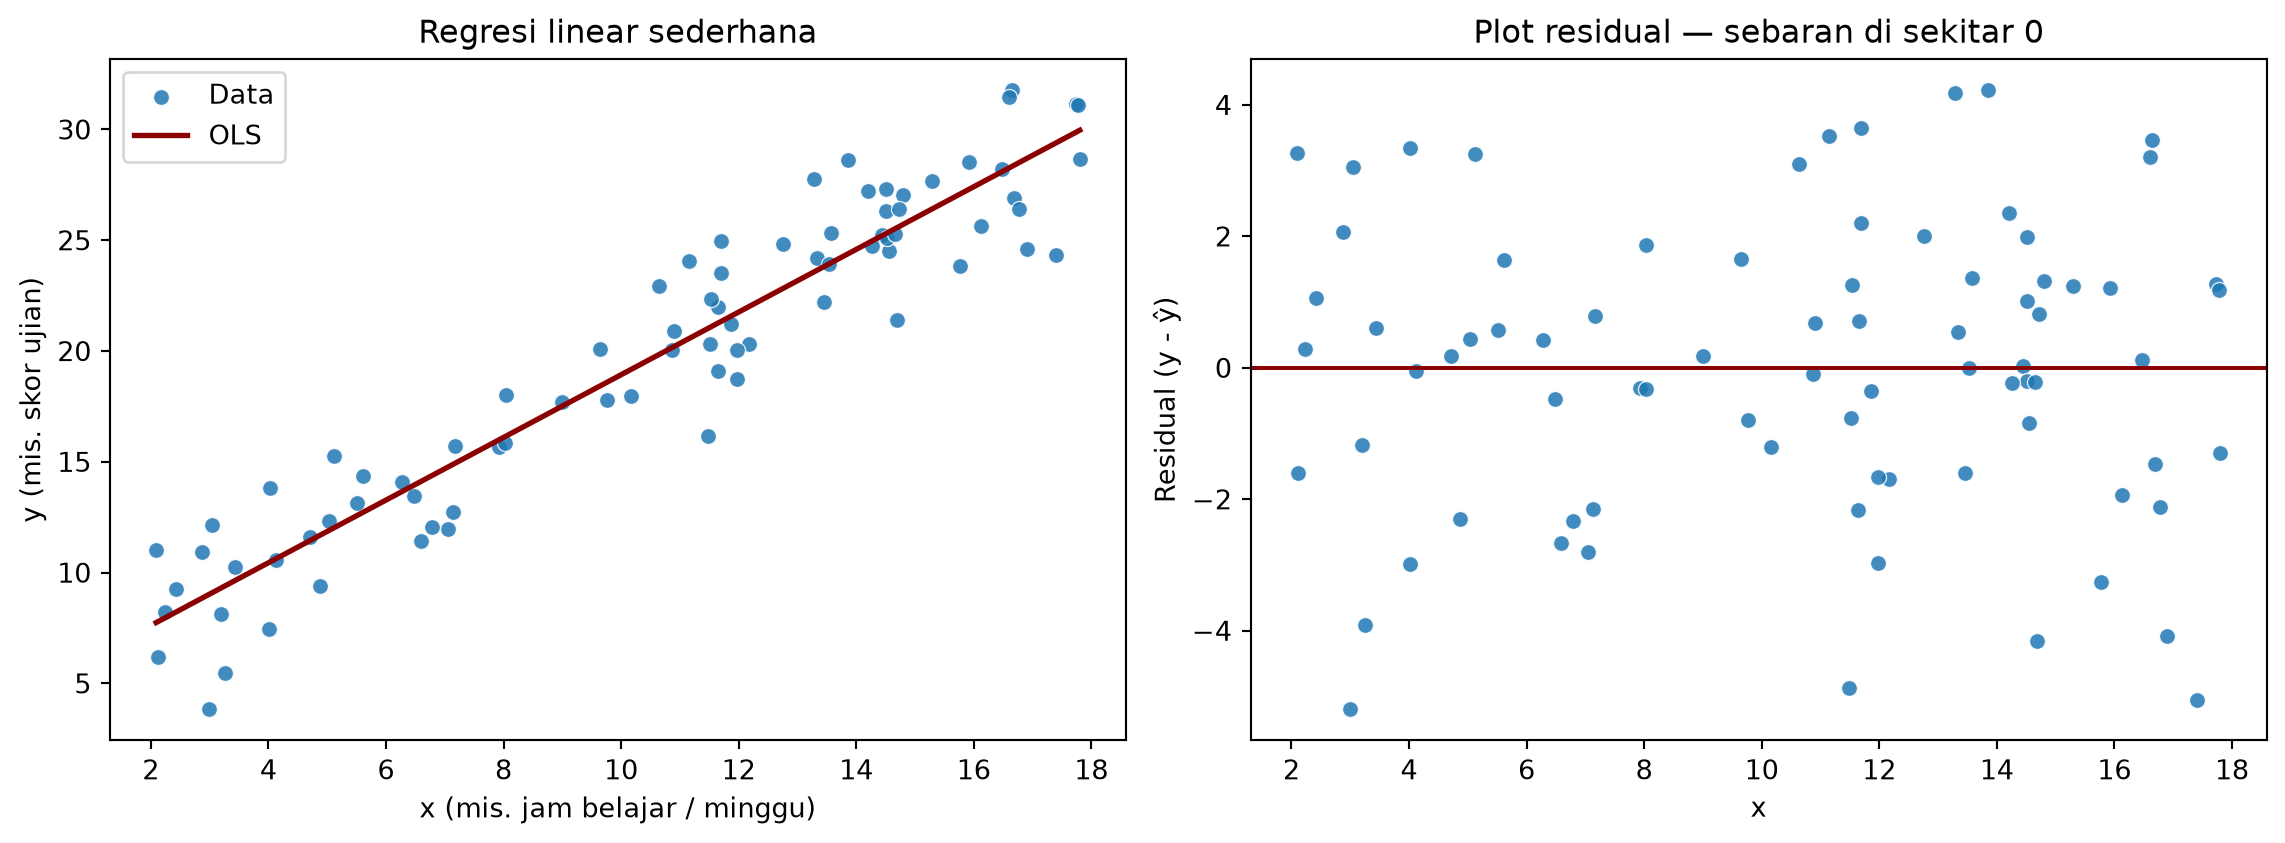
fig, axes = plt.subplots(1, 2, figsize=(12, 4.5))
axes[0].scatter(x, y, alpha=0.85, edgecolors="white", linewidths=0.5, label="Data")
axes[0].plot(xp.ravel(), yp, color="darkred", linewidth=2, label="OLS")
axes[0].set_xlabel("x (mis. jam belajar / minggu)")
axes[0].set_ylabel("y (mis. skor ujian)")
axes[0].legend()
axes[0].set_title("Regresi linear sederhana")
axes[1].scatter(x, res, alpha=0.85, edgecolors="white", linewidths=0.5)
axes[1].axhline(0, color="darkred", linewidth=1.5)
axes[1].set_xlabel("x")
axes[1].set_ylabel("Residual (y - ŷ)")
axes[1].set_title("Plot residual — sebaran di sekitar 0")
plt.tight_layout()Regresi — Linear, Polynomial, & Regularisasi
Data Science — pertemuan ke-9
Anggit Wirasto, S.Si., M.Eng.
Tujuan pembelajaran
Setelah materi ini, mahasiswa diharapkan mampu:
- Menjelaskan regresi sebagai cabang supervised learning dengan target numerik/kontinu.
- Memformulasikan regresi linear sederhana & berganda, memahami OLS, serta menginterpretasikan koefisien dalam konteks masalah.
- Menggunakan basis polinomial untuk menangkap hubungan nonlinear, sambil mengenali risiko overfitting.
- Membedakan Ridge (L2), Lasso (L1), dan Elastic Net, serta memilih hiperparameter penalti dengan validasi silang.
- Mengenali contoh kasus regresi di berbagai domain dan dampak outlier pada OLS, serta opsi mitigasi (metrik, transformasi, regresi robust).
Supervised learning: klasifikasi vs regresi
Supervised learning mempelajari pemetaan \(f: \mathcal{X} \to \mathcal{Y}\) dari pasangan latih \((x_i, y_i)\).
| Jenis target | Contoh \(y\) | Nama umum tugas |
|---|---|---|
| Kategorik / diskret | spam / non-spam, kelas digit | Klasifikasi |
| Numerik kontinu | harga, suhu, konsumsi kWh | Regresi |
Regresi mencari fungsi yang mendekati nilai riil (bisa bilangan bulat yang diperlakukan kontinu, mis. jumlah unit terjual), sering dengan mengoptimalkan error kuadrat atau variannya.
Konsep dasar regresi
Input (fitur): vektor \(x \in \mathbb{R}^p\) — bisa berisi suhu, luas bangunan, indikator kampanye, dll.
Output (target): skalar \(y \in \mathbb{R}\) yang ingin diprediksi.
Model: \(\hat{y} = f(x;\theta)\) dengan parameter \(\theta\) yang dipelajari dari data.
Pelatihan: pilih \(\theta\) yang meminimumkan fungsi kerugian pada data latih, misalnya mean squared error (MSE):
\[ \mathcal{L}(\theta) = \frac{1}{n}\sum_{i=1}^n \bigl(y_i - f(x_i;\theta)\bigr)^2 \]
Evaluasi: ukur generalisasi pada data validasi/test (bukan hanya MSE latih) — hindari optimisme karena overfitting.
Asumsi & interpretasi (praktis)
- Hubungan sinyal–noise: \(y = f^\star(x) + \varepsilon\); model memperkirakan \(f^\star\).
- Independensi observasi sering diasumsikan untuk inferensi statistik klasik; di ML modern, fokus sering ke prediksi + validasi empiris.
- Outlier memengaruhi kuadrat error — robust regression atau transformasi / penalti lain bisa relevan (kuliah lanjutan).
- Kausalitas: koefisien linear menjelaskan asosiasi pada data observasional; klaim sebab-akibat butuh desain eksperimen atau metode kausal.
Mengapa MSE? (hubungan dengan noise Gaussian)
Jika \(y_i = f(x_i;\theta) + \varepsilon_i\) dengan \(\varepsilon_i \sim \mathcal{N}(0,\sigma^2)\) i.i.d., maksimum log-likelihood terhadap \(\theta\) (dengan \(\sigma\) tetap) setara dengan meminimumkan \(\sum_i \bigl(y_i - f(x_i;\theta)\bigr)^2\) — inti least squares.
Implikasi: memilih MSE mengasumsikan error simetris di sekitar prediksi; residual besar dihukum sangat kuat (kuadrat). Untuk target dengan outlier berat, MAE (loss \(L_1\)) atau model robust sering lebih wajar.
Bias, varians, & error generalisasi
Untuk prediktor \(\hat{f}\) yang diestimasi dari sampel latih, risiko MSE di titik \(x\) dapat diurai secara kasar sebagai:
\[ \mathbb{E}\bigl[(Y - \hat{f}(x))^2\bigr] \approx \sigma^2 + \text{Bias}^2(\hat{f}(x)) + \mathbb{V}\text{ar}(\hat{f}(x)) \]
- Underfitting: model terlalu sederhana → bias besar, varians kecil.
- Overfitting: model terlalu fleksibel / terlalu banyak derajat kebebasan relatif terhadap \(n\) → bias kecil di latih tetapi varians besar → error test memburuk.
Regularisasi menambah bias terkontrol agar varians turun dan MSE test membaik.
Regresi linear sederhana (satu fitur)
Model:
\[ \hat{y} = \beta_0 + \beta_1 x \]
Ordinary Least Squares (OLS): pilih \(\beta_0,\beta_1\) yang meminimumkan \(\sum_i (y_i - \beta_0 - \beta_1 x_i)^2\).
Solusi tertutup (dengan notasi rata-rata \(\bar{x},\bar{y}\)):
\[ \beta_1 = \frac{\sum_i (x_i-\bar{x})(y_i-\bar{y})}{\sum_i (x_i-\bar{x})^2}, \qquad \beta_0 = \bar{y} - \beta_1 \bar{x} \]
Interpretasi: \(\beta_1\) adalah perubahan prediksi \(y\) per satuan peningkatan \(x\) (linear, marginal).
Visual: data, garis OLS, & residual
Residual ideal (secara kasar): tidak ber pola; mean \(\approx 0\); varian homogen. Pola melengkung → pertimbangkan nonlinearitas atau transformasi.
Visual: data, garis OLS, & residual
Metrik evaluasi regresi (ringkas)
- MSE / RMSE: sensitif outlier; RMSE dalam satuan \(y\).
- MAE: rata-rata \(|y-\hat{y}|\) — lebih robust terhadap ekstrem.
- \(R^2\): proporsi varians \(y\) yang “dijelaskan” model (bisa negatif pada test jika model buruk).
Praktik: laporkan RMSE/MAE pada test + interval prediksi jika bisnis membutuhkan rentang ketidakpastian.
Contoh kasus regresi — dari pertanyaan ke target \(y\)
| Konteks | Target \(y\) (kontinu) | Fitur tipikal | Catatan metrik / validasi |
|---|---|---|---|
| Properti | Harga transaksi / sewa bulanan | luas, kamar, jarak ke CBD | RMSE dalam mata uang; waspada outlier transaksi mencurigakan |
| Ritel / SCM | Permintaan harian / mingguan | harga, promosi, musim, stok | split waktu (bukan acak) jika deret waktu |
| SDM / kompensasi | Gaji awal (log sering dipakai) | pengalaman, pendidikan, kota | bias & fairness; transformasi log(y) |
| Operasional IT | Waktu penyelesaian tiket (jam) | prioritas, kompleksitas, tim | distribusi menceng → median / MAE atau log |
| Energi / bangunan | kWh, beban puncak | luas, penghuni, HVAC | multikolinearitas sensor → Ridge |
| Pertanian presisi | Hasil ton/ha | NDVI, curah hujan, pupuk | geospasial: blok random vs titik |
| Bio-statistik | Respons dosis (tekanan darah Δ) | dosis obat, covariat | desain eksperimen; nonlinear → polynomial parsial |
Inti: definisikan satuan \(y\) dan jangkauan inferensi (individu vs agregat) sebelum memilih model.
Contoh mini: harga sewa vs luas (sintetis, 1 fitur)
Skenario: memprediksi sewa bulanan (juta Rp) dari luas bersih (m²) pada pasar sewa tertentu. Hubungan mendekati linear dengan noise; di dunia nyata tambahkan lokasi, lantai, furnished.
import matplotlib.pyplot as plt
import numpy as np
from sklearn.linear_model import LinearRegression
from sklearn.metrics import mean_absolute_error, r2_score

rng = np.random.default_rng(202)
n = 120
luas = rng.uniform(22, 95, size=n)
sewa_juta = 0.85 + 0.11 * luas + rng.normal(0, 0.45, size=n)
X = luas.reshape(-1, 1)
reg = LinearRegression().fit(X, sewa_juta)
xp = np.linspace(luas.min(), luas.max(), 120).reshape(-1, 1)

fig, ax = plt.subplots(figsize=(6.8, 4.2))
ax.scatter(luas, sewa_juta, alpha=0.75, edgecolors="white", linewidths=0.4, label="Observasi")
ax.plot(xp.ravel(), reg.predict(xp), color="darkred", linewidth=2, label="OLS")
ax.set_xlabel("Luas (m²)")
ax.set_ylabel("Sewa (juta Rp / bulan)")
ax.set_title("Regresi sederhana — interpretasi β₁ ≈ kenaikan sewa per m²")
ax.legend()
plt.tight_layout()
print("β₁ (per m²):", round(reg.coef_[0], 4), "juta; intercept:", round(reg.intercept_, 3))
print("MAE (in-sample):", round(mean_absolute_error(sewa_juta, reg.predict(X)), 3), "juta")
print("R² (in-sample):", round(r2_score(sewa_juta, reg.predict(X)), 3))
Contoh mini: harga sewa vs luas (sintetis, 1 fitur)
β₁ (per m²): 0.11 juta; intercept: 0.875
MAE (in-sample): 0.367 juta
R² (in-sample): 0.96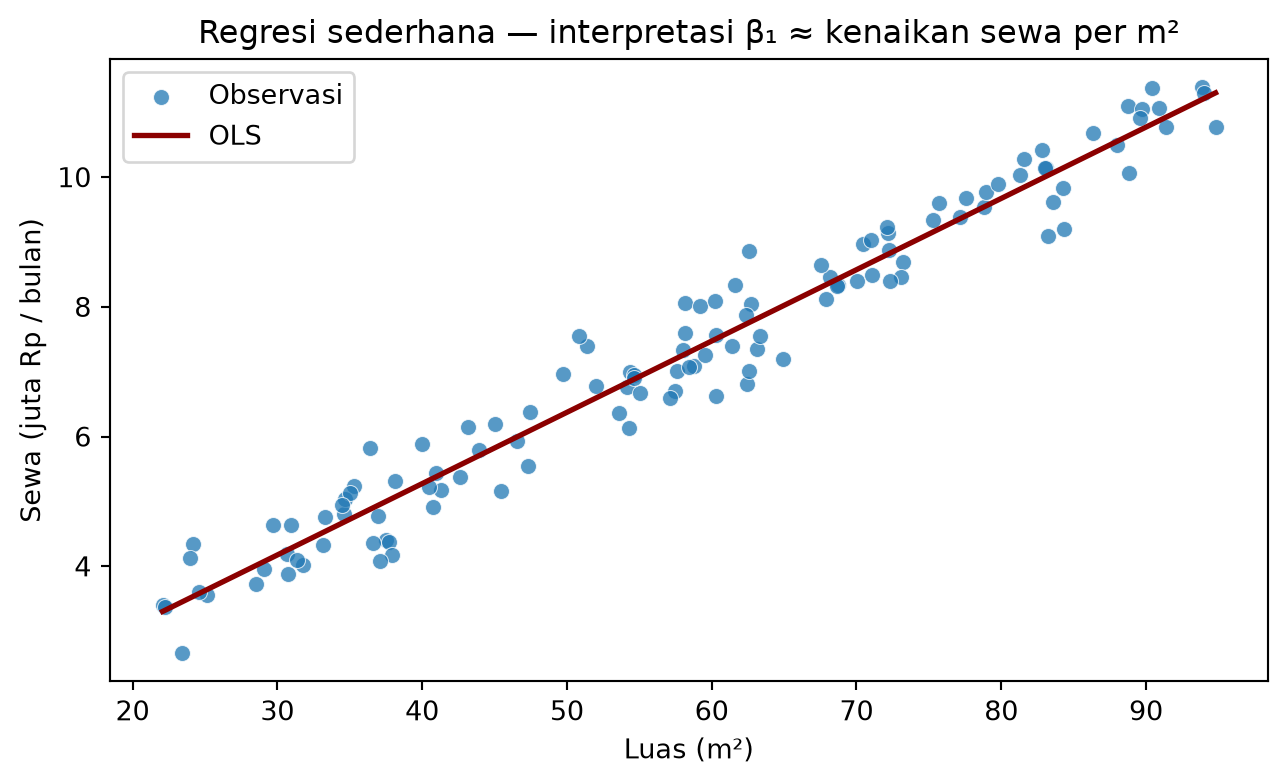
Regresi linear berganda (\(p\) fitur)
\[ \hat{y} = \beta_0 + \beta_1 x_1 + \cdots + \beta_p x_p = \beta_0 + x^\top \beta \]
Dalam bentuk matriks (dengan kolom satu untuk intercept):
\[ \hat{\mathbf{y}} = \mathbf{X}\boldsymbol{\beta}, \qquad \boldsymbol{\beta}^\star = \arg\min_{\boldsymbol{\beta}} \|\mathbf{y} - \mathbf{X}\boldsymbol{\beta}\|_2^2 \]
Jika \((\mathbf{X}^\top \mathbf{X})\) invertible: \(\boldsymbol{\beta}^\star = (\mathbf{X}^\top \mathbf{X})^{-1}\mathbf{X}^\top \mathbf{y}\).
Interpretasi parsial: \(\beta_j\) = efek marginal \(x_j\) jika fitur lain tetap (hati-hati jika multikolinearitas tinggi — koefisien tidak stabil).
Studi kasus (sintetis): prediksi konsumsi energi
Latar: prediksi kWh/hari dari luas bangunan (m²), jumlah penghuni, dan suhu rata-rata luar (°C). Data di bawah dibuat sintetis agar reproduksibel di kelas.
import matplotlib.pyplot as plt
import numpy as np
import pandas as pd
from sklearn.linear_model import LinearRegression
from sklearn.metrics import mean_absolute_error, r2_score
from sklearn.model_selection import train_test_split

rng = np.random.default_rng(42)
n = 400
luas_m2 = rng.uniform(35, 220, size=n)
penghuni = rng.integers(1, 7, size=n)
suhu_luar = rng.normal(28, 4, size=n)
# hubungannya linear + noise
kwh = (
    2.1 * luas_m2
    + 18.0 * penghuni
    - 1.05 * suhu_luar
    + rng.normal(0, 35, size=n)
    + 40.0
)
X = np.column_stack([luas_m2, penghuni, suhu_luar])
X_train, X_test, y_train, y_test = train_test_split(
    X, kwh, test_size=0.25, random_state=0
)
reg = LinearRegression().fit(X_train, y_train)
pred_test = reg.predict(X_test)
print("Koefisien (luas, penghuni, suhu):", reg.coef_)
print("Intercept:", round(reg.intercept_, 3))
print("MAE test:", round(mean_absolute_error(y_test, pred_test), 2), "kWh")
print("R2 test:", round(r2_score(y_test, pred_test), 3))

fig, ax = plt.subplots(figsize=(5.2, 4.2))
labels = ["Luas (m²)", "Penghuni", "Suhu luar (°C)"]
ax.bar(labels, reg.coef_, color=["steelblue", "seagreen", "coral"])
ax.axhline(0, color="black", linewidth=0.8)
ax.set_ylabel("Koefisien OLS")
ax.set_title("Arah efek marginal (data sintetis)")
plt.tight_layout()
Studi kasus (sintetis): prediksi konsumsi energi
Koefisien (luas, penghuni, suhu): [ 2.0871342  16.59561006 -1.8207302 ]
Intercept: 65.845
MAE test: 28.62 kWh
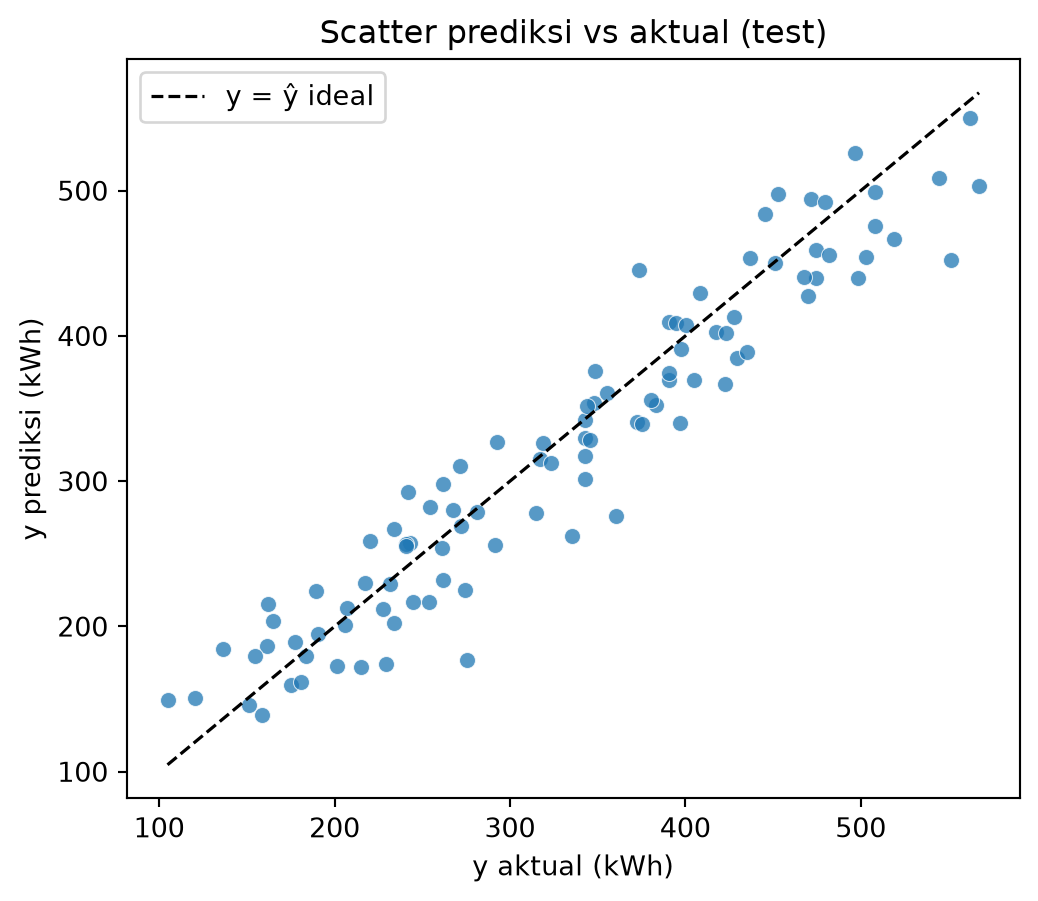
R2 test: 0.909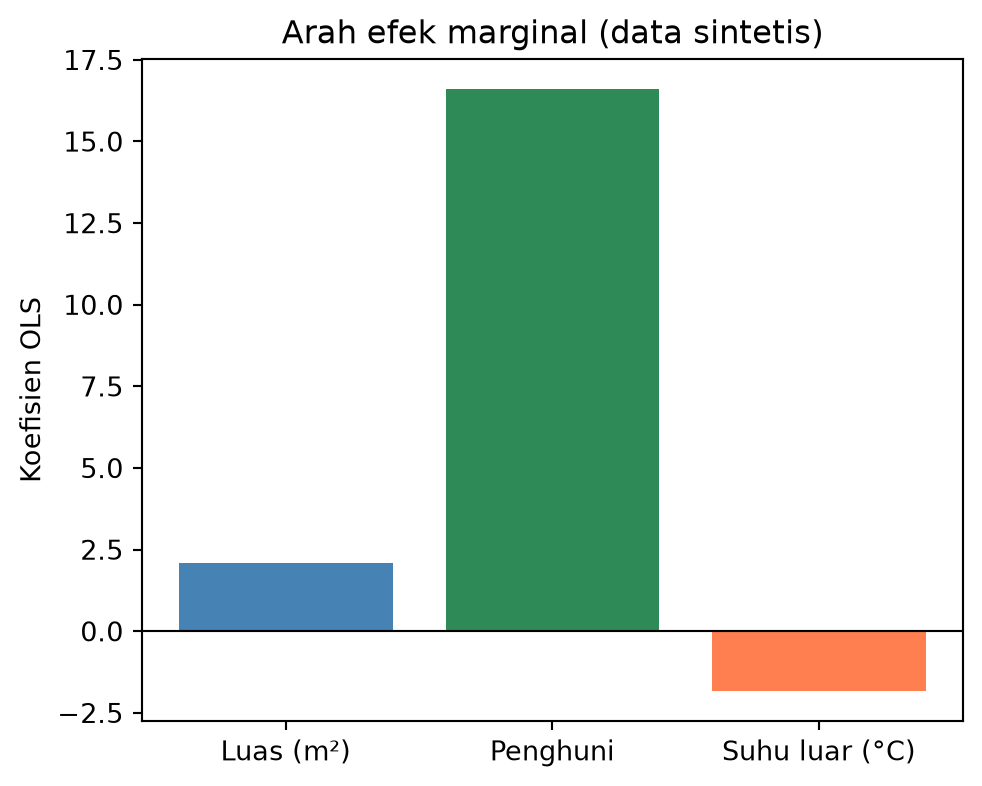
Prediksi vs aktual (test set)
import matplotlib.pyplot as plt

fig, ax = plt.subplots(figsize=(5.5, 4.8))
ax.scatter(y_test, pred_test, alpha=0.75, edgecolors="white", linewidths=0.4)
lims = [min(y_test.min(), pred_test.min()), max(y_test.max(), pred_test.max())]
ax.plot(lims, lims, "k--", linewidth=1.2, label="y = ŷ ideal")
ax.set_xlabel("y aktual (kWh)")
ax.set_ylabel("y prediksi (kWh)")
ax.set_title("Scatter prediksi vs aktual (test)")
ax.legend()
plt.tight_layout()
Titik mendekati garis identitas → prediksi kalibrasi baik pada rentang data.
Prediksi vs aktual (test set)
Outlier: apa dampaknya pada OLS?
Outlier bisa berupa nilai \(y\) ekstrem (residual besar), kombinasi \(x\) ekstrem dengan \(y\) tidak mengikuti pola (leverage tinggi), atau kesalahan ukur / input.
OLS meminimumkan jumlah kuadrat residual — satu titik dengan error besar memberi kontribusi proposional kuadrat sehingga garis / hyperplane dapat tertarik ke arah outlier (bias estimasi pada wilayah “normal”).
Akibat praktis: RMSE meledak; koefisien tidak lagi mencerminkan mayoritas data; prediksi di rentang tipikal memburuk.
Demo: satu outlier vertikal menggeser garis OLS
import matplotlib.pyplot as plt
import numpy as np
from sklearn.linear_model import LinearRegression
from sklearn.metrics import mean_absolute_error, mean_squared_error

rng = np.random.default_rng(7)
n = 55
x = rng.uniform(0, 10, size=n)
y = 8.0 + 1.9 * x + rng.normal(0, 0.75, size=n)
X = x.reshape(-1, 1)
lr_clean = LinearRegression().fit(X, y)
xp = np.linspace(0, 10, 200).reshape(-1, 1)

# Satu titik: x normal, y sangat tinggi (mis. salah ketik / promo anomali)
x_out = np.append(x, 4.5)
y_out = np.append(y, 38.0)
X_out = x_out.reshape(-1, 1)
lr_out = LinearRegression().fit(X_out, y_out)

def rmse(a, b):
    return float(np.sqrt(mean_squared_error(a, b)))

fig, axes = plt.subplots(1, 2, figsize=(12, 4.4))
for ax, xx, yy, model, title in zip(
    axes,
    [x, x_out],
    [y, y_out],
    [lr_clean, lr_out],
    ["Data bersih", "Data + 1 outlier vertikal"],
):
    ax.scatter(xx, yy, alpha=0.8, edgecolors="white", linewidths=0.4)
    ax.plot(xp.ravel(), model.predict(xp), color="darkred", linewidth=2, label="OLS")
    ax.set_xlabel("x (mis. promosi / minggu)")
    ax.set_ylabel("y (mis. omzet juta)")
    ax.set_title(title)
    ax.legend(loc="upper left")

plt.tight_layout()
print("RMSE bersih (train):", round(rmse(y, lr_clean.predict(X)), 3))
print("RMSE + outlier (train):", round(rmse(y_out, lr_out.predict(X_out)), 3))
print("MAE + outlier:", round(mean_absolute_error(y_out, lr_out.predict(X_out)), 3))
Catatan: MAE naik lebih “perlahan” daripada RMSE saat ada ekstrem — salah satu alasan melaporkan keduanya.
Demo: satu outlier vertikal menggeser garis OLS
RMSE bersih (train): 0.644
RMSE + outlier (train): 2.915
MAE + outlier: 0.975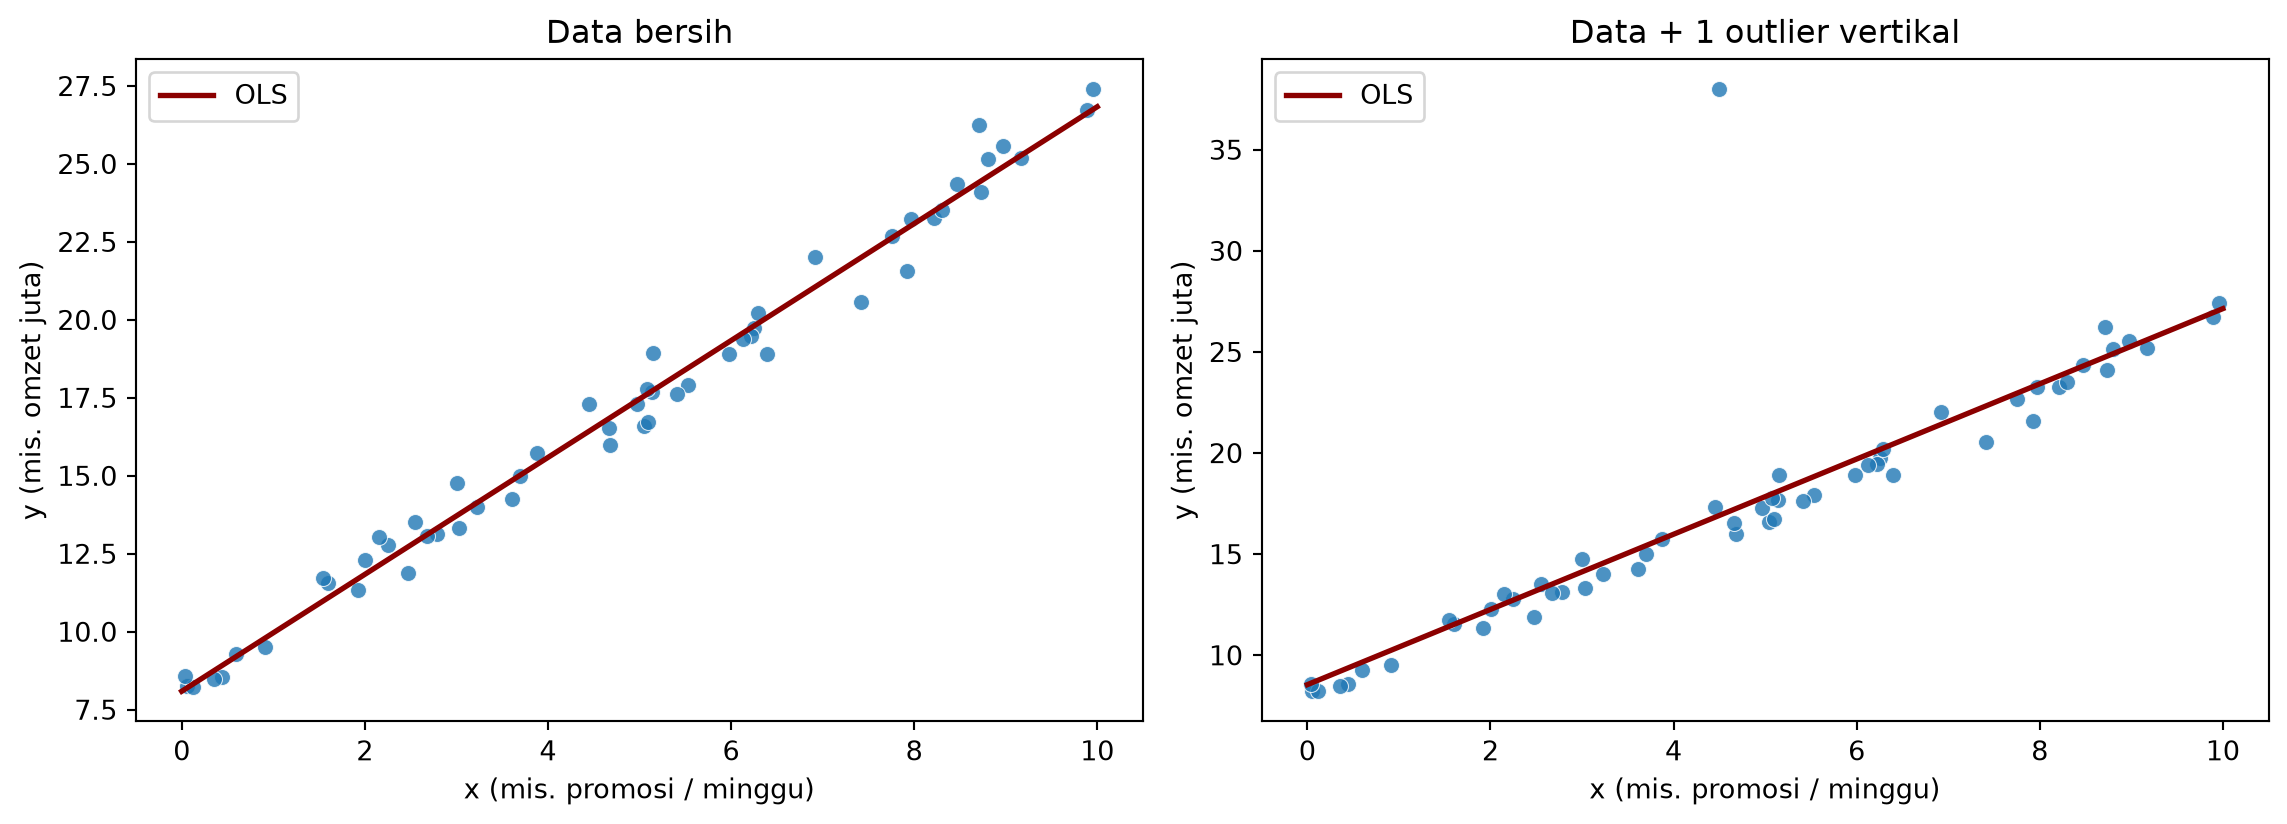
Mitigasi outlier (ringkas)
| Strategi | Kapan mempertimbangkan |
|---|---|
| Deteksi & koreksi aturan | typo, satuan salah, duplikat |
| Winsorize / cap | nilai di atas P99 bisnis masih valid tetapi dominasi kuadrat tidak diinginkan |
| Transformasi | log(y) jika varians residual membesar dengan \(\hat{y}\) |
| Metrik & loss | optimasi mendekati MAE → HuberRegressor, quantile / robust (kuliah lanjutan) |
| Robust / penalti | banyak noise berat tanpa katalog outlier tepercaya |
Demo: Huber vs OLS pada data dengan outlier
Huber loss: perilaku kuadrat dekat nol, linear untuk error besar → estimasi kurang dipengaruhi ekstrem dibanding OLS murni.
import matplotlib.pyplot as plt
import numpy as np
from sklearn.linear_model import HuberRegressor, LinearRegression
from sklearn.metrics import mean_absolute_error, mean_squared_error

rng = np.random.default_rng(11)
n = 80
x = rng.uniform(0, 10, size=n)
y = 5.0 + 2.2 * x + rng.normal(0, 0.9, size=n)
x_out = np.append(x, [3.0, 3.2, 8.0])
y_out = np.append(y, [32.0, 34.0, -5.0])
X_out = x_out.reshape(-1, 1)

ols = LinearRegression().fit(X_out, y_out)
hub = HuberRegressor(epsilon=1.35, max_iter=200).fit(X_out, y_out)
xp = np.linspace(0, 10, 200).reshape(-1, 1)

fig, ax = plt.subplots(figsize=(7.2, 4.5))
ax.scatter(x_out, y_out, alpha=0.75, edgecolors="white", linewidths=0.4, label="Data + outlier")
ax.plot(xp.ravel(), ols.predict(xp), color="darkred", linewidth=2, label="OLS")
ax.plot(xp.ravel(), hub.predict(xp), color="seagreen", linewidth=2, linestyle="--", label="Huber")
ax.legend()
ax.set_title("Garis: OLS tertarik outlier; Huber lebih stabil")
plt.tight_layout()

def rmse(a, b):
    return float(np.sqrt(mean_squared_error(a, b)))

print("RMSE OLS:", round(rmse(y_out, ols.predict(X_out)), 3))
print("RMSE Huber:", round(rmse(y_out, hub.predict(X_out)), 3))
print("MAE OLS:", round(mean_absolute_error(y_out, ols.predict(X_out)), 3))
print("MAE Huber:", round(mean_absolute_error(y_out, hub.predict(X_out)), 3))
Demo: Huber vs OLS pada data dengan outlier
RMSE OLS: 4.522
RMSE Huber: 4.557
MAE OLS: 1.688
MAE Huber: 1.571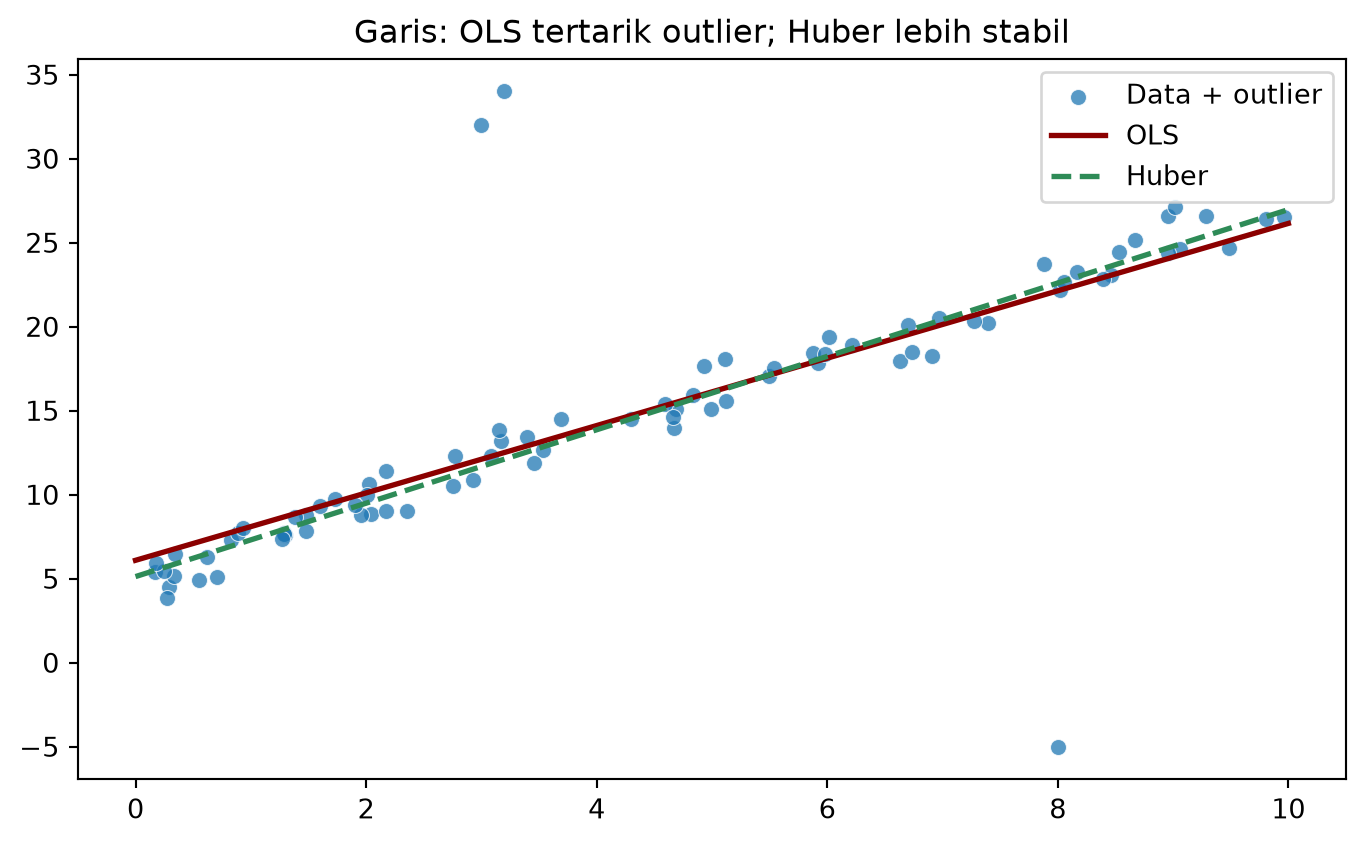
Polynomial regression — ide inti
Jika hubungan \(x \mapsto y\) melengkung, kita bisa perluas fitur:
\[ \phi(x) = (1, x, x^2, \ldots, x^d)^\top, \qquad \hat{y} = \phi(x)^\top \boldsymbol{\beta} \]
Ini tetap linear pada parameter \(\boldsymbol{\beta}\) → masih OLS pada \(\phi(x)\).
Di sklearn: PolynomialFeatures(degree=d) + LinearRegression dalam Pipeline.
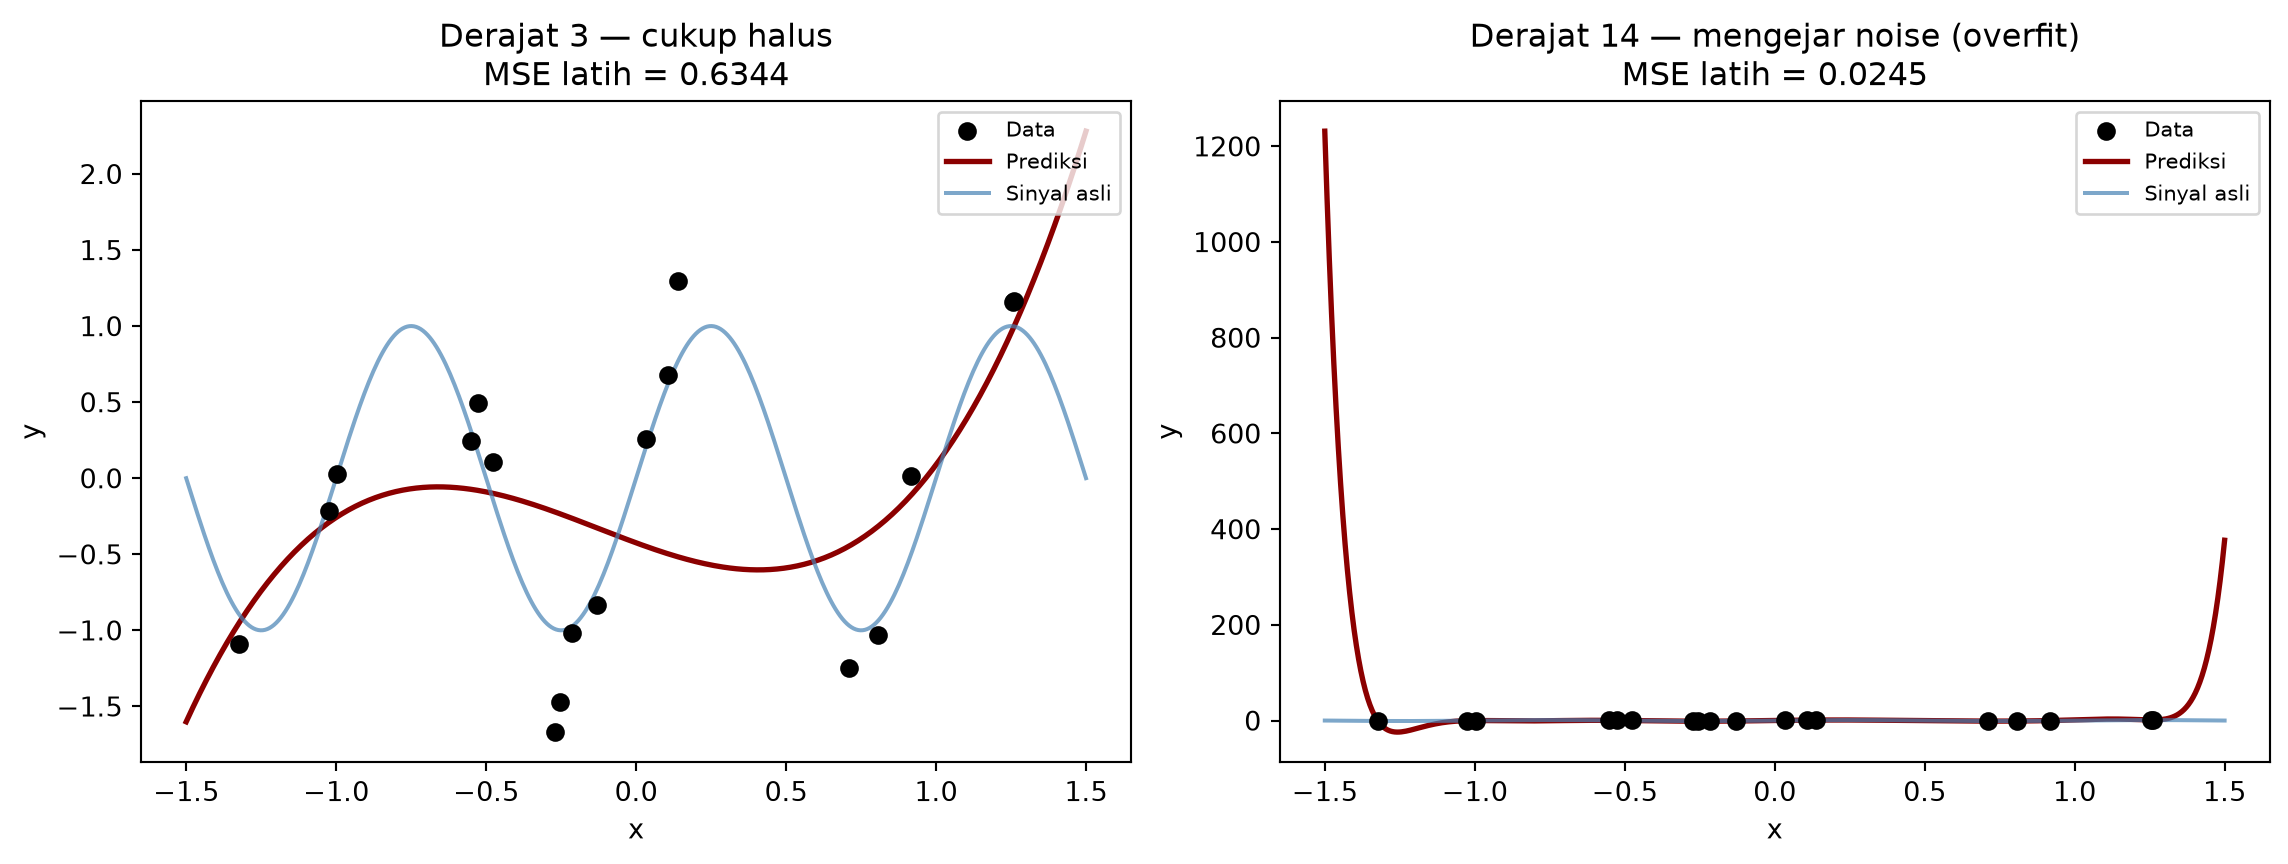
Risiko overfitting pada derajat tinggi
import matplotlib.pyplot as plt
import numpy as np
from sklearn.linear_model import LinearRegression
from sklearn.metrics import mean_squared_error
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import PolynomialFeatures

rng = np.random.default_rng(1)
n = 18
x = np.sort(rng.uniform(-1.4, 1.4, size=n))
y = np.sin(2 * np.pi * x) + rng.normal(0, 0.25, size=n)
X = x.reshape(-1, 1)
x_fine = np.linspace(-1.5, 1.5, 400).reshape(-1, 1)

def poly_pipe(d):
    return Pipeline(
        [
            ("poly", PolynomialFeatures(degree=d, include_bias=True)),
            ("lin", LinearRegression()),
        ]
    )

fig, axes = plt.subplots(1, 2, figsize=(12, 4.6))
for ax, d, title in zip(
    axes,
    [3, 14],
    ["Derajat 3 — cukup halus", "Derajat 14 — mengejar noise (overfit)"],
):
    model = poly_pipe(d).fit(X, y)
    ax.scatter(x, y, color="black", zorder=3, label="Data")
    ax.plot(x_fine, model.predict(x_fine), color="darkred", linewidth=2, label="Prediksi")
    ax.plot(x_fine, np.sin(2 * np.pi * x_fine), color="steelblue", alpha=0.7, label="Sinyal asli")
    train_mse = mean_squared_error(y, model.predict(X))
    ax.set_title(f"{title}\nMSE latih = {train_mse:.4f}")
    ax.set_xlabel("x")
    ax.set_ylabel("y")
    ax.legend(loc="upper right", fontsize=8)
plt.tight_layout()
Pesan: MSE latih bisa turun drastis sementara MSE test memburuk — pilih derajat / kompleksitas via validasi silang atau penalti.
Risiko overfitting pada derajat tinggi
Validasi silang: memilih derajat polinomial
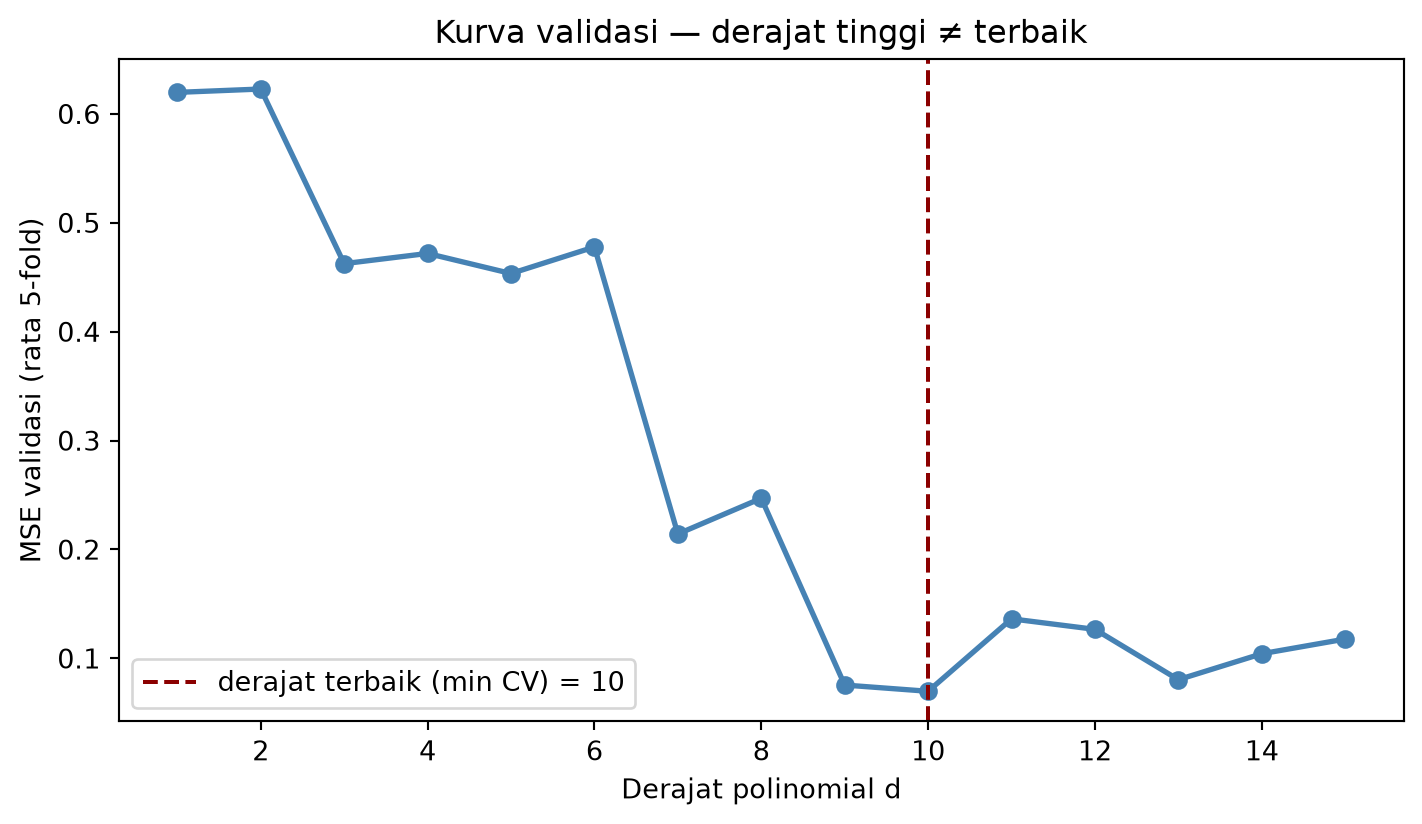
Prosedur: bagi data menjadi \(k\) lipatan; untuk tiap kandidat derajat \(d\), latih pada \(k-1\) lipatan, evaluasi MSE pada lipatan tersisa; ratakan MSE validasi. Pilih \(d\) yang meminimumkan error validasi (atau aturan one-standard-error jika ingin model lebih sederhana).
import matplotlib.pyplot as plt
import numpy as np
from sklearn.linear_model import LinearRegression
from sklearn.metrics import mean_squared_error
from sklearn.model_selection import KFold
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import PolynomialFeatures

rng = np.random.default_rng(1)
n = 60
x = np.sort(rng.uniform(-1.4, 1.4, size=n))
y = np.sin(2 * np.pi * x) + rng.normal(0, 0.28, size=n)
X = x.reshape(-1, 1)

def poly_pipe(d):
    return Pipeline(
        [
            ("poly", PolynomialFeatures(degree=d, include_bias=True)),
            ("lin", LinearRegression()),
        ]
    )

degrees = np.arange(1, 16)
kf = KFold(n_splits=5, shuffle=True, random_state=0)
cv_mse = []
for d in degrees:
    fold_mse = []
    for tr, va in kf.split(X):
        m = poly_pipe(int(d)).fit(X[tr], y[tr])
        fold_mse.append(mean_squared_error(y[va], m.predict(X[va])))
    cv_mse.append(np.mean(fold_mse))

best_d = int(degrees[np.argmin(cv_mse)])
fig, ax = plt.subplots(figsize=(7.5, 4.4))
ax.plot(degrees, cv_mse, "o-", color="steelblue", linewidth=2, markersize=6)
ax.axvline(best_d, color="darkred", linestyle="--", linewidth=1.5, label=f"derajat terbaik (min CV) = {best_d}")
ax.set_xlabel("Derajat polinomial d")
ax.set_ylabel("MSE validasi (rata 5-fold)")
ax.set_title("Kurva validasi — derajat tinggi ≠ terbaik")
ax.legend()
plt.tight_layout()
Validasi silang: memilih derajat polinomial
Regularisasi — motivasi
OLS tanpa batas dapat menghasilkan koefisien besar dan variansi tinggi jika:
- \(p\) mendekati / melebihi \(n\), atau
- kolom \(\mathbf{X}\) hampir linear bergantung (multikolinearitas).
Regularisasi menambahkan penalti pada magnitudo \(\boldsymbol{\beta}\):
\[ \min_{\boldsymbol{\beta}} \|\mathbf{y}-\mathbf{X}\boldsymbol{\beta}\|_2^2 + \lambda \cdot \text{Penalti}(\boldsymbol{\beta}) \]
\(\lambda \geq 0\) mengontrol kompromi bias–variansi.
Ridge regression (L2)
Penalti: \(\|\boldsymbol{\beta}_{1:p}\|_2^2\) (sering tidak mempenalti intercept; di sklearn atur fit_intercept=True).
\[ \min_{\boldsymbol{\beta}} \|\mathbf{y}-\mathbf{X}\boldsymbol{\beta}\|_2^2 + \alpha \sum_{j=1}^p \beta_j^2 \]
Efek: mengecilkan koefisien bersama-sama; tidak membuat koefisien persis nol → tidak seleksi fitur keras.
Kapan: banyak fitur berkorelasi, stabilisasi numerik, prediksi MSE baik.
Lasso (L1)
Penalti: \(\|\boldsymbol{\beta}_{1:p}\|_1 = \sum_j |\beta_j|\).
\[ \min_{\boldsymbol{\beta}} \|\mathbf{y}-\mathbf{X}\boldsymbol{\beta}\|_2^2 + \alpha \sum_{j=1}^p |\beta_j| \]
Efek: beberapa \(\beta_j\) bisa menjadi 0 → seleksi fitur implisit; model lebih sparse.
Catatan: solusi tidak selalu unik jika fitur berkorelasi kuat; Elastic Net sering lebih stabil.
Elastic Net (L1 + L2)
\[ \min_{\boldsymbol{\beta}} \|\mathbf{y}-\mathbf{X}\boldsymbol{\beta}\|_2^2 + \alpha \bigl( \rho \|\boldsymbol{\beta}_{1:p}\|_1 + \tfrac{1-\rho}{2}\|\boldsymbol{\beta}_{1:p}\|_2^2 \bigr) \]
\(\rho\) (l1_ratio di sklearn): campuran Lasso–Ridge. Berguna saat banyak grup fitur berkorelasi.
Intuisi geometris: L1 vs L2
Tanpa penalti, solusi OLS meminimumkan SSE pada ruang \(\mathbb{R}^{p+1}\). Dengan penalti, solusi menjadi titik kompromi antara cocok dengan data dan kecilnya norma koefisien.
- Ridge (L2): kontur penalti berbentuk bola — koefisien mengecil bersamaan (shrinking halus).
- Lasso (L1): kontur penalti berbentuk diamond dengan puncak di sumbu — optimum sering menyentuh puncak sehingga beberapa koefisien tepat nol → sparse.
Demo: Ridge vs Lasso pada data Diabetes
import matplotlib.pyplot as plt
import numpy as np
from sklearn.datasets import load_diabetes
from sklearn.linear_model import LassoCV, LinearRegression, RidgeCV
from sklearn.metrics import mean_squared_error
from sklearn.model_selection import train_test_split
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler

X, y = load_diabetes(return_X_y=True, as_frame=False)
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=11)

ols = LinearRegression().fit(X_train, y_train)
ridge = Pipeline(
    [
        ("scale", StandardScaler()),
        ("model", RidgeCV(alphas=np.logspace(-3, 3, 40))),
    ]
).fit(X_train, y_train)
lasso = Pipeline(
    [
        ("scale", StandardScaler()),
        ("model", LassoCV(alphas=np.logspace(-3, 3, 40), cv=5, random_state=0, max_iter=20000)),
    ]
).fit(X_train, y_train)

def rmse(model, Xt, yt):
    return float(np.sqrt(mean_squared_error(yt, model.predict(Xt))))

print("RMSE test OLS:", round(rmse(ols, X_test, y_test), 3))
print("RMSE test Ridge:", round(rmse(ridge, X_test, y_test), 3))
print("alpha Ridge terpilih:", round(ridge.named_steps["model"].alpha_, 5))
print("RMSE test Lasso:", round(rmse(lasso, X_test, y_test), 3))
print("alpha Lasso terpilih:", round(lasso.named_steps["model"].alpha_, 5))

coef_names = load_diabetes().feature_names
fig, axes = plt.subplots(1, 2, figsize=(12, 4.8))
xpos = np.arange(len(coef_names))
w = 0.25
axes[0].bar(xpos - w, ols.coef_, width=w, label="OLS")
axes[0].bar(xpos, ridge.named_steps["model"].coef_, width=w, label="Ridge (scaled X)")
axes[0].bar(xpos + w, lasso.named_steps["model"].coef_, width=w, label="Lasso (scaled X)")
axes[0].set_xticks(xpos)
axes[0].set_xticklabels(coef_names, rotation=45, ha="right")
axes[0].set_ylabel("Koefisien")
axes[0].legend()
axes[0].set_title("Perbandingan koefisien (skala berbeda vs OLS)")
axes[1].stem(np.arange(len(coef_names)), np.abs(lasso.named_steps["model"].coef_), basefmt=" ")
axes[1].set_xticks(np.arange(len(coef_names)))
axes[1].set_xticklabels(coef_names, rotation=45, ha="right")
axes[1].set_ylabel("|koefisien|")
axes[1].set_title("Lasso — beberapa fitur diset ke nol (sparse)")
plt.tight_layout()
Catatan: Ridge/Lasso di atas memakai standarisasi fitur di pipeline — penting karena penalti membandingkan magnitudo koefisien.
Demo: Ridge vs Lasso pada data Diabetes
RMSE test OLS: 56.68
RMSE test Ridge: 57.194
alpha Ridge terpilih: 28.94266
RMSE test Lasso: 57.017
alpha Lasso terpilih: 0.41246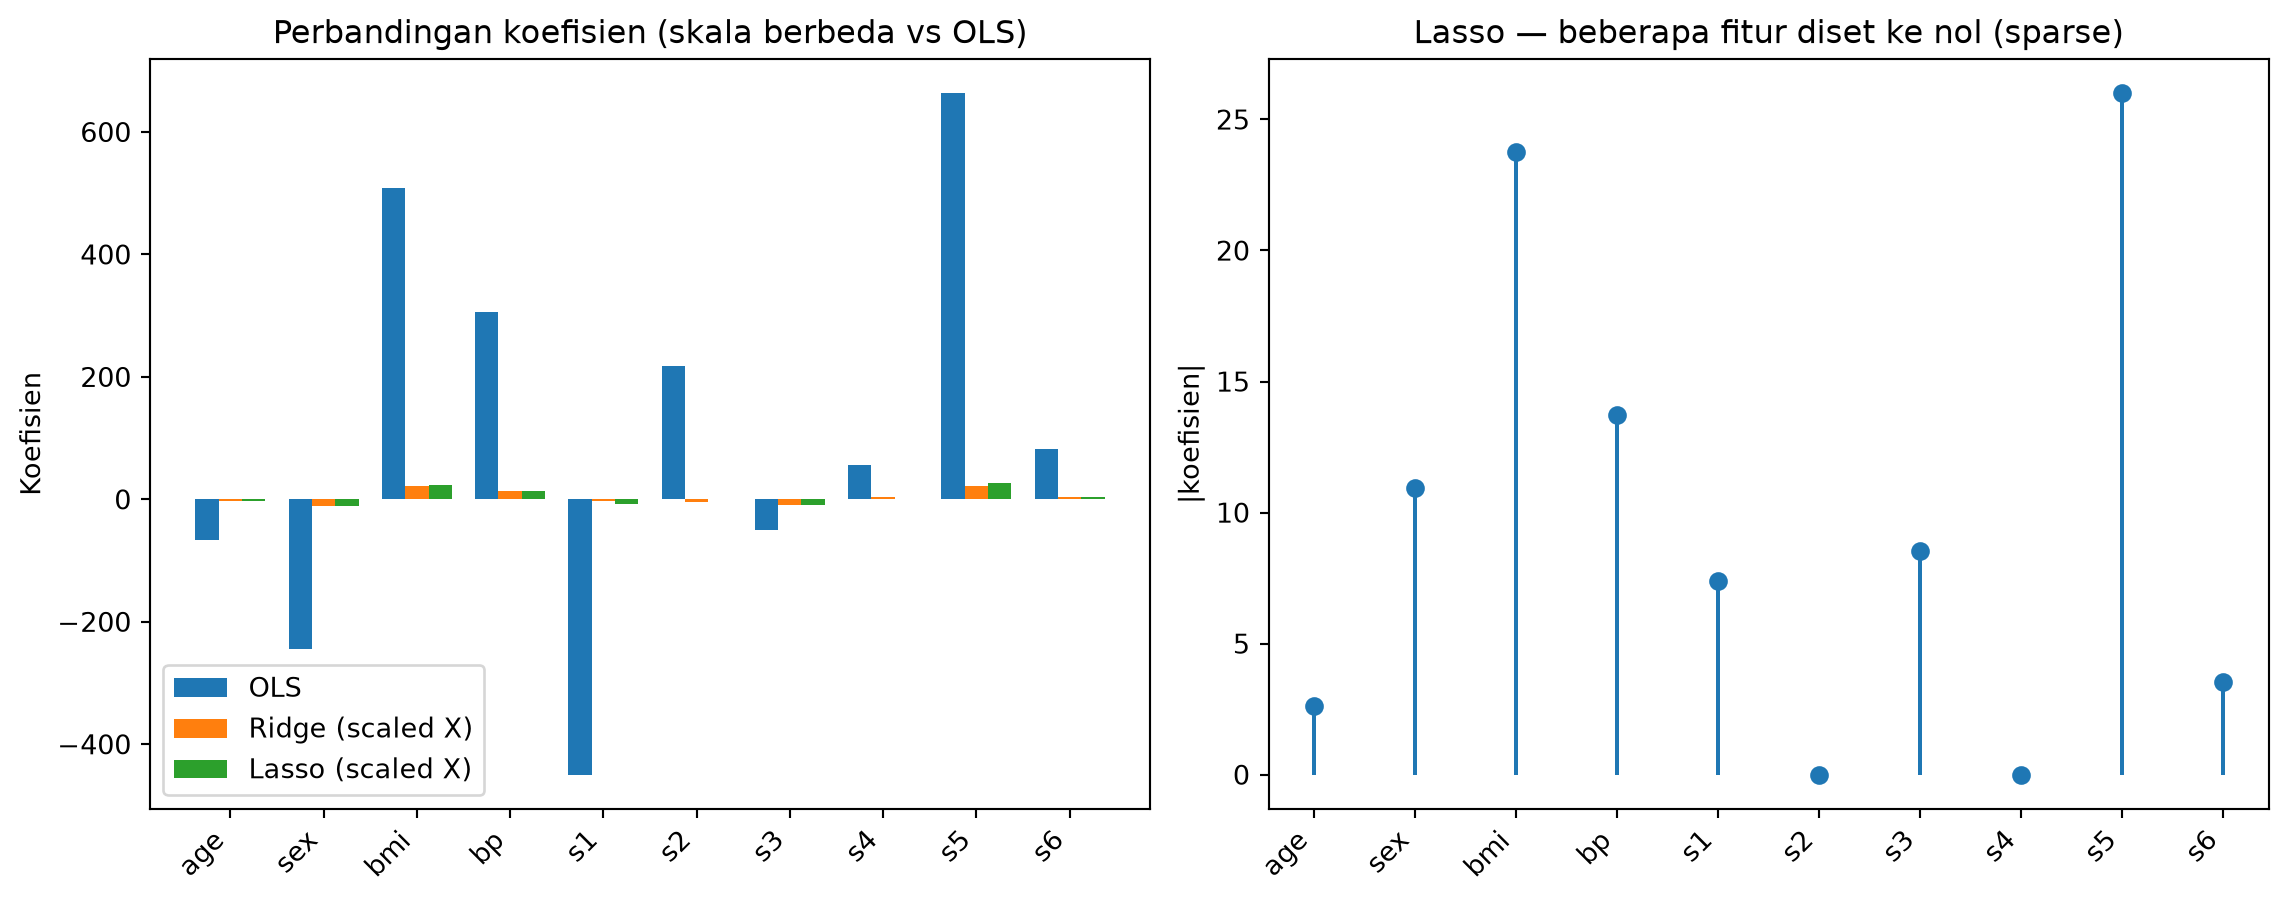
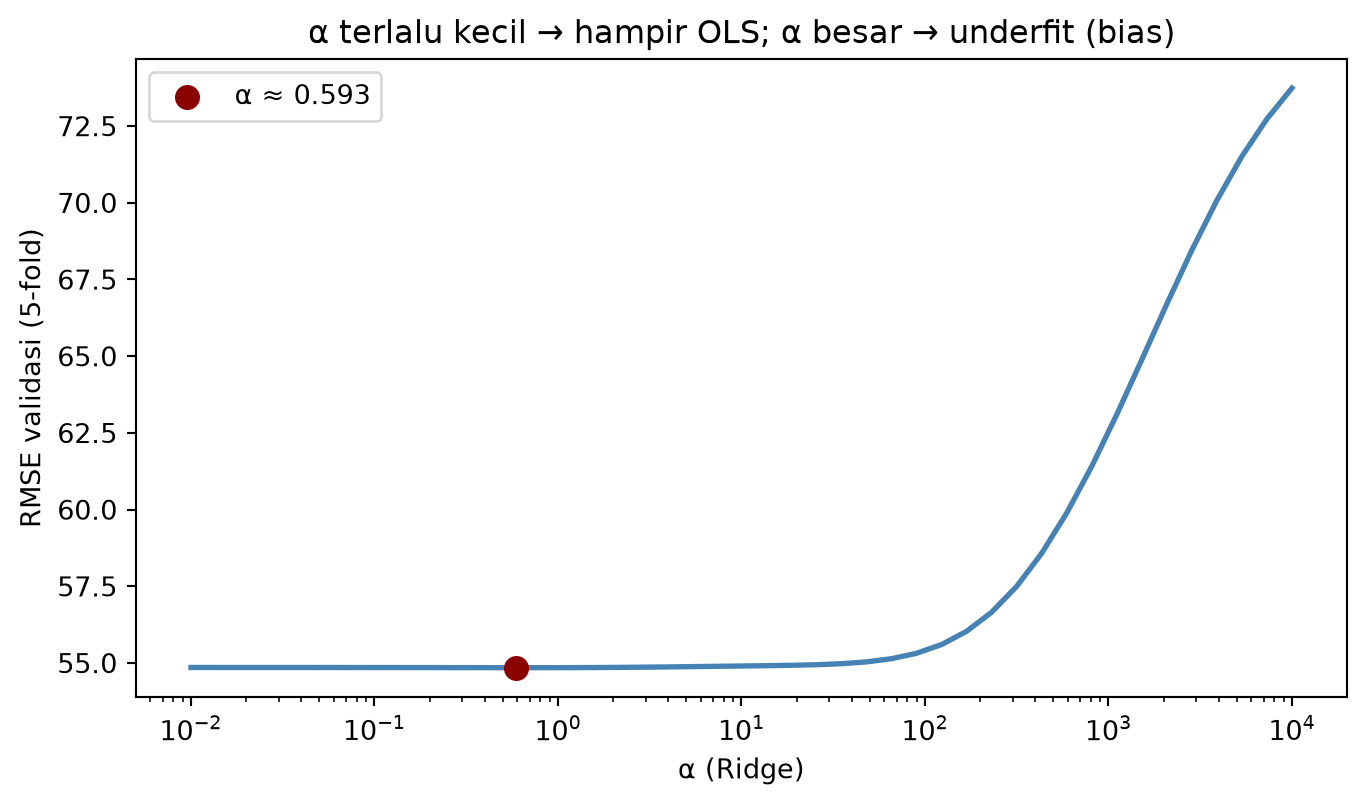
Kurva validasi: Ridge vs \(\alpha\) (data Diabetes)
import matplotlib.pyplot as plt
import numpy as np
from sklearn.datasets import load_diabetes
from sklearn.linear_model import Ridge
from sklearn.metrics import mean_squared_error
from sklearn.model_selection import KFold
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler

X, y = load_diabetes(return_X_y=True, as_frame=False)
alphas = np.logspace(-2, 4, 45)
kf = KFold(n_splits=5, shuffle=True, random_state=3)
cv_rmse = []
for a in alphas:
    fold_rmse = []
    for tr, va in kf.split(X):
        pipe = Pipeline(
            [
                ("scale", StandardScaler()),
                ("ridge", Ridge(alpha=a)),
            ]
        )
        pipe.fit(X[tr], y[tr])
        pred = pipe.predict(X[va])
        fold_rmse.append(float(np.sqrt(mean_squared_error(y[va], pred))))
    cv_rmse.append(np.mean(fold_rmse))

best_a = alphas[int(np.argmin(cv_rmse))]
fig, ax = plt.subplots(figsize=(7.2, 4.3))
ax.semilogx(alphas, cv_rmse, color="steelblue", linewidth=2)
ax.scatter([best_a], [min(cv_rmse)], color="darkred", s=70, zorder=3, label=f"α ≈ {best_a:.3f}")
ax.set_xlabel("α (Ridge)")
ax.set_ylabel("RMSE validasi (5-fold)")
ax.set_title("α terlalu kecil → hampir OLS; α besar → underfit (bias)")
ax.legend()
plt.tight_layout()
Kurva validasi: Ridge vs \(\alpha\) (data Diabetes)
Studi kasus ringkas (domain)
| Domain | Target | Fitur (contoh) | Catatan pemodelan |
|---|---|---|---|
| Properti | Harga jual | luas, lokasi, umur bangunan | nonlinear spasial; polynomial parsial; regularisasi jika \(p\) besar |
| Ritel | Permintaan harian | promosi, harga, musim | lag & musiman; validasi waktu (time-series split) |
| Manufaktur | Waktu siklus mesin | suhu, getaran, operator | sensor berkorelasi → Ridge/Elastic Net |
| Kesehatan (agregat) | LOS rumah sakit | diagnosis grup, usia | etika & bias data; interpretabilitas |
| Keuangan | Spread / imbal hasil | rating, tenor, likuiditas | outlier acara pasar; robust atau winsorize |
| Lingkungan | PM2.5 harian | angin, pembangkit, musim | data sensor: missing & spike; validasi musiman |
Materi pengayaan (lanjutan mandiri)
- Heteroskedastisitas: varians residual bergantung pada \(\hat{y}\) — diplot |residual| vs \(\hat{y}\); sering membantu log(y) atau weighted least squares.
- Transformasi Box–Cox / Yeo–Johnson pada \(y\) atau fitur (hati-hati interpretasi) —
sklearn.preprocessing.PowerTransformer. - Interaksi \(x_1 x_2\) memperkaya linear tanpa derajat polinomial tinggi di satu sumbu.
- Polynomial + Ridge:
PolynomialFeatures+Ridgedalam satuPipelinemengurangi osilasi liar di tepi rentang \(x\). - Ekstrapolasi: polinomial tinggi di luar rentang latih bisa sangat salah — batasi prediksi pada domain data atau gunakan model dengan perilaku asimptotik.
- Interval prediksi vs interval kepercayaan mean — bedakan ketidakpastian rata-rata vs satu observasi baru (statistik klasik + bootstrap).
Alur kerja yang disarankan
- EDA — distribusi \(y\), missing, outlier, korelasi.
- Baseline — mean / median prediktor; linear sederhana.
- Fitur — transformasi (log), interaksi, polynomial jika perlu.
- Validasi — K-fold / time split; pilih metrik bisnis.
- Regularisasi — skala fitur;
RidgeCV/LassoCV/ElasticNetCV. - Laporan — koefisien + interval / SHAP (kuliah lanjutan) sesuai kebutuhan stakeholder.
Ringkasan
- Regresi = supervised learning dengan target kontinu; kerugian standar MSE setara memaksimumkan likelihood Gaussian dengan varians tetap (hubungan konseptual).
- Contoh kasus memetakan pertanyaan → \(y\) → metrik → validasi (acak vs waktu vs spasial).
- Outlier dapat menggeser OLS karena penalti kuadrat; bandingkan RMSE vs MAE, audit data, dan pertimbangkan Huber / transformasi.
- Linear & polynomial (dalam basis) memberi kontrol eksplisit atas kompleksitas; polynomial tinggi mudah overfit.
- Ridge menstabilkan koefisien; Lasso mendorong sparse; Elastic Net menggabungkan keduanya.
- Penskalaan fitur dan validasi adalah bagian integral, bukan “pilihan kosmetik”.
Referensi untuk mendalami
- James et al., An Introduction to Statistical Learning — bab regresi linear & regularisasi.
- Dokumentasi scikit-learn:
LinearRegression,PolynomialFeatures,Ridge,Lasso,ElasticNet,HuberRegressor, dan varian*CV.
MK Data Science 09 - Anggit Wirasto