import numpy as np
import pandas as pd

# Meniru POS: satu baris typo diskon, satu baris sentinel "belum diisi"
df = pd.DataFrame(
    {
        "id_trx": [101, 102, 103],
        "subtotal": [50000, 120000, 80000],
        "diskon": [5000, 150000, 999999],  # 102: diskon > subtotal; 103: sentinel
    }
)
# Validasi 1: diskon <= subtotal
bad_rule1 = df["diskon"] > df["subtotal"]
# Validasi 2: sentinel diskon -> missing
SENTINEL = 999999
is_sentinel = df["diskon"] >= SENTINEL

# Koreksi terkontrol (contoh ajar — di produksi butuh approval bisnis)
df_fix = df.copy()
df_fix.loc[is_sentinel, "diskon"] = np.nan
df_fix["diskon_capped"] = np.minimum(df_fix["diskon"].fillna(0), df_fix["subtotal"])
df_fix["flag_diskon_awal"] = np.select(
    [is_sentinel, bad_rule1],
    ["sentinel", "lebih_dari_subtotal"],
    default="ok",
)
df_fixValidasi Data, Transformasi Fitur, & Rekayasa Fitur
Data Science — pertemuan ke-7
Anggit Wirasto, S.Si., M.Eng.
Tujuan pembelajaran
Setelah materi ini, mahasiswa diharapkan mampu:
- Merancang validasi data (tipe, rentang, konsistensi, aturan domain) sebelum analisis atau pemodelan.
- Membedakan normalisasi, standarisasi, dan penskalaan robust serta memilih transformasi yang selaras dengan distribusi fitur.
- Menjelaskan rekayasa fitur: ekstraksi fitur baru, strategi pelabelan, dan integrasi beberapa sumber data.
- Mengimplementasikan langkah dasar dengan Pandas dan scikit-learn (
Pipeline, fit pada data latih).
Alur besar: dari data mentah ke matriks fitur
- Validasi — apakah data “masuk akal” dan konsisten dengan definisi?
- Pembersihan (DS-06) — missing, outlier, duplikat.
- Transformasi & penskalaan — bentuk numerik yang stabil untuk algoritme / jarak.
- Rekayasa fitur — kolom baru yang memperkaya sinyal untuk pertanyaan analitik.
Prinsip: dokumentasikan asumsi, parameter yang dipelajari dari data, dan dampaknya pada interpretasi.
Validasi data — apa yang dicek?
Validasi = pemeriksaan sistematis bahwa nilai dan struktur data sesuai ekspektasi sebelum dipakai untuk laporan atau model.
| Kelas pemeriksaan | Contoh |
|---|---|
| Struktur | Nama kolom, tipe (dtype), jumlah baris vs manifest |
| Rentang & format | usia \(\geq 0\), kode pos panjang tetap, tanggal ISO |
| Konsistensi silang | tanggal_mulai \(\leq\) tanggal_selesai; jumlah anak \(\leq\) 20 (domain) |
| Referensi / kunci | customer_id ada di master pelanggan |
| Aturan bisnis | diskon tidak melebihi harga; proporsi kategori tidak meledak tahun ke tahun |
Validasi di Pandas (contoh pola)
- Skema ringkas:
df.dtypes,df.shape,list(df.columns). - Unik & kardinalitas:
df["id"].is_unique,df["kategori"].nunique(). - Rentang:
(df["harga"] >= 0).all(),df["tgl"].between(t0, t1). - Katalog nilai:
set(df["status"]).issubset({"A","B","C"}).
Untuk produksi, kerangka seperti Great Expectations / pandera membantu versi aturan dan laporan — di kuliah, fokus pada logika pemeriksaan yang jelas.
Validasi vs “koreksi otomatis”
- Validasi sering menghasilkan laporan error atau flag baris bermasalah — keputusan koreksi adalah langkah terpisah.
- Auto-fix (mis. memotong string, membulatkan) berguna tetapi harus terdokumentasi agar tidak mengubah makna bisnis secara diam-diam.
Reproduksibilitas: simpan skrip/notebook yang menghasilkan ringkasan validasi (PASS/FAIL per aturan + jumlah baris gagal).
Contoh nyata — validasi & koreksi (retail / POS)
Konteks: ekspor harian dari kasir atau ERP ke data warehouse analitik.
| Aturan validasi | Gejala nyata | Koreksi / tindakan |
|---|---|---|
qty bilangan bulat \(\geq 0\) |
Baris retur tercatat sebagai qty negatif atau typo -1 |
Pisahkan ke tabel retur; untuk analisis penjualan kotor, set qty = abs(qty) hanya jika kebijakan bisnis membenarkan; lainnya flag untuk audit |
diskon \(\leq\) subtotal |
Promo “100% + voucher” atau double entry menyebabkan diskon > harga | Cap diskon = min(diskon, subtotal) atau tolak baris dan minta sumber perbaiki transaksi — dokumentasikan pilihan |
Contoh nyata — retail / POS (SKU & waktu transaksi)
| Aturan validasi | Gejala nyata | Koreksi / tindakan |
|---|---|---|
sku ada di master produk |
SKU lama / uji coba masih terkirim dari cabang | left_merge + kolom sku_valid; baris tanpa master → “unknown SKU” atau drop sesuai SLA |
tanggal_transaksi dalam jam operasi |
Shift malam melewati tengah malam → tanggal “salah hari” | Normalisasi ke zona waktu toko; aturan: jika jam < 05:00 anggap masih shift hari sebelumnya (kebijakan domain) |
Contoh nyata — validasi & koreksi (rekam medis / klinis, terde-identifikasi)
Konteks: integrasi vital sign dari perangkat beda merek ke satu fact table.
| Aturan validasi | Gejala nyata | Koreksi / tindakan |
|---|---|---|
tanggal_lahir \(<\) tanggal_kunjungan |
Typo tahun (1990 vs 1909) atau default 01-01-1900 dari sistem lama |
Tolak untuk analisis umur; minta koreksi di sumber; jika mustahil, set usia missing + indikator |
spo2 \(\in [0, 100]\) |
Satu vendor mengirim 0–1 float (0.97), lainnya persen 97 | Standarisasi satuan ke persen: spo2 = spo2 * 100 jika spo2.max() <= 1 |
Contoh nyata — rekam medis (denyut & suhu deret waktu)
| Aturan validasi | Gejala nyata | Koreksi / tindakan |
|---|---|---|
denyut_nadi \(40{-}220\) (rentang screening) |
Artefak sensor 300 atau 0 | Winsorize ke persentil 1–99 atau NaN + flag “artefak” — jangan diam-diam isi median tanpa log |
suhu_c konsisten antar pengukuran berurutan |
Loncatan fisik mustahil 36 → 41 dalam satu menit | Validasi laju perubahan; tandai pasangan waktu untuk review perawat |
Contoh nyata — validasi & koreksi (survei, API, data terbuka)
| Aturan validasi | Gejala nyata | Koreksi / tindakan |
|---|---|---|
| Kode “tidak dijawab” tidak boleh jadi angka | Kuesioner memakai 999 untuk “menolak jawab” | replace({999: np.nan}) + kolom menolak_X biner jika pola MNAR relevan |
email format RFC ringkas |
Spasi, huruf besar campur, gmail.con |
Trim + lowercase untuk deduplikasi; typo domain → tidak auto-perbaiki massal; flag daftar untuk verifikasi |
Contoh nyata — survei & data terbuka (CSV & kode wilayah)
| Aturan validasi | Gejala nyata | Koreksi / tindakan |
|---|---|---|
| CSV pemerintah: delimiter / encoding | File ; dengan Windows-1252 di lingkungan UTF-8 |
read_csv(..., sep=';', encoding='cp1252') — simpan versi berkas + hash di log validasi |
| Kode wilayah ISO konsisten | ID-JK vs JK vs 31 |
Tabel pemetaan kanonik (dictionary) ke satu kode; baris tak dikenal → UNKNOWN + laporan |
Mini-demo: validasi silang + sentinel (Pandas)
Catatan: koreksi di atas mencampur imputasi (fillna(0) untuk cap) dengan pelabelan — di laporan sebutkan bahwa trx 103 tanpa diskon resmi diperlakukan sebagai 0 untuk agregasi atau ditahan untuk verifikasi.
Mini-demo: validasi silang + sentinel (Pandas)
| id_trx | subtotal | diskon | diskon_capped | flag_diskon_awal | |
|---|---|---|---|---|---|
| 0 | 101 | 50000 | 5000.0 | 5000.0 | ok |
| 1 | 102 | 120000 | 150000.0 | 120000.0 | lebih_dari_subtotal |
| 2 | 103 | 80000 | NaN | 0.0 | sentinel |
Normalisasi, standarisasi, & penskalaan robust
Istilah di literatur campuran; yang penting rumus dan kapan dipakai.
| Nama umum | Rumus (intuisi) | Kapan sering dipakai |
|---|---|---|
| Min–Max (normalisasi ke \([0,1]\)) | \((x-\min)/(\max-\min)\) | Jarak terbatas, neural net input terbatas, interpretasi “proporsi rentang” |
| Z-score (standarisasi) | \((x-\mu)/\sigma\) | Asumsi mendekati normal, banyak model linear / SVM |
| RobustScaler | \((x-\text{median})/\text{IQR}\) | Banyak outlier; ingin penskalaan yang tidak dikuasai ekstrem |
Mengapa penskalaan memengaruhi algoritme?
- Metode berbasis jarak atau penalti magnitude (k-NN, SVM, ridge/Lasso) sensitif terhadap satuan dan skala fitur.
- Pohon keputusan berbasis ambang kurang sensitif terhadap monoton linear, tetapi transformasi nonlinear (log, binning) tetap bisa membantu.
- Gradient descent pada jaringan saraf umumnya lebih stabil jika fitur berada pada rentang serupa.
Contoh kasus: normalisasi & standarisasi
Dua skenario tabular sintetis (bisa direplikasi di notebook) untuk melihat bentuk distribusi sebelum dan sesudah transformasi:
| Kasus | Fitur 1 | Fitur 2 | Intuisi |
|---|---|---|---|
| A — Kampanye e-commerce | Biaya promosi (IDR, rentang lebar + sedikit ekstrem) | Skor ulasan (1–10) | Dua skala numerik sangat berbeda; metode berbasis jarak “memihak” fitur besar |
| B — Sensor wearable | Suhu tubuh (°C, ~36–40) | Detak jantung (BPM, ~55–110) | Satuan berbeda; tanpa penskalaan, BPM mendominasi jarak Euclidean |
Parameter Min–Max dan Z-score di bawah dihitung dari subset latih (75%) — sama seperti praktik pemodelan.
Kasus A — Data mentah (sintetis)
Setting: \(n=600\) cabang / periode; promosi_idr mengikuti log-normal dengan beberapa nilai ekstrem (kampanye besar); skor_ulasan terbatas 1–10.
import matplotlib.pyplot as plt
import numpy as np
import pandas as pd

rng = np.random.default_rng(7)
n = 600
promosi = rng.lognormal(12, 0.45, size=n)
promosi[rng.choice(n, size=14, replace=False)] *= 3.8
skor = np.clip(rng.normal(7.2, 1.05, size=n), 1, 10)
df_a = pd.DataFrame({"promosi_idr": promosi, "skor_ulasan": skor})

fig, axes = plt.subplots(1, 2, figsize=(11, 4))
axes[0].hist(df_a["promosi_idr"], bins=42, color="steelblue", edgecolor="white", alpha=0.9)
axes[0].set_title("Biaya promosi (IDR, sintetis)")
axes[0].set_xlabel("IDR")
axes[1].hist(df_a["skor_ulasan"], bins=18, color="seagreen", edgecolor="white", alpha=0.9)
axes[1].set_title("Skor ulasan (1–10)")
axes[1].set_xlabel("skor")
fig.suptitle("Kasus A — dua skala sebelum penskalaan", fontsize=12, y=1.02)
plt.tight_layout()
Kasus A — Data mentah (sintetis)
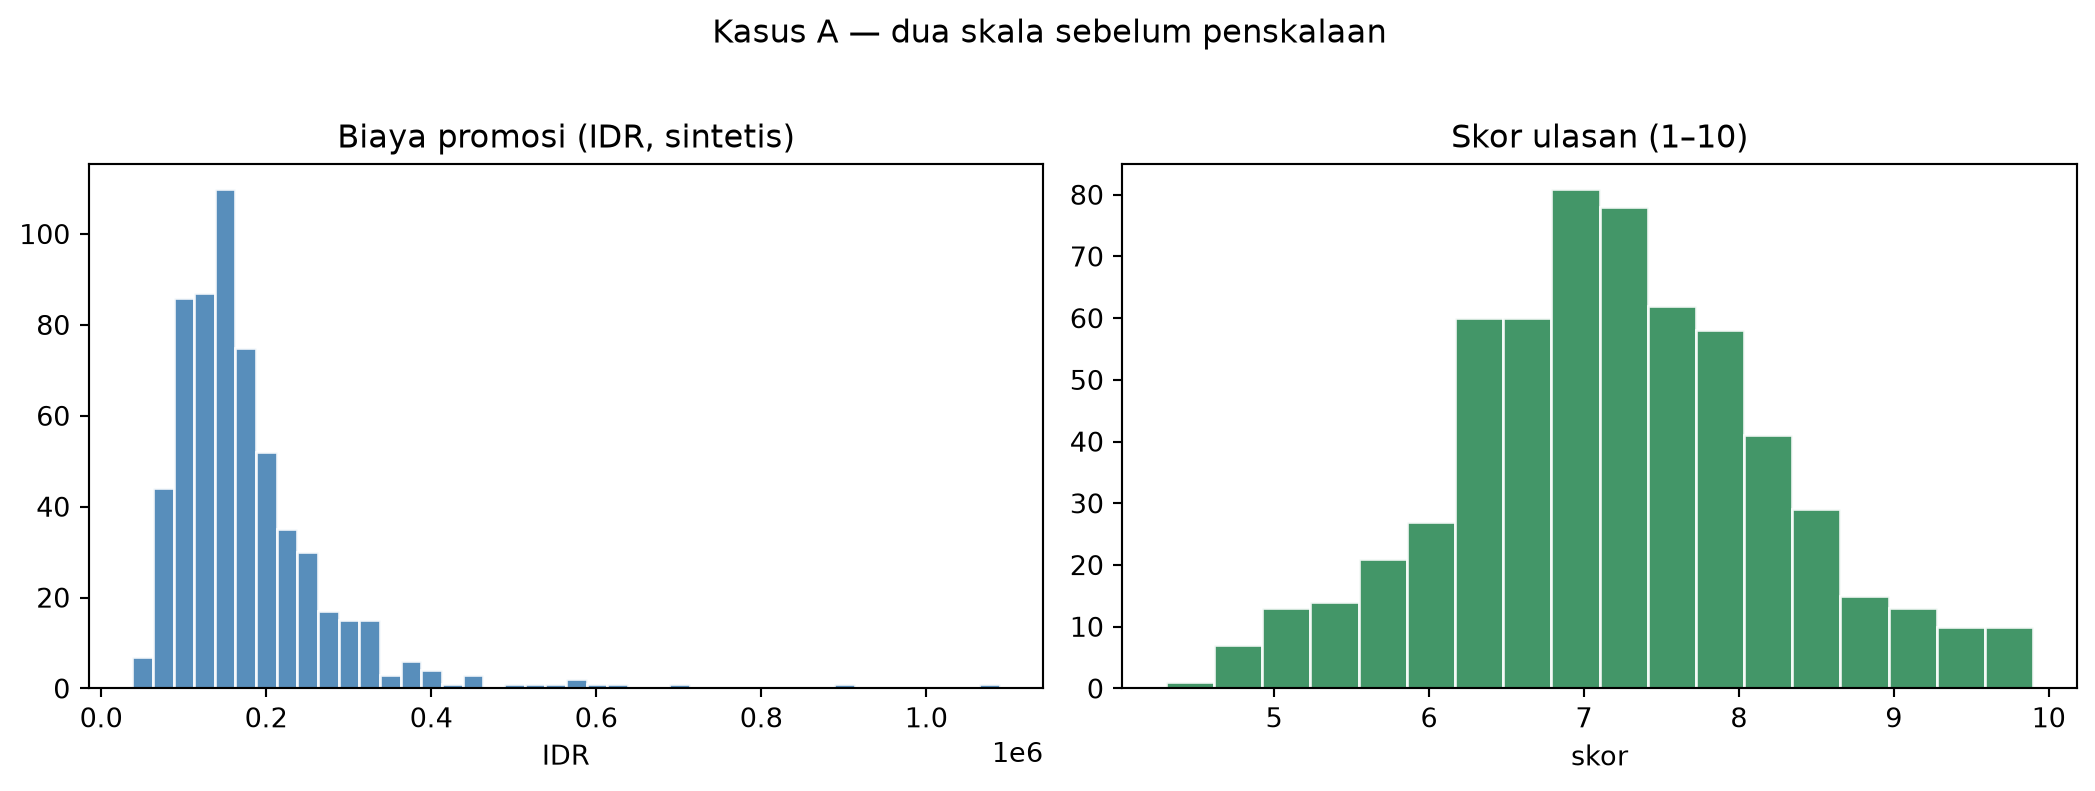
Kasus A — penjelasan grafik (data mentah)
Grafik ini menunjukkan dua variabel dengan “dunia ukuran” yang sangat berbeda sebelum penskalaan apa pun.
- Biaya promosi (kiri): bentuk menceng ke kanan (mirip log-normal) karena banyak nilai moderat dan beberapa kampanye besar di ekor. Sumbu horizontal dalam IDR, sehingga jarak antar titik di sumbu ini secara numerik sangat besar dibanding perbedaan skor.
- Skor ulasan (kanan): terkunci di 1–10, histogram relatif sempit dan menumpuk di sekitar nilai tengah — variasi “hanya” beberapa poin.
- Mengapa penting: algoritme berbasis jarak Euclidean atau penalti magnitude akan memperlakukan “selisih satu juta rupiah” jauh lebih berat daripada “selisih satu poin skor”, sehingga promosi mendominasi meskipun skor sama-sama bermakna untuk bisnis.
Kasus A — Min–Max vs Z-score (subset latih)
Min–Max: tiap kolom dipetakan ke \([0,1]\) memakai \(\min\) dan \(\max\) hanya dari data latih. Z-score: mean dan simpangan baku hanya dari data latih. Histogram berikut memakai baris train agar konsisten dengan aturan fit.
ix = rng.permutation(n)
cut = int(0.75 * n)
train_a = df_a.iloc[ix[:cut]]
cols = ["promosi_idr", "skor_ulasan"]
tr = train_a[cols]

mn, mx = tr.min(), tr.max()
span = (mx - mn).replace(0, np.nan).fillna(1.0)
train_mm = (tr - mn) / span

mu = tr.mean()
sig = tr.std(ddof=0).replace(0, np.nan).fillna(1.0)
train_z = (tr - mu) / sig

fig, axes = plt.subplots(2, 2, figsize=(11, 7))
axes[0, 0].hist(train_mm["promosi_idr"], bins=38, color="coral", edgecolor="white", alpha=0.9)
axes[0, 0].set_title("Min–Max [0,1] — promosi")
axes[0, 0].set_xlabel("nilai")
axes[0, 1].hist(train_mm["skor_ulasan"], bins=16, color="coral", edgecolor="white", alpha=0.9)
axes[0, 1].set_title("Min–Max [0,1] — skor")
axes[1, 0].hist(train_z["promosi_idr"], bins=38, color="mediumpurple", edgecolor="white", alpha=0.9)
axes[1, 0].set_title("Z-score — promosi")
axes[1, 0].set_xlabel("z")
axes[1, 1].hist(train_z["skor_ulasan"], bins=16, color="mediumpurple", edgecolor="white", alpha=0.9)
axes[1, 1].set_title("Z-score — skor")
axes[1, 1].set_xlabel("z")
fig.suptitle("Kasus A — bandingkan bentuk distribusi setelah transformasi (train)", fontsize=12, y=1.01)
plt.tight_layout()
Kasus A — Min–Max vs Z-score (subset latih)
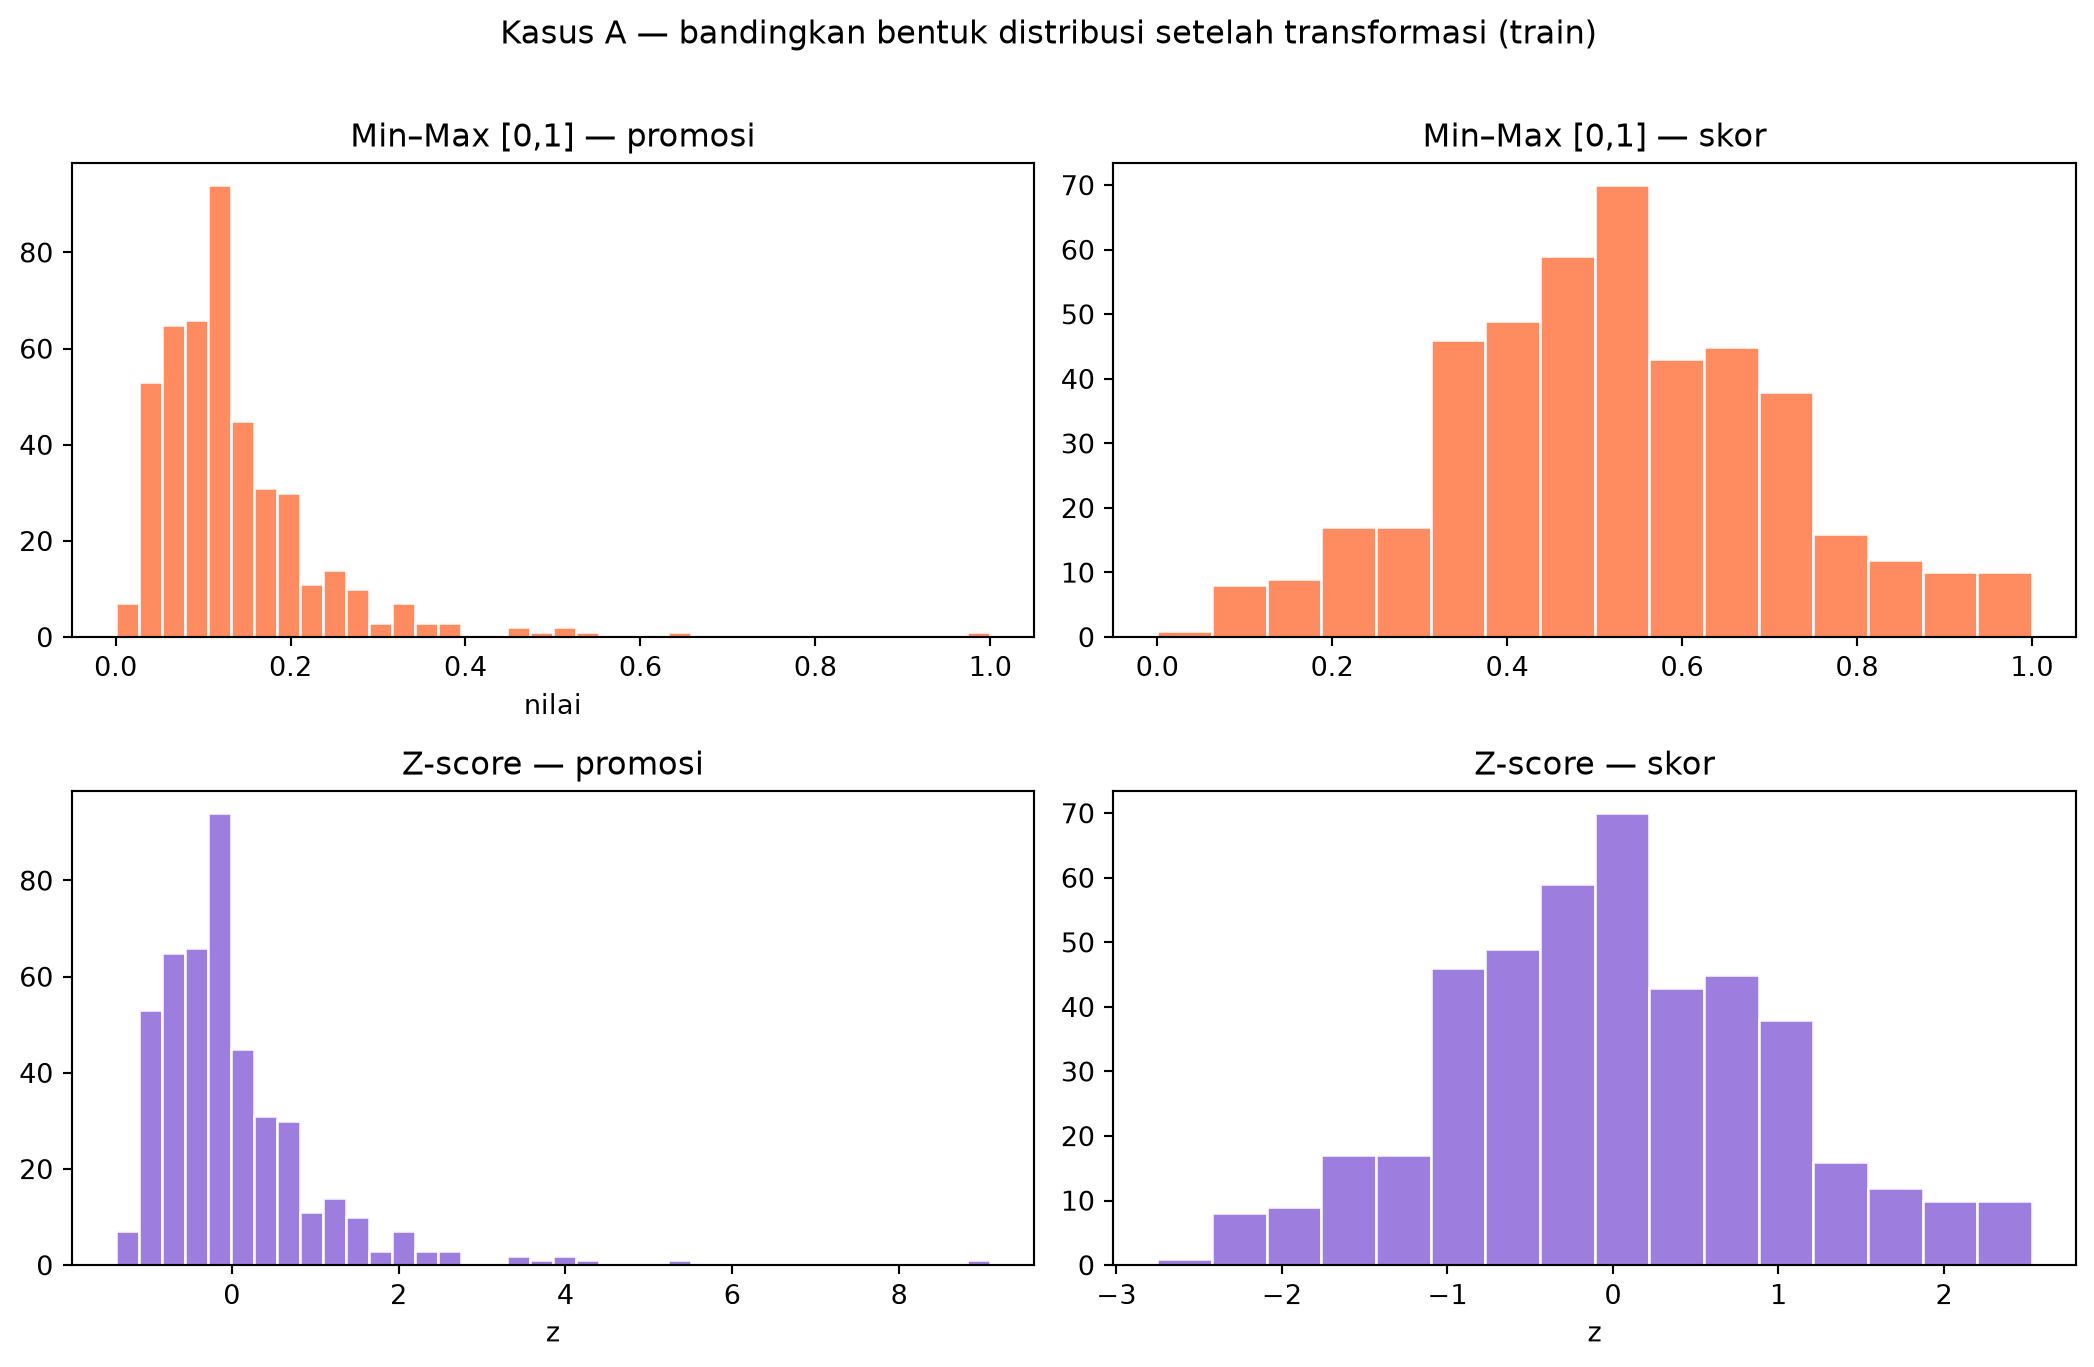
Kasus A — penjelasan grafik (baris atas: Min–Max)
Baris atas memakai \(\min\) dan \(\max\) dari data latih saja, lalu memetakan tiap kolom ke rentang \([0,1]\).
- Promosi (kiri atas): karena ada nilai ekstrem, rentang \(\max-\min\) menjadi sangat lebar. Akibnya mayoritas nilai “normal” terdorong ke bin di dekat 0 — histogram terlihat mencekik di kiri: banyak detail di rentang utama terkompresi dalam lebar sumbu yang pendek.
- Skor (kanan atas): rentang asli sudah sempit; setelah Min–Max bentuknya tetap mulus, tetapi sekarang sebanding dengan promosi dalam skala \([0,1]\) — keduanya “bicara” dalam satuan rentang yang sama untuk algoritme berbasis jarak.
Kasus A — penjelasan grafik (baris bawah: Z-score)
Baris bawah memakai mean dan simpangan baku dari data latih; nilai dinyatakan sebagai berapa simpangan baku dari rata-rata (\(z\)).
- Promosi (kiri bawah): massa data terpusat di sekitar 0, tetapi ekor ke kanan tetap panjang — outlier dan kampanye besar masih terbaca sebagai ekor distribusi, bukan lenyap.
- Skor (kanan bawah): distribusi mengelompok di sekitar 0 dengan penyebaran wajar; dua fitur kini sebanding dalam satuan statistik (bukan lagi rupiah vs poin mentah).
- Min–Max vs Z-score (intuisi): Min–Max menekankan “posisi dalam rentang operasional” dan mudah dipengaruhi satu ekstrem; Z-score menekankan “berapa jauh dari tipikal” dan biasanya lebih stabil untuk membandingkan bentuk penyebaran antar fitur ketika ada pencilan.
Kasus A — scatter: dampak pada jarak (ilustrasi)
Titik P = median promosi & median skor; titik Q = kuantil 90 promosi & kuantil 10 skor. Jarak Euclidean mentah vs setelah penskalaan (parameter dari train) menunjukkan dominasi fitur ber-skala besar sebelum transformasi.
p_prom = float(tr["promosi_idr"].median())
p_skor = float(tr["skor_ulasan"].median())
q_prom = float(tr["promosi_idr"].quantile(0.9))
q_skor = float(tr["skor_ulasan"].quantile(0.1))

def euclid(a1, a2, b1, b2):
    return float(np.sqrt((a1 - b1) ** 2 + (a2 - b2) ** 2))

d_raw = euclid(p_prom, p_skor, q_prom, q_skor)

p_mm = ((np.array([p_prom, p_skor]) - mn.to_numpy()) / span.to_numpy()).flatten()
q_mm = ((np.array([q_prom, q_skor]) - mn.to_numpy()) / span.to_numpy()).flatten()
d_mm = float(np.linalg.norm(p_mm - q_mm))

p_z = ((np.array([p_prom, p_skor]) - mu.to_numpy()) / sig.to_numpy()).flatten()
q_z = ((np.array([q_prom, q_skor]) - mu.to_numpy()) / sig.to_numpy()).flatten()
d_z = float(np.linalg.norm(p_z - q_z))

fig, axes = plt.subplots(1, 3, figsize=(11, 4))
axes[0].scatter(tr["promosi_idr"], tr["skor_ulasan"], alpha=0.35, s=12, c="gray")
axes[0].scatter([p_prom, q_prom], [p_skor, q_skor], c=["tab:blue", "tab:red"], s=80, zorder=3)
axes[0].set_title(f"Mentah\njarak P–Q ≈ {d_raw:,.0f}")
axes[0].set_xlabel("promosi (IDR)")
axes[0].set_ylabel("skor")

axes[1].scatter(train_mm["promosi_idr"], train_mm["skor_ulasan"], alpha=0.35, s=12, c="gray")
axes[1].scatter([p_mm[0], q_mm[0]], [p_mm[1], q_mm[1]], c=["tab:blue", "tab:red"], s=80, zorder=3)
axes[1].set_title(f"Min–Max\njarak P–Q ≈ {d_mm:.2f}")
axes[1].set_xlabel("promosi (min–max)")
axes[1].set_ylabel("skor (min–max)")

axes[2].scatter(train_z["promosi_idr"], train_z["skor_ulasan"], alpha=0.35, s=12, c="gray")
axes[2].scatter([p_z[0], q_z[0]], [p_z[1], q_z[1]], c=["tab:blue", "tab:red"], s=80, zorder=3)
axes[2].set_title(f"Z-score\njarak P–Q ≈ {d_z:.2f}")
axes[2].set_xlabel("promosi (z)")
axes[2].set_ylabel("skor (z)")
fig.suptitle("Kasus A — dua titik contoh (biru & merah) pada ruang fitur", fontsize=11, y=1.05)
plt.tight_layout()
Kasus A — scatter: dampak pada jarak (ilustrasi)
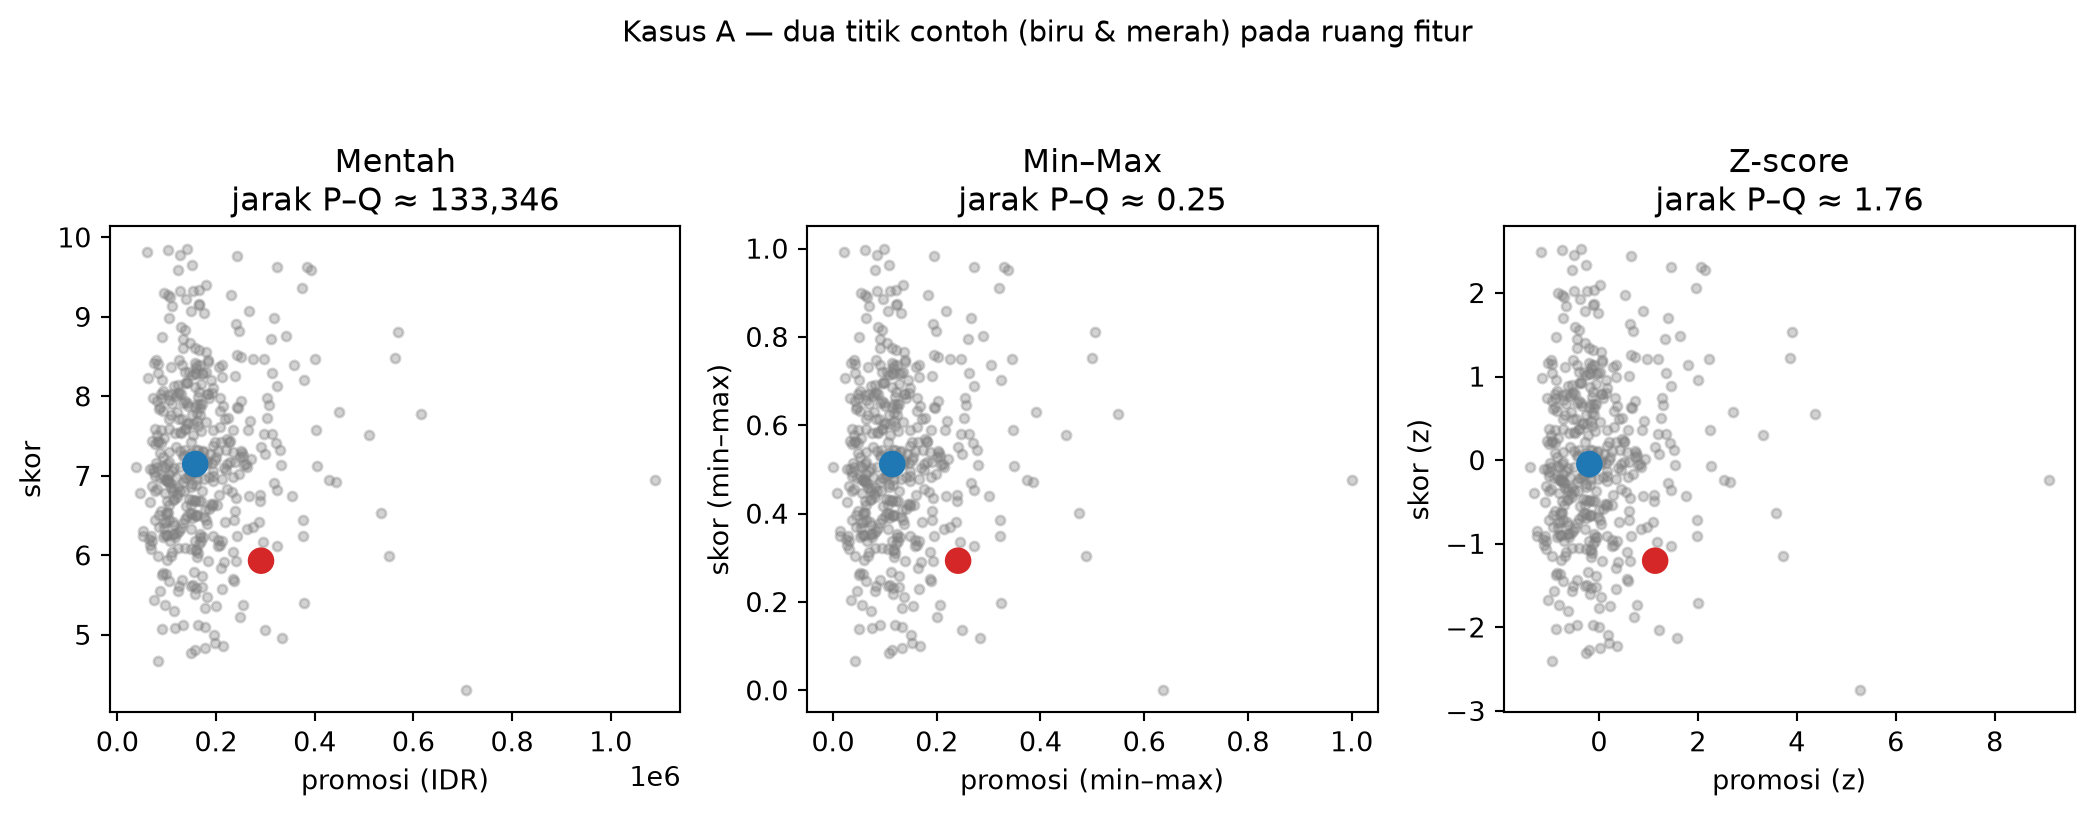
Kasus A — penjelasan grafik (scatter & jarak P–Q)
Titik abu-abu = semua observasi train di ruang dua dimensi. Biru (P) = median promosi & median skor (“cabang tipikal”). Merah (Q) = kuantil 90 promosi & kuantil 10 skor (“promosi besar tetapi ulasan rendah”).
- Panel kiri (mentah): sumbu promosi dalam IDR. Jarak Euclidean P–Q sangat besar (tertulis di judul) karena selisih rupiah mendominasi; sumbu skor hampir tidak mempengaruhi angka jarak.
- Panel tengah (Min–Max): kedua sumbu dalam \([0,1]\); jarak P–Q turun drastis ke orde satuan — kedua fitur ikut menentukan jarak secara seimbang.
- Panel kanan (Z-score): jarak diukur dalam gabungan simpangan baku per sumbu; lagi-lagi jarak terkendali dan tidak lagi dikuasai oleh skala rupiah mentah.
- Penskalaan mengubah geometri ruang fitur; metode yang memakai jarak atau regularisasi magnitude perlu transformasi agar tidak memihak fitur yang kebetulan punya satuan besar.
Kasus B — Sensor wearable (sintetis)
Setting: suhu tubuh (°C) dan BPM; keduanya numerik “wajar” medis tetapi satuan dan rentang berbeda — serupa banyak pasangan fitur on-device.
suhu = np.clip(rng.normal(36.9, 0.55, size=500), 35.5, 40.5)
bpm = np.clip(rng.normal(78, 12, size=500), 50, 130)
bpm[rng.choice(500, size=10, replace=False)] += 35
df_b = pd.DataFrame({"suhu_c": suhu, "bpm": bpm})

fig, axes = plt.subplots(1, 2, figsize=(11, 4))
axes[0].hist(df_b["suhu_c"], bins=32, color="teal", edgecolor="white", alpha=0.9)
axes[0].set_title("Suhu tubuh (°C)")
axes[0].set_xlabel("°C")
axes[1].hist(df_b["bpm"], bins=35, color="indianred", edgecolor="white", alpha=0.9)
axes[1].set_title("Detak jantung (BPM)")
axes[1].set_xlabel("BPM")
fig.suptitle("Kasus B — distribusi mentah", fontsize=12, y=1.02)
plt.tight_layout()
Kasus B — Sensor wearable (sintetis)
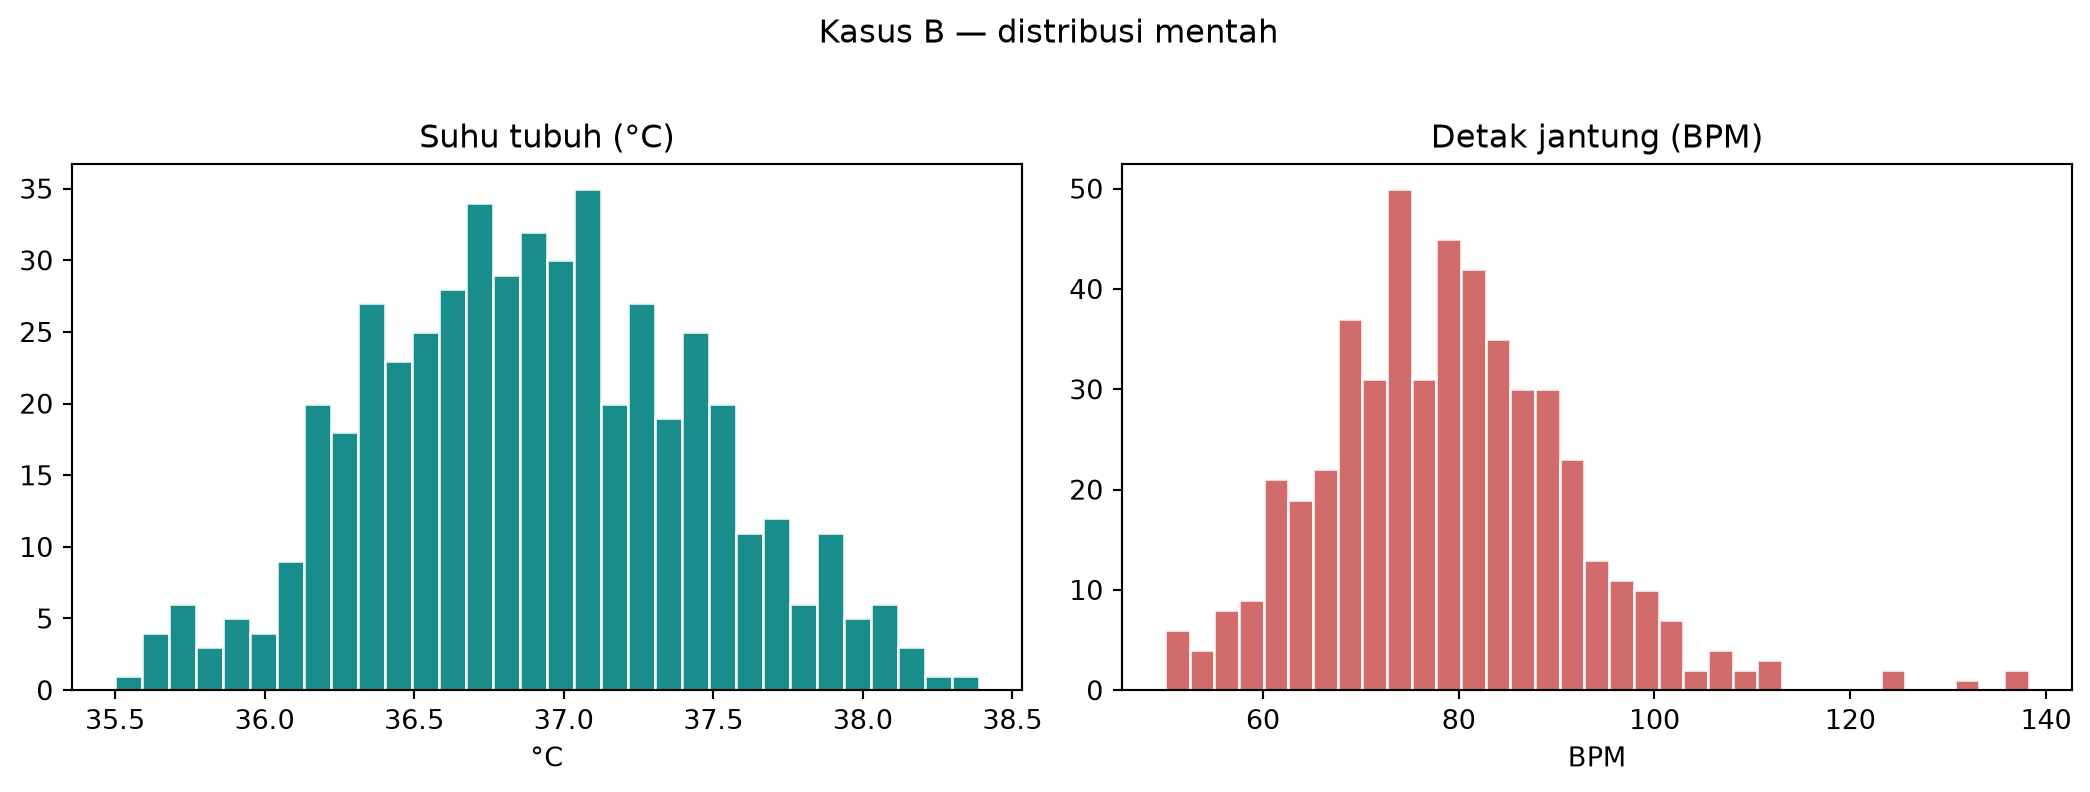
Kasus B — penjelasan grafik (data mentah)
Berbeda dengan Kasus A, di sini kedua variabel terlihat “kecil” angkanya, tetapi satuan dan rentang tetap beda secara fisika.
- Suhu (°C): variasi tipis sekitar 37–40 — perubahan 0,5 °C bisa klinis bermakna.
- BPM: rentang lebih lebar (puluhan beat); ditambah beberapa lonjakan sintetis di ekor kanan BPM (artefak / aktivitas ekstrem).
- Tanpa penskalaan, di k-NN/SVM jarak akan lebih sensitif terhadap perbedaan puluhan BPM daripada perbedaan kecil suhu — padahal keduanya sama-sama sinyal fisiologis. Grafik berikut menunjukkan bagaimana Min–Max dan Z-score menyetarakan peran keduanya di ruang numerik.
Kasus B — bandingkan Min–Max dan Z-score (train 75%)
ixb = rng.permutation(len(df_b))
cutb = int(0.75 * len(df_b))
tr_b = df_b.iloc[ixb[:cutb]]
cols_b = ["suhu_c", "bpm"]
tb = tr_b[cols_b]

mnb, mxb = tb.min(), tb.max()
spb = (mxb - mnb).replace(0, np.nan).fillna(1.0)
tb_mm = (tb - mnb) / spb
mub = tb.mean()
sib = tb.std(ddof=0).replace(0, np.nan).fillna(1.0)
tb_z = (tb - mub) / sib

fig, axes = plt.subplots(2, 2, figsize=(11, 7))
axes[0, 0].hist(tb_mm["suhu_c"], bins=28, color="darkcyan", edgecolor="white", alpha=0.85)
axes[0, 0].set_title("Min–Max — suhu")
axes[0, 1].hist(tb_mm["bpm"], bins=28, color="darkcyan", edgecolor="white", alpha=0.85)
axes[0, 1].set_title("Min–Max — BPM")
axes[1, 0].hist(tb_z["suhu_c"], bins=28, color="darkorchid", edgecolor="white", alpha=0.85)
axes[1, 0].set_title("Z-score — suhu")
axes[1, 1].hist(tb_z["bpm"], bins=28, color="darkorchid", edgecolor="white", alpha=0.85)
axes[1, 1].set_title("Z-score — BPM")
fig.suptitle("Kasus B — setelah transformasi (train)", fontsize=12, y=1.01)
plt.tight_layout()
Kasus B — bandingkan Min–Max dan Z-score (train 75%)
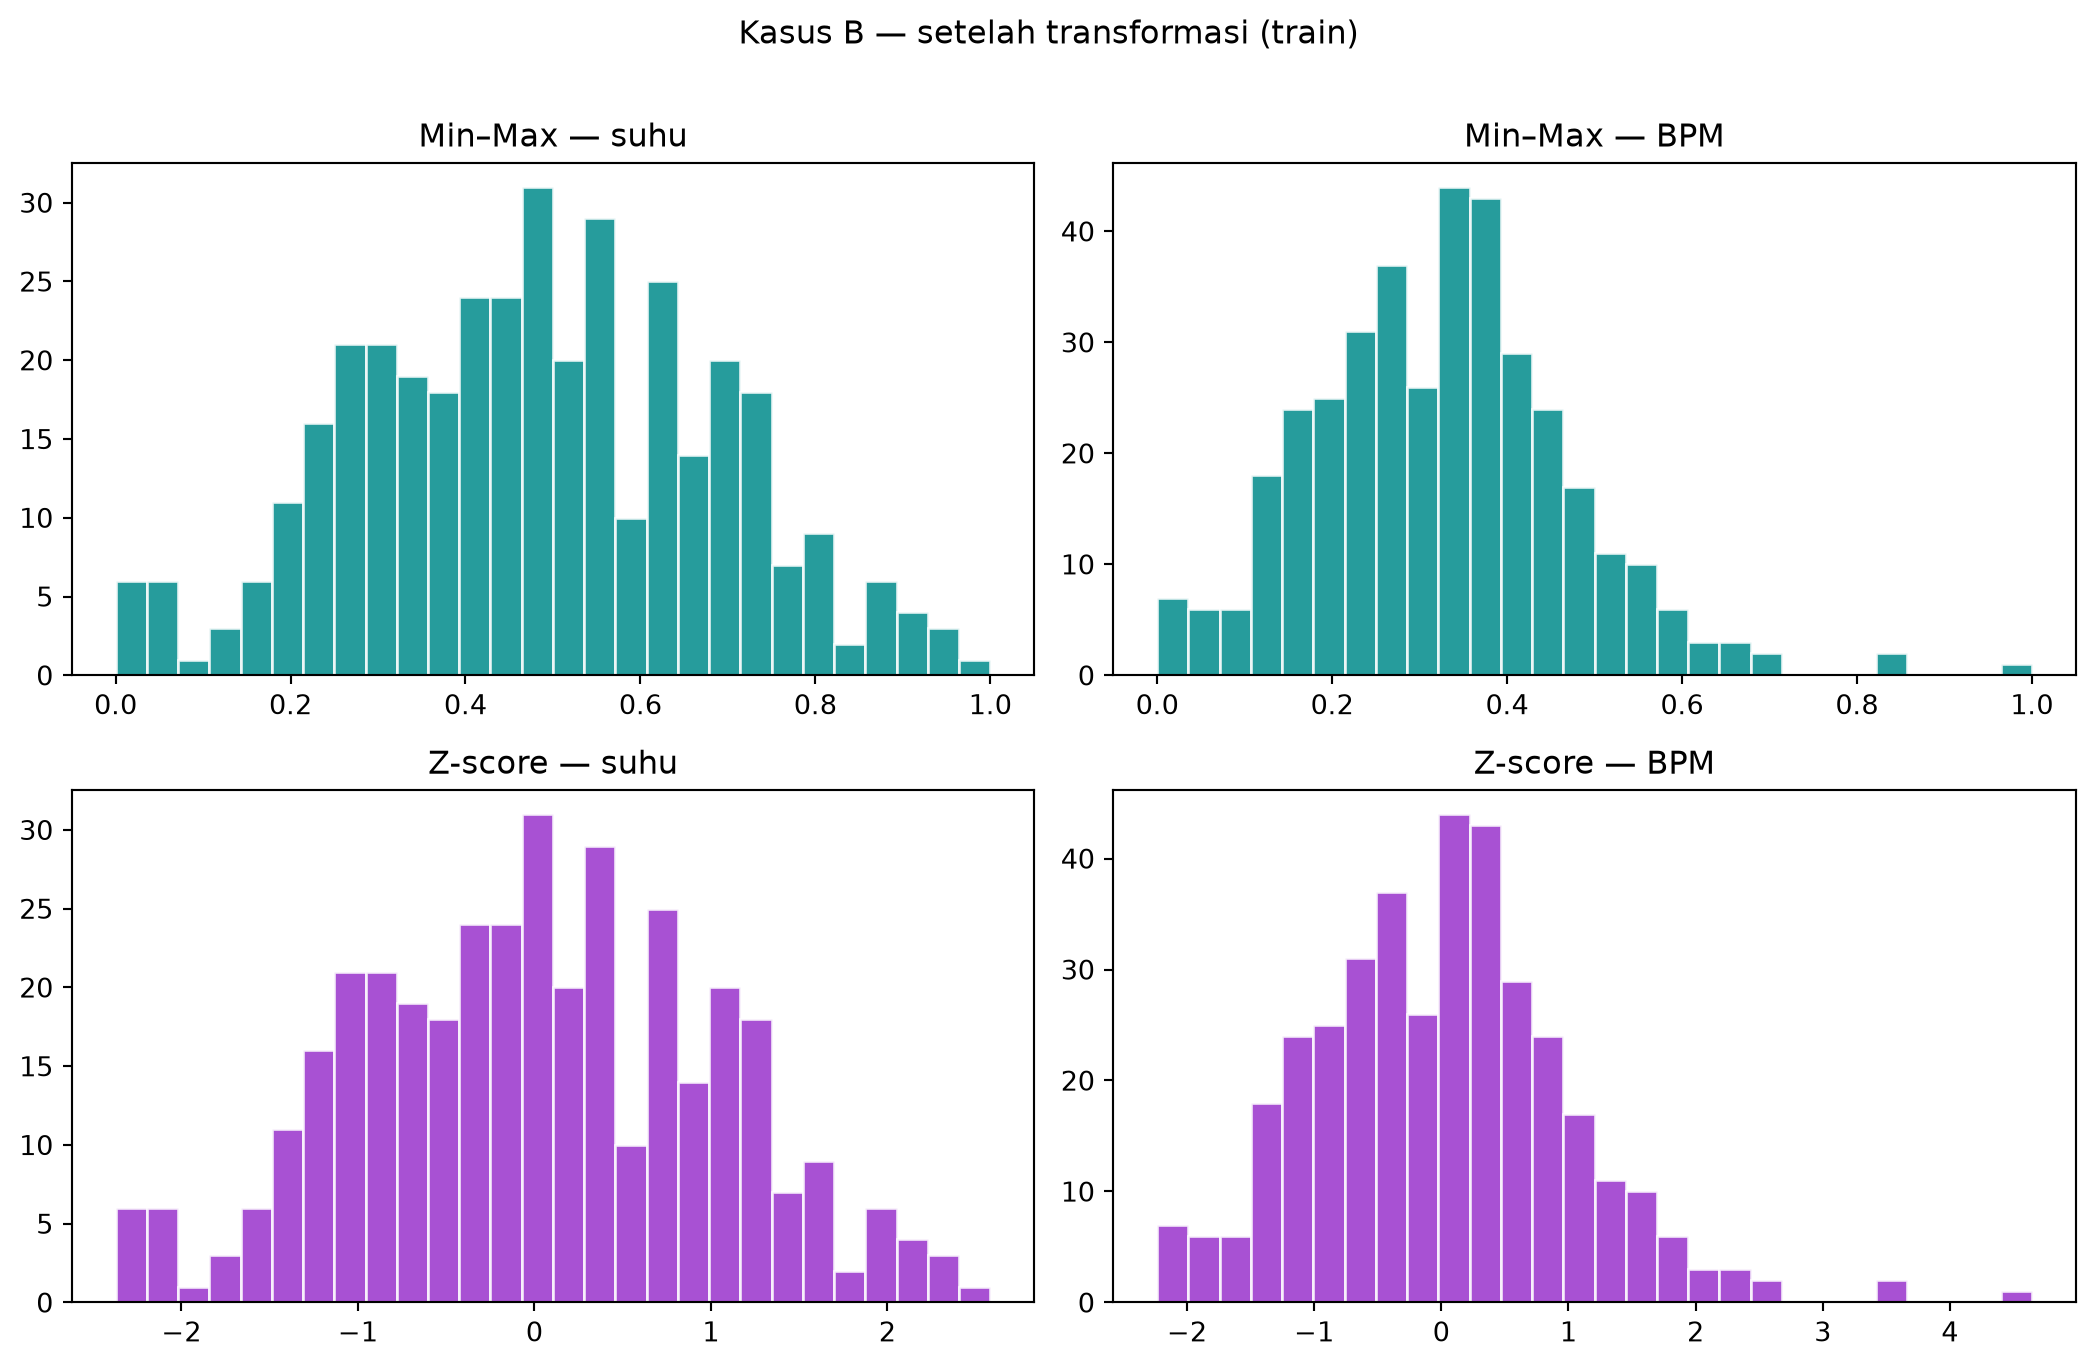
Kasus B — penjelasan grafik (setelah transformasi)
Baris atas (Min–Max): suhu dan BPM sama-sama dipetakan ke \([0,1]\) memakai min/max train. Lonjakan BPM memperlebar rentang sehingga sebagian besar denyut “normal” bisa terlihat mencekik ke kiri — pola yang mirip promosi ekstrem di Kasus A.
Baris bawah (Z-score): kedua variabel berpusat di 0; lonjakan BPM muncul sebagai ekor di kanan, tanpa memaksa seluruh massa data masuk ke satu ujung bin seperti efek samping keras Min–Max pada outlier.
Memilih metode (ringkas):
- Min–Max — bila Anda butuh batas keras (mis. input jaringan yang mengharapkan \([0,1]\)) atau interpretasi “posisi dalam rentang aman operasi”.
- Z-score — bila Anda ingin pusat 0 dan bahasa “berapa \(\sigma\) dari rata-rata”, sering lebih wajar untuk perbandingan antar fitur ketika ada pencilan.
- Untuk k-NN / SVM / regresi terregularisasi, setelah salah satu penskalaan ini kedua fitur menyumbang magnitude sebanding di rumus jarak/penalti — berbeda dengan data mentah.
Data leakage — apa yang dimaksud?
Data leakage (kebocoran informasi) terjadi ketika model—secara tidak adil—mendapat petunjuk yang seharusnya tidak ada pada saat prediksi di dunia nyata. Akibatnya:
- Metrik di set uji atau validasi silang menjadi terlalu tinggi (“model tampak jenius”).
- Setelah deploy, performa jatuh karena sinyal itu hilang atau tidak tersedia pada waktu inferensi.
Leakage bisa masuk lewat pra-pemrosesan (penskalaan, imputasi), desain fitur, atau urutan waktu data—bukan hanya “sengaja memasukkan kolom label”.
Data leakage pada penskalaan & imputasi
Prinsip: setiap parameter yang “dipelajari” dari data—\(\min\), \(\max\), mean, std, median, IQR untuk scaler; mean/median untuk imputasi; kategori modus—harus dihitung dari data latih saja, lalu diterapkan ke validasi/uji/produksi dengan rumus yang sama.
Anti-pola klasik: memanggil fit pada seluruh matriks fitur (train + test) sebelum train_test_split, atau menghitung statistik imputasi dari gabungan train dan test.
Mengapa ini leakage? Baris uji ikut menentukan skala dan nilai pengganti; model secara tidak langsung “mencium” distribusi gabungan yang mengandung informasi dari wilayah yang seharusnya hanya dipakai untuk evaluasi.
Solusi praktis: rangkai imputer + scaler + estimator dalam Pipeline (scikit-learn) atau setara; fit hanya pada train, transform/predict pada test tanpa mengubah parameter dari test.
Contoh 1 — leakage dari penskalaan (Z-score)
Skenario: Anda memisahkan train/test 80/20, tetapi StandardScaler di-fit pada seluruh X (train dan test digabung).
Konsekuensi: mean dan std yang dipakai untuk menormalisasi train sudah terkontaminasi oleh nilai-nilai di test. Model linear atau k-NN pada train memakai representasi yang bergantung pada keberadaan baris uji—padahal di produksi baris uji itu tidak ada saat Anda melatih ulang hanya pada data historis.
Perbaikan: scaler.fit(X_train) lalu scaler.transform(X_test) — atau Pipeline yang memanggil fit hanya pada fold latih saat CV.
Contoh 2 — leakage dari imputasi global
Skenario: Kolom pendapatan punya missing; Anda mengisi mean pendapatan dihitung dari seluruh dataset (termasuk baris test).
Konsekuensi: Nilai imputasi untuk baris train membawa informasi tentang level pendapatan di baris test (melalui mean global). CV akan menaikkan skor secara artifisial.
Perbaikan: hitung mean (atau median per grup) hanya dari nilai terisi pada baris train (X_train untuk kolom itu)—secara operasional: split dulu, baru fit imputer pada train lalu transform train dan test.
Contoh 3 — leakage fitur: “yang baru ada setelah kejadian”
Skenario churn: Memprediksi apakah pelanggan akan churn di bulan berikutnya.
- Salah: memasukkan
total_diskon_diberikan_csyang diisi setelah tim retensi menghubungi pelanggan (nilai itu disebabkan oleh upaya retensi, bukan prediktor murni sebelum keputusan). - Salah:
jumlah_tiket_komplain_terselesaikanpada tanggal prediksi jika tiket itu terbuka karena churn sudah terjadi.
Benar: fitur harus terdefinisi pada tanggal potong prediksi (hanya data yang sudah pasti ada sebelum keputusan bisnis).
Contoh 4 — leakage temporal & agregasi
Skenario: Memprediksi penjualan toko untuk Januari 2025 memakai fitur total_penjualan_2024 yang dihitung pada 31 Des 2024—itu boleh jika definisi prediksi adalah “pada awal Jan kita hanya tahu angka tahun lalu”. Tetapi jika Anda tanpa sengaja memasukkan penjualan Jan–Mar 2025 ke fitur agregat “tahun berjalan”, itu future leakage.
Skenario lain: point-in-time join—fitur “saldo rata-rata nasabah” digabungkan tanpa memastikan saldo itu dari snapshot tanggal yang sama dengan permohonan kredit.
Perbaikan: time-based split; fitur agregat hanya memakai jendela waktu \(\leq\) tanggal event yang diprediksi.
Contoh 5 — target encoding naif
Skenario: Untuk kolom kota, Anda mengganti tiap kota dengan mean label y dihitung dari seluruh data (train + test).
Konsekuensi: Encoding kota untuk baris train memuat informasi tentang label di baris test (melalui mean global per kota).
Perbaikan: hitung mean label hanya dari train, atau gunakan CV dalam train (out-of-fold encoding) agar tiap baris tidak melihat label baris lain di fold yang sama.
Ringkas — cek sebelum melatih
- Split train/validasi/test sebelum fit apa pun yang memakai statistik dari banyak baris.
- Gunakan
Pipelineagar tidak ada langkah manual yang salah urut.
- Tulis definisi waktu fitur: “nilai ini tersedia pada tanggal \(T\) untuk prediksi apa?”
- Curigai kolom yang korrelasi sempurna dengan target di EDA—sering tanda label atau post-outcome ikut terbawa.
Transformasi nonlinear — ide dasar
Transformasi nonlinear memetakan nilai \(x\) ke \(g(x)\) dengan fungsi \(g\) bukan garis lurus (bukan hanya “kalikan konstanta lalu tambah konstanta” seperti penskalaan affine).
Mengapa dipakai?
- Banyak variabel bisnis menceng ke kanan (positive skew): pendapatan, harga rumah, durasi sesi, jumlah klik. Nilai ekstrem menarik mean dan merusak asumsi “kesalahan mendekati simetris” pada beberapa model.
- \(g(x)\) memadatkan rentang besar dan meregangkan rentang kecil sehingga pola di bagian “badan” distribusi lebih mudah dipelajari—dengan trade-off: interpretasi koefisien berubah ke skala hasil transformasi.
Aturan praktik: parameter \(g\) (mis. \(\lambda\) Box–Cox) di-fit dari train saja; terapkan ke validasi/uji dengan fungsi yang sama. Gabungkan dengan Pipeline agar tidak leakage.
Contoh — log, log1p, dan log natural
| Transformasi | Rumus (intuisi) | Contoh pemakaian |
|---|---|---|
| \(\ln(x)\) | Log natural; hanya untuk \(x > 0\) | Pendapatan, harga setelah memastikan tidak ada nol |
log1p(x) |
\(\ln(1+x)\); aman untuk \(x \geq 0\) | Hitungan, durasi, revenue ketika nol bermakna (“tidak ada event”) |
log10(x) |
Log basis 10 | EDA; poros grafik per dekade |
Contoh nyata: omzet harian toko (banyak hari kecil, sedikit hari “harbolnas”); log1p pada omzet menekan ekor kanan sehingga regresi linear residual lebih stabil. Interpretasi: “naik 0,1 pada skala log” ≈ perubahan persentase multiplikatif, bukan “tambah Rp seribu” literal.
Contoh — akar, kuadrat, dan reciprocal
| Transformasi | Domain | Contoh pemakaian |
|---|---|---|
| \(\sqrt{x}\) | \(x \geq 0\) | Area tanah, jumlah penduduk wilayah—menceng tapi tidak se-ekstrem log |
| \(x^2\) | bebas | Jarang untuk “memperbaiki” skew; kadang untuk interaksi fisik yang kuadratik |
| \(1/x\) | \(x \neq 0\) | “Waktu per unit pekerjaan”, intensitas; hati-hati nilai nol → NaN atau offset |
Catatan: akar dan log monoton naik—urutan nilai asli tetap; yang berubah jarak antar titik di sepanjang sumbu, cocok untuk model yang sensitif terhadap pencilan di skala asli.
Contoh — Box–Cox & Yeo–Johnson (keluarga berparameter)
- Box–Cox: memilih parameter \(\lambda\) agar data mendekati normalitas (biasanya \(x > 0\)). Contoh: batch produksi yang harus positif.
- Yeo–Johnson: generalisasi yang mengakomodasi nilai nol atau negatif (mis. selisih suhu, profit/loss). Cocok ketika Anda tidak ingin memaksa winsor dulu hanya untuk memenuhi syarat Box–Cox.
Di sklearn: PowerTransformer(method="box-cox") atau "yeo-johnson" — selalu fit pada train, transform pada test.
Transformasi nonlinear — kapan tidak memaksa log?
- Nilai nol atau negatif bermakna → hindari \(\ln(x)\) mentah; pertimbangkan Yeo–Johnson, offset (
log(x + c)), atau binning. - Persentase atau proporsi di \([0,1]\) → kadang logit \(\ln(p/(1-p))\) dengan penyesuaian ujung; atau biarkan model pohon menangani.
- Variabel sudah hampir normal → transformasi tambahan bisa noise tanpa manfaat—ukur dengan validasi silang.
Ilustrasi: distribusi mentah vs setelah log1p
import matplotlib.pyplot as plt
import numpy as np

rng = np.random.default_rng(21)
# Meniru variabel bisnis: banyak nilai kecil, ekor kanan panjang
x = rng.lognormal(2.2, 1.05, size=2800)
x = np.clip(x, 0, None)
y = np.log1p(x)

fig, axes = plt.subplots(1, 2, figsize=(10, 3.8))
axes[0].hist(x, bins=56, color="steelblue", edgecolor="white", alpha=0.92)
axes[0].set_title("Mentah (contoh skew positif)")
axes[0].set_xlabel("nilai asli")
axes[1].hist(y, bins=48, color="darkorange", edgecolor="white", alpha=0.92)
axes[1].set_title("Setelah log1p(x)")
axes[1].set_xlabel("log1p(x)")
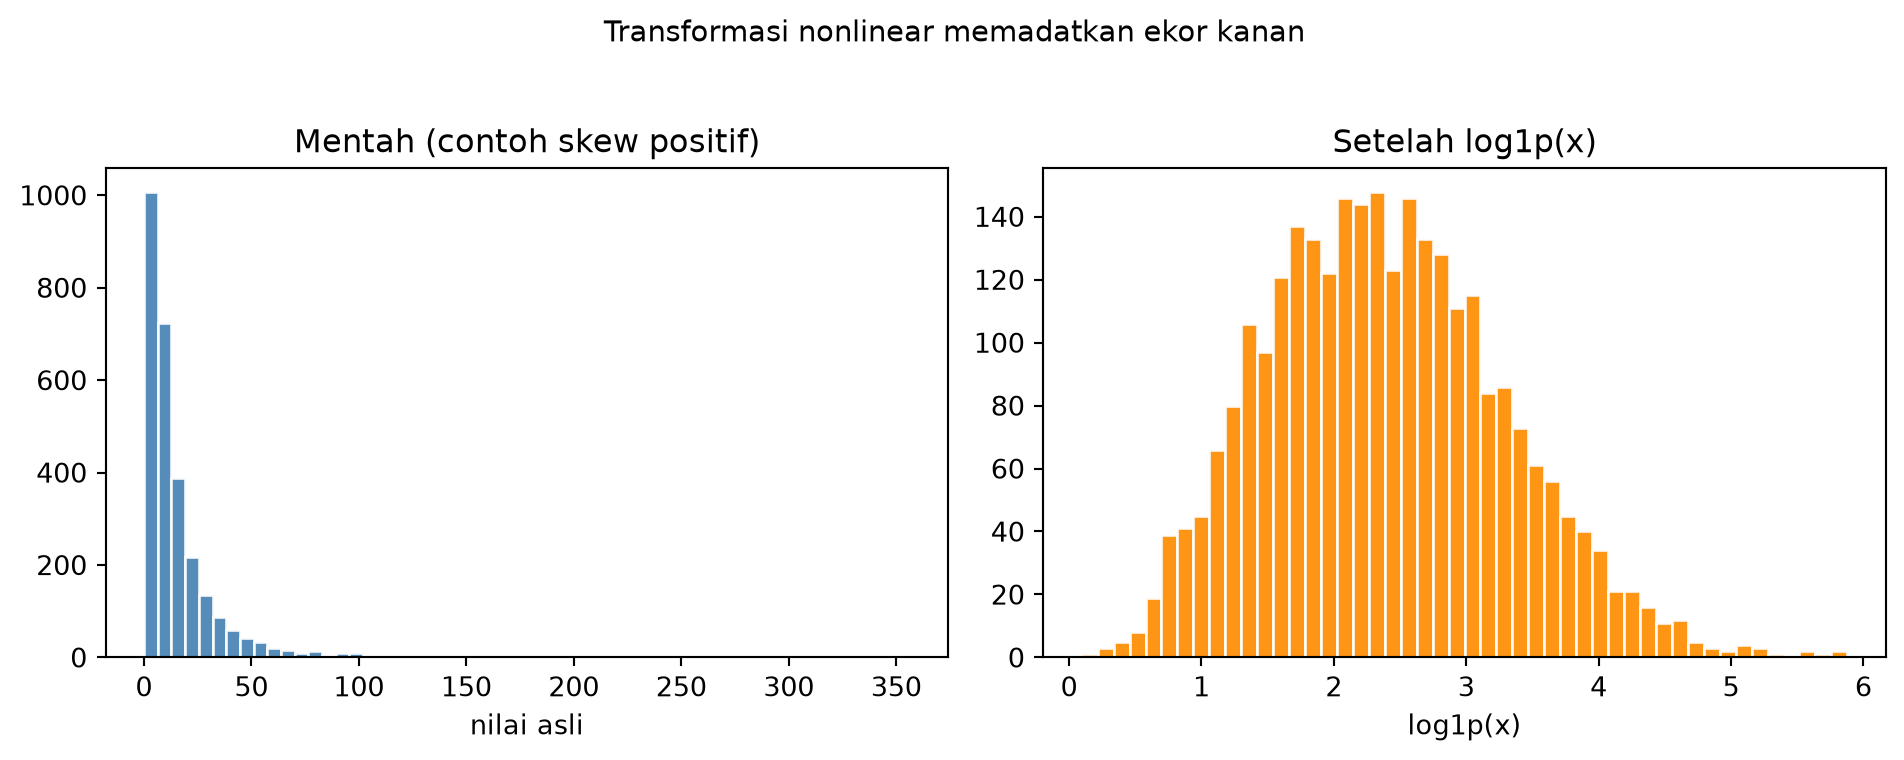
fig.suptitle("Transformasi nonlinear memadatkan ekor kanan", fontsize=11, y=1.03)
plt.tight_layout()
Baca grafik: histogram kiri menceng ke kanan; setelah log1p, bentuk lebih simetris (mendekati “gentong”) sehingga banyak model yang mengasumsikan error lebih stabil di sekitar pusat data berperilaku lebih baik.
Ilustrasi: distribusi mentah vs setelah log1p
Encoding sebagai bagian transformasi
Encoding = mengubah variabel kategorik atau teks menjadi angka atau vektor yang algoritme bisa hitung (jarak, dot product, split pohon).
| Jenis | Kapan | Perhatian |
|---|---|---|
| One-hot / dummy | Kategori nominal (tidak ada urutan) | Kolom bertambah; multikolinearitas jika semua level + intercept |
| Ordinal (integer terurut) | Urutan jelas (pendidikan, tingkat risiko) | Jarak antar angka mengasumsikan “setengah antara SMA dan S1” — cek domain |
| Label encoding | Angka 0..K-1 per kategori | Untuk pohon sering OK; untuk jarak/SVM salah (urutan palsu) |
| Target encoding | Kategori tinggi kardinalitas | Leakage jika mean label dihitung dari test |
Contoh — one-hot (dummy) untuk nominal
Data mentah (satu kolom metode_bayar):
| id | metode_bayar |
|---|---|
| 1 | QRIS |
| 2 | Tunai |
| 3 | QRIS |
Setelah one-hot (tiap level jadi kolom biner 0/1):
| id | bayar_QRIS | bayar_Tunai | bayar_Kartu |
|---|---|---|---|
| 1 | 1 | 0 | 0 |
| 2 | 0 | 1 | 0 |
| 3 | 1 | 0 | 0 |
Varian drop-first: menghapus satu kolom (mis. bayar_Kartu) agar tidak redundan dengan intercept pada regresi linear — pilih konsisten di train dan produksi.
Di Pandas: pd.get_dummies(..., drop_first=True); di sklearn: OneHotEncoder(drop="first") dalam ColumnTransformer / Pipeline.
Contoh — ordinal: pendidikan & tingkat risiko
Pendidikan — urutan disepakati organisasi:
| Nilai asli | pendidikan_ord |
|---|---|
| SMA | 1 |
| D3 | 2 |
| S1 | 3 |
| S2 | 4 |
| S3 | 5 |
Risiko kredit (contoh domain):
| Kelas | skor_risiko |
|---|---|
| rendah | 1 |
| sedang | 2 |
| tinggi | 3 |
Model linear menginterpretasikan selisih \(3-2\) sama “besar” dengan \(2-1\); jika tidak masuk akal, gunakan dummy per kelas atau monotonic constraint (topik lanjutan).
Contoh — label encoding vs one-hot (linear vs pohon)
Label encoding (satu kolom: kota → 0,1,2,…): pohon keputusan hanya mencari ambang; urutan integer tidak dipakai sebagai “jarak”, sehingga sering diterima.
Regresi / k-NN / SVM: angka 0,1,2 menyiratkan jarak antara kota — itu salah semantik; gunakan one-hot atau embedding / target encoding dengan CV.
Contoh — target encoding (intuisi + risiko)
Ide: untuk kategori provinsi dengan ribuan level, ganti string dengan rata-rata label churn per provinsi di train.
Salah: mean dihitung dari train+test → leakage (sudah dibahas di slide data leakage).
Benar: mean hanya train, atau out-of-fold dalam CV sehingga tiap baris tidak melihat label dirinya sendiri saat encoding.
Ilustrasi encoding dengan Pandas
import pandas as pd

df = pd.DataFrame(
    {
        "kota": ["Bandung", "Jakarta", "Bandung", "Surabaya", "Jakarta"],
        "pendidikan": ["S1", "SMA", "S3", "S1", "D3"],
    }
)
ord_map = {"SMA": 1, "D3": 2, "S1": 3, "S3": 4}
dummy_kota = pd.get_dummies(df["kota"], prefix="kota")
hasil = pd.concat([df, dummy_kota], axis=1)
hasil["pendidikan_ord"] = df["pendidikan"].map(ord_map)
hasil
Baca tabel: kolom kota_* adalah one-hot; pendidikan_ord adalah ordinal terpisah. Di produksi, simpan daftar kategori yang pernah muncul di train; kategori baru di test → ke bucket UNKNOWN atau kebijakan bisnis.
Ilustrasi encoding dengan Pandas
| kota | pendidikan | kota_Bandung | kota_Jakarta | kota_Surabaya | pendidikan_ord | |
|---|---|---|---|---|---|---|
| 0 | Bandung | S1 | True | False | False | 3 |
| 1 | Jakarta | SMA | False | True | False | 1 |
| 2 | Bandung | S3 | True | False | False | 4 |
| 3 | Surabaya | S1 | False | False | True | 3 |
| 4 | Jakarta | D3 | False | True | False | 2 |
Rekayasa fitur — definisi & ruang lingkup
Rekayasa fitur (feature engineering) adalah merancang variabel input (kolom baru, agregasi, penyederhanaan, atau penyaringan kolom) agar algoritme pembelajaran atau analisis statistik lebih mudah menemukan sinyal yang selaras dengan pertanyaan analitik atau keputusan bisnis.
Ruang lingkupnya meliputi: ekstraksi dari data mentah, transformasi (log, binning, encoding), agregasi antar tabel/waktu, interaksi antar variabel, serta pemilihan fitur (feature selection) ketika dilakukan secara eksplisit sebagai desain, bukan hanya sebagai hyperparameter otomatis.
Rekayasa fitur — mengapa data mentah sering “kurang pas”?
- Satuan & skala berbeda antar kolom; beberapa pola lebih terbaca setelah rasio atau log.
- Informasi relevan tersebar di banyak baris (log transaksi) — perlu agregat per entitas (pelanggan, akun).
- Nonlinearitas & ambang domain (“diskon besar dan tenure pendek”) lebih mudah ditangkap dengan interaksi atau binning daripada satu fitur mentah.
- Kategori tinggi kardinalitas (ID cabang, SKU) perlu encoding atau agregasi agar tidak meledakkan dimensi atau overfit.
Rekayasa fitur menjawab: “Dalam bentuk apa sebaiknya pola itu dimasukkan ke model?” — bukan hanya “berapa banyak kolom?”.
Rekayasa fitur — empat jalur kerja (ringkas)
| Jalur | Apa yang dilakukan | Contoh |
|---|---|---|
| Ekstraksi dari satu sumber | Turunkan fitur dari kolom/tabel yang sudah ada | Dari timestamp → hari kerja; dari alamat → provinsi |
| Agregasi & jendela waktu | Ringkas banyak rekaman jadi satu vektor per kunci | Jumlah transaksi 30 hari; recency hari sejak order terakhir |
| Transformasi & encoding | Ubah skala atau bentuk representasi kategorik | log1p(omzet); one-hot metode_bayar |
| Interaksi & domain rule | Gabungkan sinyal sesuai pengetahuan bisnis | batas_kredit / pendapatan; is_weekend * promo_flag |
Keempatnya bisa bertumpuk pada satu proyek; urutan ideal biasanya: definisi → validasi → agregasi/integrasi → transformasi → (latih) pemilihan fitur.
Rekayasa fitur — syarat “bisa dipakai di produksi”
- Definisi operasional tertulis — rumus atau pseudokode: “
omzet_30d= jumlahnilaiuntukid_tokodalam 30 hari kalender sebelumT”.
- Kesetaraan train / inferensi — fitur yang sama dihitung dengan aturan waktu dan kunci yang identik saat batch maupun online.
- Penanganan kategori dingin — nilai kategori baru setelah deploy →
UNKNOWN, modus bisnis, atau fallback terdokumentasi.
- Versi & jejak — versi skrip/pemanggil fitur + hash data masukan agar regresi perilaku bisa dilacak.
Tanpa ini, model “bagus di notebook” sering gagal karena definisi fitur di produksi menyimpang sedikit.
Rekayasa fitur — pengetahuan domain vs otomatis
- Domain (manual / bersama SME): aturan bisnis, ambang regulasi, definisi churn, pemilihan jendela 30 vs 90 hari — sering paling berpengaruh pada kualitas sinyal.
- Otomatis (AutoFeat, polinomial, feature tools): memperluas ruang pencarian; risiko overfitting dan fitur sulit dijelaskan ke regulator atau klien.
- Praktik campuran: mulai dari fitur berinterpretasi; tambahkan otomatis secara terbatas dan validasi silang ketat.
Rekayasa fitur — trade-off yang sering dilupakan
| Isu | Risiko | Mitigasi |
|---|---|---|
| Terlalu banyak fitur | Overfit, waktu latih naik | Regularisasi, seleksi, batasi agregasi bermakna |
| Kardinalitas tinggi | Sparse, noise | Target encoding hati-hati, hashing, grup “lainnya” |
| Data tipis per grup | Mean agregat tidak stabil | Shrinkage ke mean global, minimal n per grup |
| Interpretasi | Stakeholder tidak percaya | Dokumentasi + subset fitur untuk laporan vs model |
Ekstraksi fitur — dari satu sumber
Ekstraksi = menurunkan kolom baru dari satu tabel / satu aliran tanpa menggabungkan entitas lain (integrasi ada di slide berikutnya).
| Sumber kolom | Contoh fitur turunan |
|---|---|
| Waktu | tahun, bulan, is_weekend, jam sibuk, kuartal fiskal |
| Teks pendek | panjang karakter, jumlah kata, ada/tidak kata kunci (“refund”, “urgent”) |
| Geospasial | provinsi dari kode pos, jarak ke gudang terdekat (jika koordinat ada) |
| Numerik mentah | diskon / harga, clip ke rentang operasi, binning kuantil |
| Event per baris | urutan ke-k dalam sesi (jika diurutkan), lag satu langkah dalam grup |
Prinsip: untuk setiap baris di waktu \(T\) prediksi, nilai fitur hanya boleh memakai informasi yang sudah diketahui pada \(T\) (point-in-time konsisten).
Ekstraksi fitur — interaksi, rasio, & binning
| Teknik | Contoh | Catatan |
|---|---|---|
| Rasio | pendapatan_per_anggota, CTR = klik / tayangan, utilisasi = saldo_terpakai / plafon |
Hindari pembagian nol (+ ε atau NaN + flag) |
| Interaksi | usia_pensiun - usia, tenure_bulan * segmentasi_premium |
Gunakan jika domain menduga efek gabungan, bukan sembarang kalikan semua pasangan |
| Binning | omzet ke Q1..Q4, usia ke kelompok risiko |
Mengurangi overfit ke noise; kehilangan resolusi; batas bin dari train atau aturan tetap |
| Piecewise | indikator pendapatan > ambang_pajak |
Ambang dari regulasi → stabil lintas sampel |
Interaksi vs pohon: pohon bisa mempelajari interaksi implisit; tetap eksplisitkan jika interpretasi atau model linear membutuhkannya.
Pelabelan data — sumber label
| Sumber | Karakteristik |
|---|---|
| Aturan / heuristik | Murah, bisa bias sistematis (weak supervision) |
| Annotator manusia | Mahal, perlu panduan & inter-rater reliability |
| Perilaku implisit | Klik, retensi — label “berisik”, perlu definisi event |
| Outcomes tertunda | churn setelah 90 hari — label baru muncul lambat |
Noise label: model mempelajari kesalahan annotator; mitigasi: kualitas panduan, voting, audit sampel.
Pelabelan & evaluasi
- Pisahkan definisi label dari fitur prediktor — hindari fitur yang hanya ada setelah label terjadi (leakage).
- Untuk ketidakseimbangan kelas: metrik selain akurasi (F1, PR-AUC) dan strategi sampling — topik lanjutan, tetapi kenali dampak label jarang.
Integrasi dataset (data integration)
Tujuan: menyatukan entitas yang sama atau konteks yang saling melengkapi dari beberapa tabel / berkas / API.
Langkah tipikal:
- Identifikasi kunci —
id_pelanggan,(tanggal, cabang), hash produk. - Pilih jenis gabungan —
innervsleftvsouter(Pandasmerge). - Selesaikan konflik — dua sumber punya
namaberbeda: prioritas sumber, timestamp terbaru, atau aturan bisnis. - Deduplikasi setelah merge jika kunci tidak unik di salah satu sisi.
Integrasi temporal & snapshot
- Point-in-time join: fitur hanya boleh memakai data yang sudah tersedia pada tanggal prediksi (mencegah future leakage).
- Slowly changing dimensions (SCD): alamat pelanggan berubah — pilih versi yang valid pada tanggal transaksi.
Ringkasan praktik
- Validasi dulu (skema + aturan domain) → laporkan FAIL.
- Penskalaan / transformasi dipilih berdasarkan distribusi, outlier, dan algoritme.
- Parameter di-fit pada train; gunakan pipeline.
- Fitur baru harus punya definisi operasional; label harus punya protokol.
- Integrasi = kunci + aturan konflik + dokumentasi
Nbaris sebelum/sesudah.
Contoh mini: penskalaan & fitur rasio
import numpy as np
import pandas as pd

rng = np.random.default_rng(42)
n = 400
df = pd.DataFrame(
    {
        "pendapatan": rng.lognormal(10, 0.6, size=n),
        "pengeluaran": rng.lognormal(9.5, 0.7, size=n),
        "kota": rng.choice(["A", "B", "C"], size=n, p=[0.5, 0.35, 0.15]),
    }
)
df["rasio"] = df["pengeluaran"] / (df["pendapatan"] + 1e-6)

ix = rng.permutation(df.index.to_numpy())
cut = int(0.75 * len(ix))
train = df.loc[ix[:cut]]
test = df.loc[ix[cut:]]

cols = ["pendapatan", "pengeluaran", "rasio"]
mu = train[cols].mean()
std = train[cols].std(ddof=0).replace(0, np.nan).fillna(1.0)
# setara ide StandardScaler: parameter hanya dari train
test_z = (test[cols] - mu) / std
test_z.head(4)
rasio adalah contoh rekayasa fitur sederhana; mean dan std dipelajari hanya dari baris latih — pola yang sama diterapkan oleh StandardScaler di scikit-learn dalam Pipeline.
Contoh mini: penskalaan & fitur rasio
| pendapatan | pengeluaran | rasio | |
|---|---|---|---|
| 89 | 0.176300 | 0.439803 | -0.138321 |
| 337 | 0.045051 | 0.625877 | 0.028218 |
| 217 | 1.372360 | -0.019341 | -0.615857 |
| 249 | -0.875232 | -0.494520 | 0.082169 |
Referensi singkat (baca lanjut)
- Hastie, Tibshirani, Friedman — Elements of Statistical Learning (transformasi & regularisasi).
- Dokumentasi scikit-learn: Preprocessing, Pipelines, ColumnTransformer.
- Kimball / Inmon (ringkas) — pola integrasi data warehouse & conformed dimensions.
Pertanyaan refleksi
- Fitur mana di domain Anda yang paling rawan outlier sehingga RobustScaler lebih masuk akal daripada
StandardScaler? - Jika dua departemen menjaga spreadsheet berbeda dengan ID pelanggan tidak seragam, langkah validasi apa sebelum merge?
MK Data Science 07 - Anggit Wirasto