import numpy as np
import pandas as pd

rng = np.random.default_rng(7)
n = 120
df = pd.DataFrame(
    {
        "id": range(1, n + 1),
        "usia": rng.integers(22, 60, size=n),
        "pendapatan": rng.normal(8.0, 2.5, size=n),
        "kota": rng.choice(["X", "Y", "Z"], size=n, p=[0.45, 0.35, 0.2]),
    }
)
# sisipkan missing dan outlier sintetis
miss_idx = rng.choice(df.index, size=18, replace=False)
df.loc[miss_idx, "pendapatan"] = np.nan
df.loc[rng.choice(df.index, size=3, replace=False), "pendapatan"] = 45.0

df.head(8)Pemilihan Objek Data & Pembersihan Data
Data Science — pertemuan ke-6
Anggit Wirasto, S.Si., M.Eng.
Tujuan pembelajaran
Setelah materi ini, mahasiswa diharapkan mampu:
- Menjelaskan pemilihan objek data (baris/rekaman dan kolom/atribut) yang selaras dengan pertanyaan analitik dan batas domain.
- Menerapkan pembersihan data: mendeteksi nilai kosong, memilih strategi penanganan yang wajar, dan mendeteksi data pencilan (outlier).
- Mengimplementasikan langkah-langkah dasar di Pandas untuk dataset tabular.
Mengapa pemilihan & pembersihan?
- Data mentah sering berlebihan (kolom tidak dipakai), berisik (salah ketik, outlier), atau tidak lengkap (missing).
- Kualitas input menentukan kualitas analisis dan model: garbage in, garbage out.
- Tahap ini termasuk pra-pemrosesan yang menjembatani pengumpulan data dan EDA/pemodelan.
Objek data: rekaman vs atribut
| Istilah | Arti umum | Contoh |
|---|---|---|
| Rekaman / baris | Satu observasi (satu entitas pada satu konteks) | Satu transaksi, satu pasien satu kunjungan |
| Atribut / kolom | Variabel yang diukur atau dicatat | Harga, tanggal, kategori produk |
Memilah = memutuskan baris mana yang masuk analisis dan kolom mana yang dipakai sebagai fitur, target, atau metadata.
Memilih rekaman (baris) yang relevan
- Filter berdasarkan periode waktu — analisis Q1 saja, data setelah migrasi sistem, dll.
- Filter populasi — hanya pelanggan aktif, hanya wilayah tertentu, jika soal bisnisnya memang begitu.
- Kualitas baris — duplikat, baris hampir kosong, atau rekaman yang jelas salah input (bisa dibuang atau dikoreksi).
Prinsip: setiap keputusan membuang atau membatasi baris harus bisa dijelaskan ke pemangku kepentingan (reproduksibilitas laporan).
Memilih atribut (kolom) yang relevan
- Selaraskan dengan tujuan — prediksi churn butuh perilaku & kontrak; foto profil mungkin tidak relevan untuk model tabular.
- Hindari kebocoran label (data leakage) — kolom yang hanya ada setelah kejadian yang diprediksi tidak boleh jadi fitur.
- Redundansi — dua kolom hampir identik (salinan) bisa disederhanakan agar interpretasi lebih jelas.
- Privasi & kebijakan — atribut sensitif dipetakan ke kebutuhan minimum (data minimization).
Deduplikasi baris (ringkas)
Duplikat bisa mengacaukan agregasi dan latihan model (bobot observasi dobel).
- Identifikasi:
duplicated()pada kunci bisnis atau pada seluruh baris. - Tindakan:
drop_duplicates()dengan subset kolom yang memang mendefinisikan “satu kejadian unik”.
Ringkasan pemilihan objek data
- Tulis pertanyaan analitik (atau definisi target) secara eksplisit.
- Definisikan populasi dan rentang waktu yang valid.
- Pilih kolom fitur/target/metadata; dokumentasikan yang dibuang dan alasannya.
- Periksa duplikat dan konsistensi kunci.
Nilai kosong (missing values)
Missing = nilai yang tidak tersedia: NaN, sel kosong, placeholder (“-”, “N/A”, 999), atau NULL di basis data.
Mengapa penting: banyak algoritme membutuhkan matriks lengkap; keputusan imputasi memengaruhi distribusi dan kesimpulan.
Pola missing — mengapa dipelajari?
Pola missing menjelaskan mengapa suatu nilai bisa kosong. Hal ini memengaruhi apakah menghapus baris mendistorsi populasi, dan apakah imputasi sederhana (mean/median) masuk akal secara statistik.
Tiga pola klasik: MCAR, MAR, MNAR (istilah dari Little & Rubin). Di lapangan, pola sering campuran dan sulit dibuktikan; tetap berguna sebagai kerangka berpikir dan untuk transparansi laporan.
MCAR — Missing Completely At Random
Definisi (intuisi): peluang suatu sel kosong tidak bergantung pada nilai variabel manapun — baik yang terlihat maupun yang seharusnya ada di sel yang kosong. Seperti “undi acak” sel mana yang hilang.
Contoh:
- Beberapa kuesioner rusak di pos secara acak (~5%), tanpa pola tertentu menurut usia atau pendapatan.
- Gagal teknis sensor: 1% pengukuran tidak terekam karena noise perangkat, tidak berkaitan dengan suhu sebenarnya.
- Subsample acak untuk uji lab: 10% sampel tidak diuji karena kapasitas (proses random), bukan karena kadar zatnya tinggi/rendah.
Implikasi: listwise deletion (buang baris yang ada missing) kurang bias dibanding pola lain — asalkan MCAR benar-benar reasonable. Tetap rugi power (sampel mengecil).
MAR — Missing At Random
Definisi (intuisi): setelah kita tahu variabel yang terobservasi, peluang missing tidak lagi bergantung pada nilai yang seharusnya ada di sel yang kosong. Missing “dijelaskan” oleh variabel lain di data.
Contoh:
- Pendapatan sering kosong pada kelompok usia tertentu atau jenis pekerjaan — tapi di dalam satu kelompok usia/kerja, siapa yang mengisi dan tidak seperti acak.
- Pengukuran darah lanjutan hanya untuk pasien yang sudah terlihat abnormal pada tes pertama — missing pada tes lanjutan bergantung pada hasil tes pertama (terobservasi).
- Survei online: responden dari wilayah A lebih malas mengisi pertanyaan opsional; wilayah terlihat di data → missing bergantung pada wilayah (terobservasi).
Implikasi: imputasi yang memakai variabel lain (mis. regresi, KNN, multiple imputation) lebih masuk akal daripada mean global sembarangan — karena informasi di kolom lain membantu menebak yang kosong.
MNAR — Missing Not At Random
Definisi (intuisi): peluang missing bergantung pada nilai yang tidak kita lihat — biasanya nilai di variabel yang sama yang seharusnya terisi. Pola paling sulit: data yang hilang sendiri membawa informasi tentang besaran yang tidak terukur.
Contoh:
- Orang dengan pendapatan sangat tinggi lebih sering menolak melaporkan pendapatan → yang missing cenderung bukan “acak”, melainkan skew ke kelompok atas.
- Skor ujian rendah — siswa yang malas/malu tidak mengumpulkan lembar → missing pada nilai berkorelasi dengan rendahnya prestasi.
- Kunjungan klinik: pasien yang sembuh cepat tidak datang kontrol → “missing” kunjungan lanjutan berkaitan dengan kondisi (yang tidak sepenuhnya terukur di baris itu).
Implikasi: mean/median dari yang terisi bias (sistematis salah arah). Perlu model khusus (selection models, sensitivity analysis), sumber data tambahan, atau desain ulang pengukuran — sering tidak cukup “isi saja dengan median”.
Ringkasan pola + contoh satu baris
| Pola | Intuisi | Contoh singkat |
|---|---|---|
| MCAR | Kosong seperti undian, tidak berkaitan dengan data | Formulir 3% hilang karena sortir acak |
| MAR | Kosong dijelaskan oleh kolom lain yang ada | Pendapatan kosong lebih banyak di usia muda (usia terisi) |
| MNAR | Kosong berkaitan dengan nilai yang tidak terlihat | Yang tidak lapor pendapatan cenderung pendapatan ekstrem |
Praktik: uji formal MCAR/MAR/MNAR jarang sempurna; dokumentasikan alur bisnis (siapa mengisi, kapan alat gagal) dan lakukan analisis sensitivitas (bandingkan beberapa strategi imputasi/hapus).
Mendeteksi missing di Pandas
df.isna(),df.isnull()(sama untuk objek Pandas), agregasidf.isna().sum()ataumean()untuk proporsi per kolom.df.info()melihatnon-null countvs jumlah baris.- Bedakan sel benar-benar kosong dengan kode sentinel di data mentah:
999,-1,"NA", string kosong""— sering harusreplace(..., np.nan)sebelum analisis.
Tiga arah besar penanganan missing
- Tidak mengisi — menghapus baris/kolom yang bermasalah, atau memakai metode yang mendukung NaN (tergantung algoritme / pustaka).
- Imputasi — mengganti missing dengan nilai “pengganti” (statistik, aturan bisnis, atau prediksi dari variabel lain).
- Model eksplisit terhadap missing — mis. multiple imputation, model seleksi, atau fitur tambah indikator bahwa nilai asli kosong.
Keputusan bergantung pada pola missing (MCAR/MAR/MNAR), proporsi missing, dan tujuan (laporan deskriptif vs pemodelan prediktif).
Menghapus baris (listwise deletion)
Maksud: membuang setiap baris yang punya missing pada satu atau lebih kolom yang Anda butuhkan untuk analisis itu.
Contoh situasi: hanya 2% baris yang punya missing di email, dan Anda yakin tidak ada pola sistematis; target analisis butuh baris lengkap.
Risiko: sampel mengecil; jika missing bukan MCAR, distribusi populasi bisa bias. dropna(subset=[...]) membatasi hanya kolom relevan — lebih baik daripada membuang baris karena missing di kolom yang tidak dipakai.
Varian pairwise: misalnya korelasi Pearson antara A dan B memakai hanya baris di mana A dan B keduanya terisi — tiap pasangan variabel bisa punya N berbeda; perlu dijelaskan di laporan.
Menghapus kolom
Maksud: membuang variabel yang missing-nya terlalu banyak, tidak relevan, atau tidak bisa dipercaya.
Contoh: kolom “catatan bebas” 90% kosong dan tidak dipakai di model tabular; kolom sensor yang gagal total untuk satu cabang.
Risiko: kehilangan informasi jika kolom itu sebenarnya penting (terutama jika missing-nya informatif / MNAR).
Imputasi univariat (satu variabel)
Nilai pengganti dihitung hanya dari distribusi kolom itu sendiri (tanpa memakai kolom lain).
| Teknik | Contoh pemakaian | Catatan |
|---|---|---|
| Mean | Variabel simetris, outlier jarang | Mudah terpengaruh outlier |
| Median | Skew / ada pencilan | Lebih robust untuk numerik |
| Modus | Variabel kategorik | Modus bisa tidak unik |
| Konstanta | 0, "Tidak diketahui" |
Jelas secara bisnis; ubah interpretasi |
Contoh bisnis: mengisi diskon yang kosong dengan 0 jika aturan bisnis “tanpa diskon = 0”, bukan median diskon — median bisa salah makna.
Imputasi berbasis grup (stochastic / deterministik)
Maksud: mengisi missing dengan mean/median/modus per kelompok yang terdefinisi dari kolom lain (mis. median gaji per departemen).
Contoh: pola MAR — yang muda lebih sering tidak mengisi pendapatan, tetapi dalam satu rentang usia distribusi mirip; atau median penjualan per kota.
Lebih selaras dengan MAR daripada satu angka global untuk seluruh dataset.
Urutan waktu: ffill, bfill, interpolate
Contoh: stok harian yang hanya diperbarui saat ada mutasi — hari tanpa entri sering “missing” padahal nilai sama seperti kemarin.
ffill(forward fill): isi dengan nilai observasi terakhir yang valid.bfill: kebalikan (nilai berikutnya).interpolate(): linear/spline antar titik — cocok untuk deret numerik dengan jarak waktu teratur.
Hati-hati: mengisi bisa menyembunyikan hari tanpa transaksi vs salah input.
KNN, regresi, dan multiple imputation
- KNNImputer (sklearn): nilai yang hilang diisi dari rata-rata tetangga terdekat di ruang fitur (perlu skala fitur yang wajar, mis. standardization).
- Regresi / model prediktif: latih model memprediksi kolom bermissing dari kolom lain; risiko overfitting jika tidak pakai validasi/pipeline.
- Multiple imputation (MICE, dll.): membuat beberapa versi dataset lengkap dengan variasi imputasi → analisis diulang → menggabungkan hasil (mengakui ketidakpastian karena missing).
Untuk tugas kuliah dasar, median global atau per grup + dokumentasi sering cukup; riset atau keputusan berisiko tinggi mendalami MICE.
Indikator missing (missingness indicator)
Menambah kolom biner, mis. pendapatan_ada = 1 jika aslinya terisi, 0 jika imputasi dari kosong.
Contoh: jika yang tidak melapor pendapatan punya perilaku berbeda, model bisa memakai sinyal “ini dulu kosong” selain nilai imputasi.
Train, test, dan reproduksibilitas
- Statistik untuk imputasi (mean/median per grup, parameter KNN, dll.) dihitung dari data latih saja, lalu diterapkan ke uji — sama seperti scaling.
- Menyimpan pipeline (mis.
sklearn.pipeline.Pipeline) menghindari kebocoran informasi dari test ke train.
Ringkasan strategi (cheat sheet)
| Strategi | Kapan dipertimbangkan |
|---|---|
| Hapus baris | Missing sedikit; asumsi MCAR masuk akal; atau baris tidak esensial |
| Hapus kolom | Mayoritas kosong / tidak dipakai |
| Mean / median / modus | Imputasi cepat; median/modus sering lebih aman untuk skew & kategorik |
| Per grup / waktu | MAR atau struktur waktu jelas |
| KNN / regresi / MICE | Butuh akurasi imputasi; sampel cukup besar |
| Indikator | Pola missing mungkin informatif |
Contoh: dataset dengan missing
Contoh: dataset dengan missing
| id | usia | pendapatan | kota | |
|---|---|---|---|---|
| 0 | 1 | 57 | 6.310844 | Z |
| 1 | 2 | 45 | 8.507847 | Y |
| 2 | 3 | 47 | 6.841731 | Z |
| 3 | 4 | 56 | NaN | X |
| 4 | 5 | 43 | 5.032014 | X |
| 5 | 6 | 51 | 6.551746 | X |
| 6 | 7 | 53 | 7.509510 | X |
| 7 | 8 | 30 | 10.246910 | X |
Contoh penanganan missing di Pandas
missing_pct = df["pendapatan"].isna().mean() * 100
print(f"Proporsi missing 'pendapatan': {missing_pct:.1f}%")

# 1) Listwise pada kolom yang dipakai
n_after_drop = df.dropna(subset=["pendapatan"]).shape[0]
print(f"Baris setelah dropna(subset=['pendapatan']): {n_after_drop} (dari {len(df)})")

# 2) Imputasi median global
med_global = df["pendapatan"].median()
df_med = df.assign(pendapatan_med=df["pendapatan"].fillna(med_global))

# 3) Imputasi median per kota (contoh MAR-ish: grup berbeda)
df_grp = df.assign(
    pendapatan_perkota=df["pendapatan"].fillna(
        df.groupby("kota")["pendapatan"].transform("median")
    )
)

# 4) Indikator + imputasi (model bisa pakai kedua sinyal)
df_ind = df.assign(
    pendapatan_miss=df["pendapatan"].isna().astype(int),
    pendapatan_filled=df["pendapatan"].fillna(med_global),
)

# 5) Sentinel -> NaN (ilustrasi; sering dilakukan saat load data)
raw = pd.Series([5.0, -999.0, 8.0])  # -999 = "belum diisi" di sistem lama
bersih = raw.replace(-999.0, np.nan)
print("Contoh sentinel:", raw.tolist(), "->", bersih.tolist())

df_ind[["kota", "pendapatan", "pendapatan_miss", "pendapatan_filled"]].head(8)
Catatan: median untuk fillna di atas dihitung dari seluruh df di contoh; saat pemodelan, gunakan statistik dari split latih saja, lalu terapkan ke validasi/uji (pipeline).
Contoh penanganan missing di Pandas
Proporsi missing 'pendapatan': 15.0%
Baris setelah dropna(subset=['pendapatan']): 102 (dari 120)
Contoh sentinel: [5.0, -999.0, 8.0] -> [5.0, nan, 8.0]| kota | pendapatan | pendapatan_miss | pendapatan_filled | |
|---|---|---|---|---|
| 0 | Z | 6.310844 | 0 | 6.310844 |
| 1 | Y | 8.507847 | 0 | 8.507847 |
| 2 | Z | 6.841731 | 0 | 6.841731 |
| 3 | X | NaN | 1 | 7.495982 |
| 4 | X | 5.032014 | 0 | 5.032014 |
| 5 | X | 6.551746 | 0 | 6.551746 |
| 6 | X | 7.509510 | 0 | 7.509510 |
| 7 | X | 10.246910 | 0 | 10.246910 |
Data pencilan (outliers)
Outlier = observasi yang jauh dari sebagian besar data — bisa akibat kesalahan ukur/entri, variabilitas alami, atau kejadian langka yang valid.
Tujuan deteksi: memutuskan koreksi, penjagaan dengan penanganan khusus, atau analisis terpisah — bukan otomatis menghapus tanpa konteks.
Deteksi: boxplot & IQR
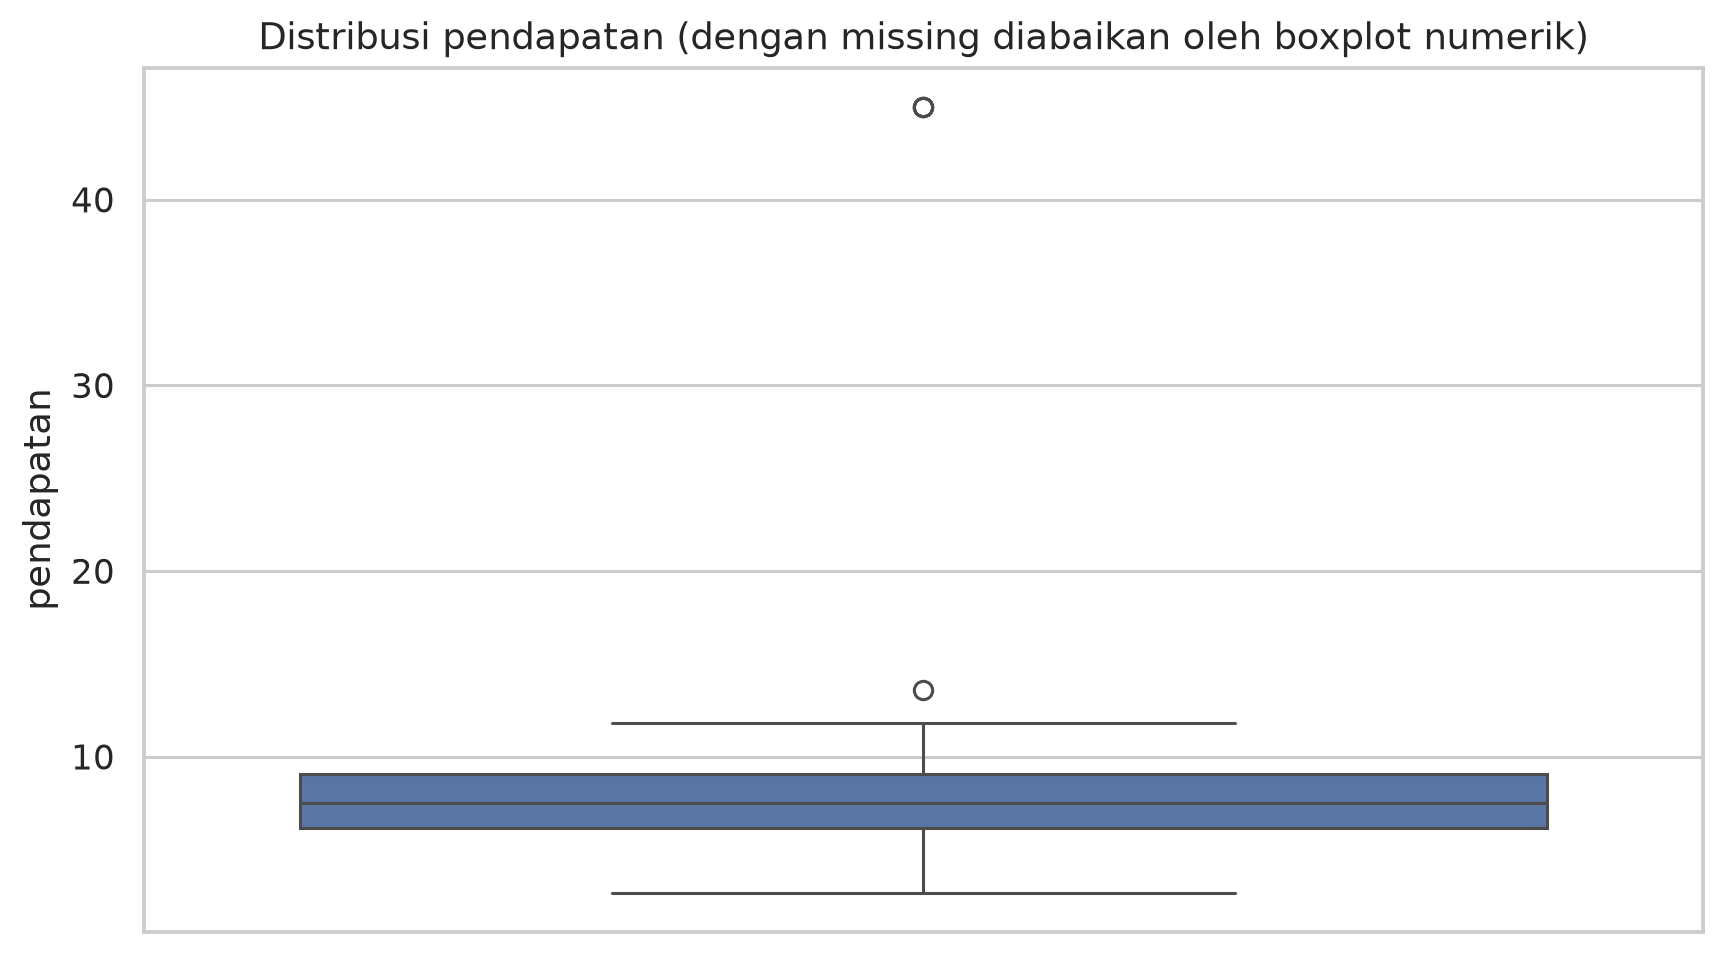
Boxplot memakai kuartil: Q1, Q3, IQR = Q3 − Q1.
Aturan IQR umum (tukey): pencilan bawah < Q1 − 1.5×IQR, pencilan atas > Q3 + 1.5×IQR.
Metode ini bersifat heuristik, bukan “kebenaran mutlak”; selalu bandingkan dengan domain.
Boxplot contoh
import matplotlib

matplotlib.use("module://matplotlib_inline.backend_inline")

import matplotlib.pyplot as plt
import seaborn as sns

sns.set_theme(style="whitegrid", context="notebook")
plt.rcParams["figure.dpi"] = 110

fig, ax = plt.subplots(figsize=(8, 4.5))
sns.boxplot(data=df, y="pendapatan", ax=ax)
ax.set_title("Distribusi pendapatan (dengan missing diabaikan oleh boxplot numerik)")
plt.tight_layout()
plt.show()
Untuk boxplot, pastikan NaN ditangani (dropna pada kolom) agar plot valid.
Boxplot contoh
IQR di Pandas (contoh)
# Kode ringkas: keluaran teks di samping kode (dua kolom).
s = df["pendapatan"].dropna()
q1, q3 = s.quantile(0.25), s.quantile(0.75)
iqr = q3 - q1
low, high = q1 - 1.5 * iqr, q3 + 1.5 * iqr
mask_out = (s < low) | (s > high)
print("Batas IQR:", round(low, 2), "-", round(high, 2))
print("Jumlah outlier (heuristik):", int(mask_out.sum()))
Batas IQR: 1.77 - 13.47
Jumlah outlier (heuristik): 4Z-score (ringkas)
\(z_i = (x_i - \mu) / \sigma\) — nilai dengan \(|z|\) besar (mis. > 3) kadang ditandai outlier.
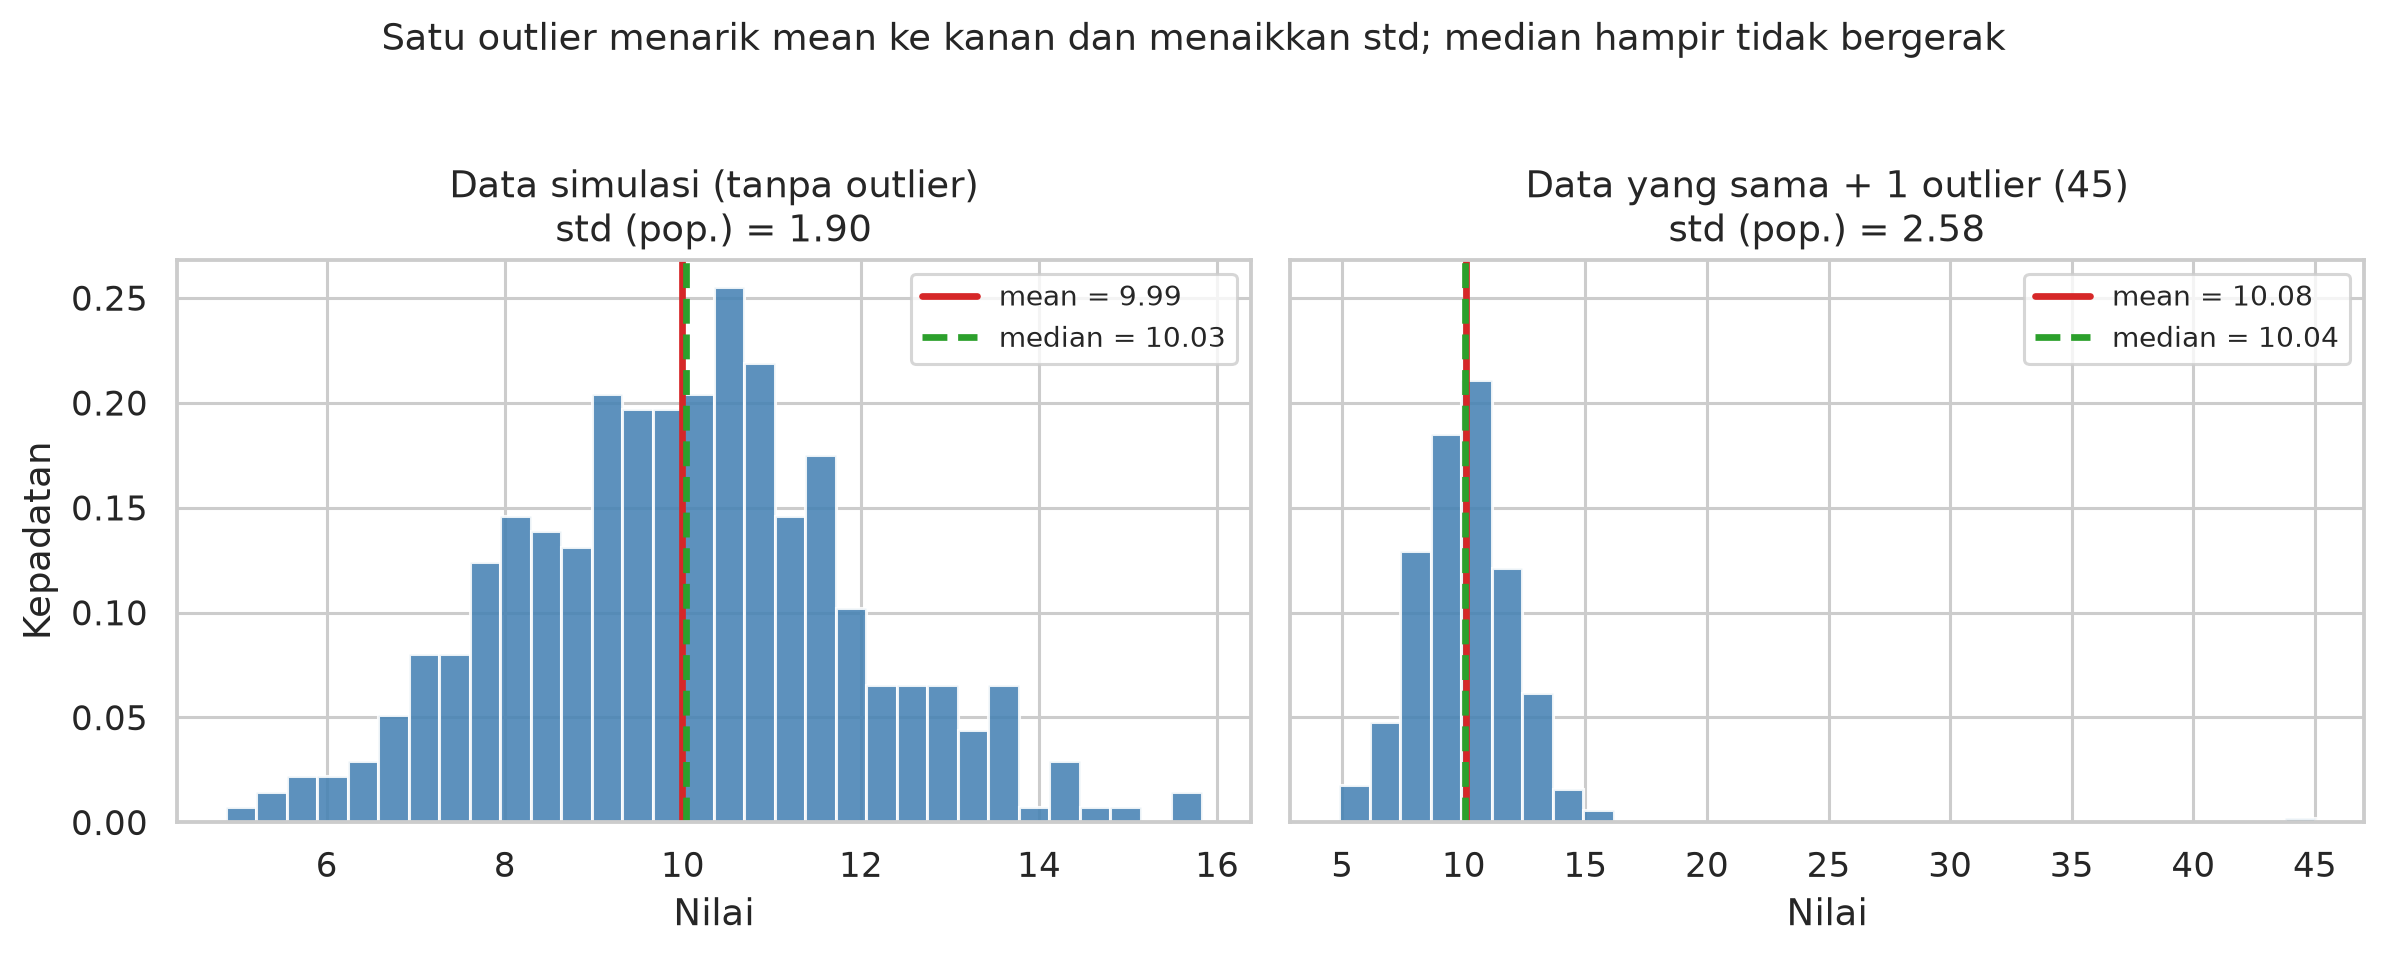
Kelemahan: mean (\(\mu\)) dan simpangan baku (\(\sigma\)) dihitung dari data yang sama; satu nilai ekstrem menarik \(\mu\) dan membengkakkan \(\sigma\), sehingga z-score lain bisa terlihat “normal” dan pencilan sulit terpisah → sering dipakai MAD / modified z atau IQR untuk EDA.
Visual: mean & std rentan outlier (median lebih stabil)
import matplotlib

matplotlib.use("module://matplotlib_inline.backend_inline")

import matplotlib.pyplot as plt
import numpy as np

rng = np.random.default_rng(42)
x = rng.normal(loc=10.0, scale=2.0, size=400)
x_out = np.append(x, 45.0)

fig, axes = plt.subplots(1, 2, figsize=(11, 4.2), sharey=True, dpi=110)

for ax, data, judul in [
    (axes[0], x, "Data simulasi (tanpa outlier)"),
    (axes[1], x_out, "Data yang sama + 1 outlier (45)"),
]:
    ax.hist(data, bins=32, color="steelblue", edgecolor="white", alpha=0.88, density=True)
    mu = float(np.mean(data))
    sig = float(np.std(data, ddof=0))
    med = float(np.median(data))
    ax.axvline(mu, color="tab:red", lw=2.2, label=f"mean = {mu:.2f}")
    ax.axvline(med, color="tab:green", lw=2.2, ls="--", label=f"median = {med:.2f}")
    ax.set_title(f"{judul}\nstd (pop.) = {sig:.2f}")
    ax.set_xlabel("Nilai")
    ax.legend(loc="upper right", fontsize=9)

axes[0].set_ylabel("Kepadatan")
fig.suptitle(
    "Satu outlier menarik mean ke kanan dan menaikkan std; median hampir tidak bergerak",
    fontsize=12,
    y=1.03,
)
plt.tight_layout()
plt.show()
Visual: mean & std rentan outlier (median lebih stabil)
Penanganan outlier — urutan berpikir
- Deteksi (IQR, plot, domain) → tandai kandidat pencilan.
- Verifikasi: salah input, satuan, duplikat, atau kejadian valid?
- Putuskan tindakan yang selaras tujuan analisis (laporan vs model prediktif) dan etika (jangan sembunyikan data penting).
- Dokumentasikan metode, ambang, dan dampak pada N/distribusi.
Tidak ada satu jawaban “benar” untuk semua proyek; yang wajib adalah konsistensi dan alasan yang bisa diperiksa.
Verifikasi sumber & pengetahuan domain
Selalu tanya dulu: pencilan ini error atau signal?
- Error: salah ketik (titik/koma), salah satuan (meter vs sentimeter), dobel entri, bug ETL → idealnya koreksi ke nilai benar atau hapus baris jika tidak bisa diperbaiki.
- Valid tapi ekstrem: fraud besar, satu pasien sangat lama di RS, flash sale — jangan dihapus sembarangan jika menjadi inti cerita; mungkin analisis terpisah atau segmentasi.
Catat siapa yang memutuskan (analisis + ahli domain) bila keputusan berisiko.
Biarkan, laporkan, atau pisahkan analisis
- Biarkan: pencilan memang valid dan Anda ingin mempertahankan variabilitas (mis. risiko ekstrem di risk modeling).
- Laporkan secara eksplisit: di teks/lampiran, sebut berapa pencilan, di variabel mana, dan apakah mempengaruhi agregat utama.
- Analisis terpisah: jalankan model/plot dengan dan tanpa subset pencilan (sensitivitas); bandingkan koefisien atau KPI.
Cocok saat khawatir MNAR atau dampak besar satu titik data.
Koreksi nilai (bukan menghapus observasi)
Jika sumber mengonfirmasi nilai benar (mis. seharusnya 120 bukan 1200):
- Ganti di dataset kerja dan catat di log pembersihan (baris/kolom, nilai lama → baru).
- Jika hanya tahu “salah” tanpa nilai pengganti: pertimbangkan missing + imputasi/regulasi, atau hapus dengan dokumentasi.
Bedakan koreksi faktual dari winsorize (memang membatasi ekstrem yang dianggap terlalu berpengaruh secara statistik).
Winsorize & capping
Winsorize: nilai di bawah persentil bawah (mis. P1) diganti ke P1; di atas P99 diganti ke P99 — jumlah baris tetap, ekor distribusi “dipotong”.
Cap / batas keras: mis. pendapatan tidak boleh melebihi plafon aturan internal; atau umur dibatasi [0, 120] untuk konsistensi logis.
Kapan dipakai: mengurangi pengaruh ekstrem pada regresi/OLS, stabilisasi training, tetap ingin semua baris ikut.
Risiko: mengubah makna ekonomi/statistik; persentil harus dari data latih (atau kebijakan tetap), lalu diterapkan sama ke uji.
# Ilustrasi winsorize 1%–99% pada kolom yang sama dengan contoh IQR (bukan rekomendasi final proyek).
s = df["pendapatan"].dropna()
low, high = s.quantile([0.01, 0.99])
s_win = s.clip(lower=low, upper=high)
n_clipped = int((s != s_win).sum())
print(f"P1={low:.3f}, P99={high:.3f}")
print(f"Banyak nilai yang di-clip: {n_clipped} / {len(s)}")
print("Contoh sebelum → sesudah (yang berubah saja):")
ubah = pd.DataFrame({"sebelum": s, "sesudah": s_win})
print(ubah[ubah["sebelum"] != ubah["sesudah"]].head(6).to_string())
Winsorize & capping
P1=3.006, P99=45.000
Banyak nilai yang di-clip: 2 / 102
Contoh sebelum → sesudah (yang berubah saja):
     sebelum   sesudah
64  3.005634  3.005767
67  2.678582  3.005767
Transformasi variabel
Tujuan: kurangi asimetri dan tarik ekor panjang sehingga pencilan relatif tidak mendominasi skala asli.
log/log1p: untuk data positif (harga, pendapatan);log1pcocok jika ada nol.sqrt: alternatif ringan untuk skew moderat.- Standarisasi (z) / robust scaling: setelah outlier ditangani atau untuk algoritme yang sensitif skala — ingat z klasik tidak robust (slide sebelumnya).
Transformasi mengubah interpretasi koefisien; laporkan skala yang dipakai.
Pendekatan berbasis model
- Model robust: regresi robust, tree-based (pohon keputusan, random forest, gradient boosting) sering kurang sensitif terhadap pencilan di fitur dibanding OLS murni.
- Regularisasi (Ridge/Lasso): mengurangi varians; bukan pengganti deteksi error.
- Algoritme khusus: isolation forest untuk deteksi anomaly; bedakan training untuk deteksi vs eksplorasi deskriptif.
Pilih alat yang sesuai: kadang lebih baik mempertahankan data + model robust daripada memaksa distribusi “bersih”.
Menghapus baris (drop observasi)
Pertimbangkan hapus jika: pencilan jelas error dan tidak bisa dikoreksi; atau kebijakan analisis mensyaratkan populasi homogen (dokumentasikan).
Risiko: bias seleksi (sampel mengecil, populasi berubah), kehilangan kejadian penting, dan MNAR tersamar.
Hapus biasanya opsi terakhir setelah verifikasi domain; selalu sebut N sebelum / sesudah.
Ringkasan tindakan (cheat sheet)
| Tindakan | Kapan dipertimbangkan | Catatan |
|---|---|---|
| Verifikasi & koreksi | Salah ketik, satuan, duplikat | Nilai benar dari sumber |
| Biarkan + lapor | Ekstrem valid, inti analisis | Sensitivitas, transparansi |
| Winsorize / cap | Stabilkan model, jaga N | Persentil/plafon dari train / kebijakan |
| Transformasi | Skew berat, ekor panjang | Interpretasi berubah |
| Model robust | Banyak pencilan valid | Kurangi sensitivitas OLS |
| Hapus baris | Error tak terperbaiki | Dokumentasikan bias & N |
Alur integratif (ringkas)
- Pilih baris & kolom sesuai pertanyaan dan kebijakan.
- Audit missing, duplikat, tipe data, kode khusus.
- Putuskan imputasi/penghapusan dengan asumsi yang jelas.
- Deteksi outlier (IQR/plot), validasi dengan domain.
- Dokumentasikan dalam notebook/laporan untuk reproduksibilitas (lihat slide berikut).
Dokumentasi: mengapa penting?
Tanpa catatan tertulis, orang lain (atau Anda sendiri bulan depan) tidak bisa menjawab:
- Berapa proporsi missing per variabel sebelum dibersihkan?
- Imputasi memakai statistik dari mana (seluruh data, train saja, per grup)?
- Outlier ditandai dengan metode & ambang apa, lalu diapakan (biarkan, cap, hapus)?
Tujuan: reproduksibilitas, audit, dan kepatuhan (skripsi, laporan proyek, tim data). Dokumentasi idealnya versi + tanggal + versi dataset (hash/nama berkas).
Dokumentasi missing — isi minimum
Untuk setiap kolom yang punya missing (atau sentinel yang dinormalisasi), catat:
- Nama kolom dan definisi singkat.
- Proporsi / jumlah missing sebelum tindakan.
- Sumber/pola jika diketahui (sensor, formulir opsional, kode
-999, dll.). - Tindakan: hapus baris, hapus kolom,
fillna(median/mean/modus/konstanta/grup), indikator, dll. - Parameter: contoh “median dihitung dari split train”, “per
kota”, “konstanta 0”. - Dampak: jumlah baris/kolom setelah tindakan.
Dokumentasi outlier — isi minimum
Untuk setiap variabel yang dicek pencilan:
- Metode deteksi: IQR 1,5×, boxplot, z-score, domain, dll.
- Ambang / aturan secara eksplisit (angka atau rumus).
- Banyaknya observasi terflag (dan contoh ID/bar jika relevan).
- Keputusan: tidak diubah, dikoreksi ke sumber, winsorize ke persentil P99, dihapus, dianalisis terpisah.
- Alasan singkat (termasuk konsultasi domain jika ada).
Contoh format — kerangka log pembersihan
Isi template di bawah di Markdown notebook atau lampiran laporan (salin dan lengkapi):
================================================================================
LOG PEMBERSIHAN DATA
Proyek / mata kuliah : .................................
Versi dataset        : ................................  (nama berkas / hash)
Tanggal              : ................................
Penulis              : ................................
================================================================================

A. MISSING VALUES
   Kolom      | % missing (n/N) | Tindakan        | Parameter / aturan
   -----------|-----------------|-----------------|----------------------------
   (isi baris per kolom)

B. OUTLIER
   Kolom      | Metode deteksi  | Ambang          | Tindakan | Baris terdampak
   -----------|-----------------|-----------------|----------|----------------
   (isi baris per variabel)

C. CATATAN
   - Asumsi pola missing (MCAR/MAR/MNAR): ......................................
   - Imputasi: statistik dari TRAIN saja? [ ] ya  [ ] tidak — jelaskan: .....
   - Perubahan jumlah baris: N_awal = ...  →  N_akhir = ...
================================================================================
Contoh format — contoh terisi
LOG PEMBERSIHAN DATA
Proyek: EDA penjualan Q1
Dataset: penjualan_q1_2025.csv (SHA256 ringkas: ab12…)
Tanggal: 2026-04-10   Penulis: A. Mahasiswa

A. MISSING VALUES
   diskon_pct | 8% (96/1200) | sentinel -1 → NaN lalu fillna(0) | diskon kosong = 0
   berat_kg   | 3% (36/1200) | median per kategori_produk       | median dari TRAIN

B. OUTLIER
   harga      | IQR 1,5×     | [Q1-1.5IQR, Q3+1.5IQR] | winsor ke P1–P99 | 14 baris
   usia       | domain       | usia < 18 atau > 80    | hapus baris      | 2 baris

C. CATATAN
   Asumsi missing diskon: MAR (produk tertentu jarang diisi).
   Imputasi dari train split random_state=42.
   N_awal = 1200 → N_akhir = 1196 (2 hapus usia + 2 duplikat order_id, dijelaskan di bagian lain).
Ringkasan
- Pemilihan objek data = filter rekaman dan atribut agar selaras dengan tujuan, tanpa kebocoran label dan dengan dokumentasi keputusan.
- Pembersihan = tangani missing (deteksi, strategi imputasi/hapus) dan outlier (visual + IQR/heuristik, lalu tindakan berbasis domain).
- Pandas menyediakan alat dasar; keputusan harus terjelaskan dan konsisten antara latih/uji saat pemodelan.
- Dokumentasikan missing & outlier dalam log atau tabel (angka sebelum/sesudah, aturan, parameter, dampak N).
Bacaan
- Wickham & Grolemund — R for Data Science (bab tidyr relevan untuk konsep tidy; ide serupa di ekosistem Python).
- Dokumentasi: pandas — missing data, pandas — duplicated.
- McKinney — Python for Data Analysis (Pandas).
MK Data Science 06 - Anggit Wirasto